

点击蓝字
关注我们
AI TIME 欢迎每一位 AI 爱好者的加入!
从 Transformer 到新序列建模架构,大模型正加速向视觉融合、长视频生成及世界交互等复杂场景演进。然而,长序列效率瓶颈、视觉信息处理黑盒、复杂推理能力及生成一致性等问题依然亟待突破。
10月26日,AI TIME「大模型架构与多模态生成」专场将邀请来自清华大学、香港大学、哈尔滨工业大学(深圳)、华南理工大学和北京大学的五位青年研究者,围绕基础架构、多模态融合、复杂推理、高效生成及世界交互展开前沿分享与 Debate 讨论。
活动信息
- 活动主题:AI前沿青年讲者计划 · 大模型架构与多模态生成专场
- 活动形式:研究分享 + Debate 讨论 | 线上直播,无需报名
- 活动时间:10月26日(周一)14:00
嘉宾与报告信息
韩东辰:高效序列建模范式探索
讲者简介:清华大学博士生,主要研究基础模型架构、多模态大模型及持续学习。以一作或共同一作在 CVPR、NeurIPS、ICML 等发表论文10篇,入选 CVPR 2026 Best Paper Finalists。
报告简介:针对 Transformer 平方计算复杂度瓶颈,探讨线性注意力与 Test-Time Training 等高效序列建模方案,分析序列建模演进对基础模型 Scaling 性质的影响。

范英祺:从视觉表征到跨模态融合
讲者简介:香港大学博士生,聚焦多模态大语言模型可解释性与高效计算,成果发表于 CVPR、ICLR、EMNLP 等国际会议。
报告简介:深入解析多模态大模型内部视觉处理机制,涵盖跨模态信息流动、视觉 Token 表征演化及视觉语义对齐,揭示模型如何理解与融合视觉信息。
朱颖杰:结构与内容解耦驱动的高效多模态表格理解
讲者简介:哈尔滨工业大学(深圳)与鹏城实验室联培博士生,获 ACL 2024 杰出论文奖,成果入选 ICML 2026 Spotlight。
报告简介:针对表格结构复杂导致的推理难题,介绍 DiSCo 及 Table-GLS 方法,通过解耦表格结构与语义信息、全局到局部的结构探索,提升多模态表格理解与推理性能。
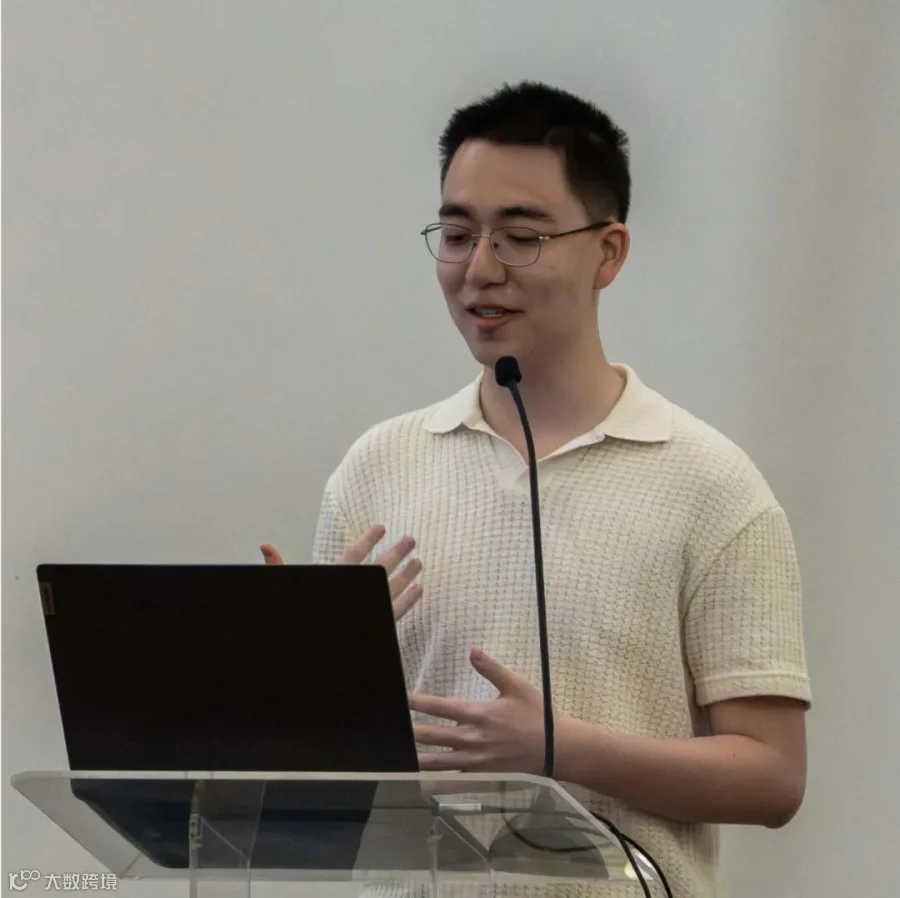
郑世康:扩散模型与视频生成的高效推理探索
讲者简介:华南理工大学本科生,以第一作者在 ICLR、ICML、NeurIPS 发表多篇论文,入选 ICLR 2026 Oral。
报告简介:针对扩散模型高昂的推理成本,探讨步数蒸馏、特征缓存及自适应时空计算等加速方法,动态分配计算资源以挖掘生成过程中的冗余,实现高效视频生成。

刘恺骐:从视听生成到世界交互
讲者简介:北京大学博士生,代表工作 MAVIN 入选 ECCV 2026 Oral,研究成果发表于 ECCV、ICCV、CVPR 等。
报告简介:聚焦音视频生成的叙事控制、音画同步与长时一致性挑战。结合 MAVIN 与 StreamAV-Bench,探讨定制化多镜头生成方法及迈向交互式世界模型的机遇。
拟讨论话题
| 序号 | 话题 |
| 话题一 | 自回归“下一个 Token 预测”的统治还剩几年? |
| 话题二 | 理解和生成,要不要交给同一个模型? |
| 话题三 | 模型能力的未来,是“训出来的”还是“蒸出来的”? |
| 话题四 | 生成模型如何更好地保持物理一致性? |
观看方式
01 B站直播
哔哩哔哩直播通道
02 微信视频号直播
点击预约按钮接收直播提醒
关于 AI TIME
AI TIME 源起于 2019 年,旨在发扬科学思辨精神,邀请各界人士对人工智能理论、算法和场景应用的本质问题进行探索,加强思想碰撞,链接全球 AI 学者、行业专家和爱好者。
迄今为止,AI TIME 已邀请 2000 多位海内外讲者,举办逾 800 场活动,累计观看超 2000 万人次。

点击 阅读原文 进入直播间