允中 发自 凹非寺
量子位 | 公众号QbitAI
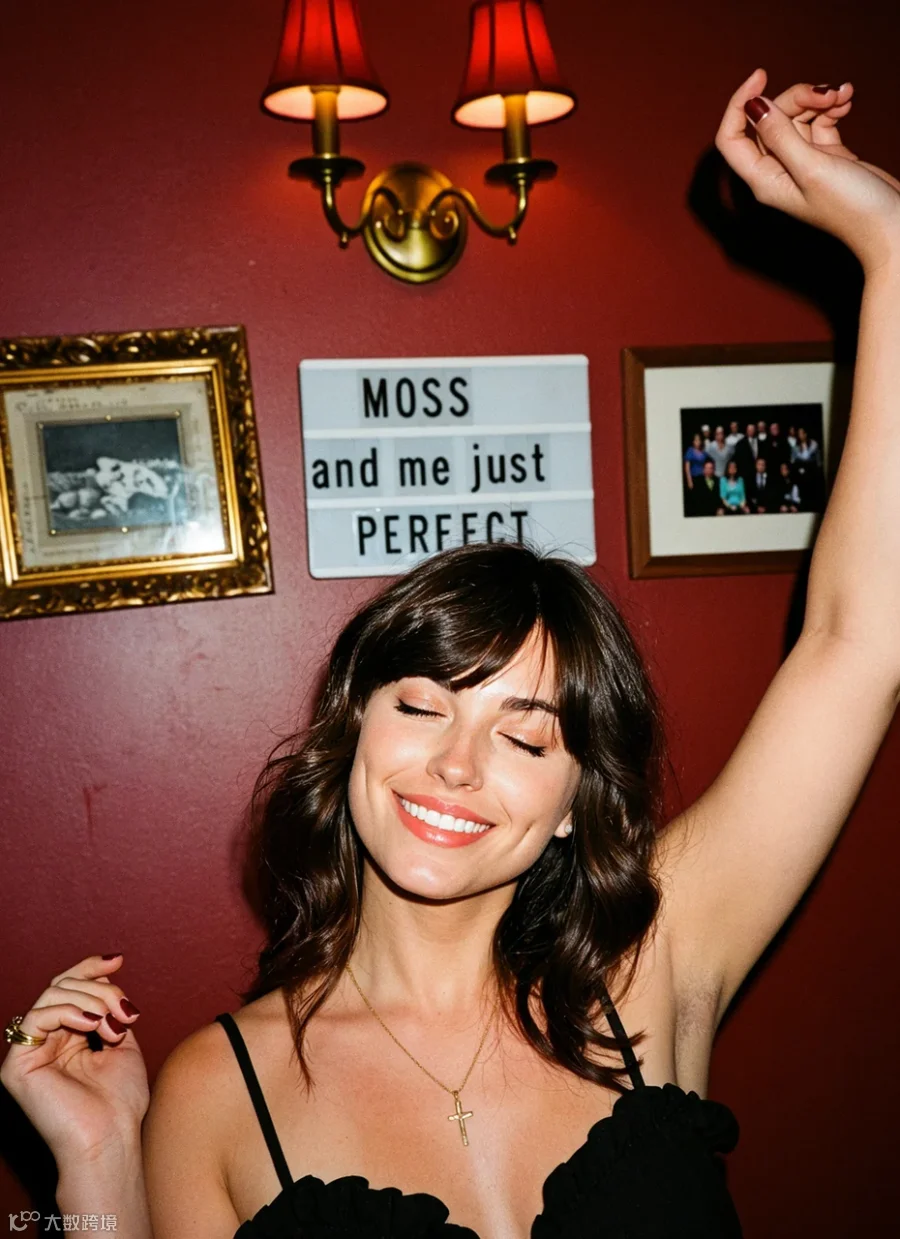
随着AI生图技术日益成熟,画面过度精致、光影失真及构图同质化等“AI味”问题逐渐凸显。近日,一款由中国团队开源的生图模型MOSS-Image因画面自然感在海外社区引发热议。ComfyUI知名开发者Ostris指出,该模型通过在训练数据中剔除AI生成图像,有效避免了模型输出趋同的问题。

这款由模思智能和OpenMOSS团队联合开源的MOSS-Image,上线仅4天便在Hugging Face Comfy-Org仓库等平台收获130万次下载,GitHub Stars突破1.4k,并迅速登顶Hugging Face文生图趋势榜,跻身全类别模型前列。
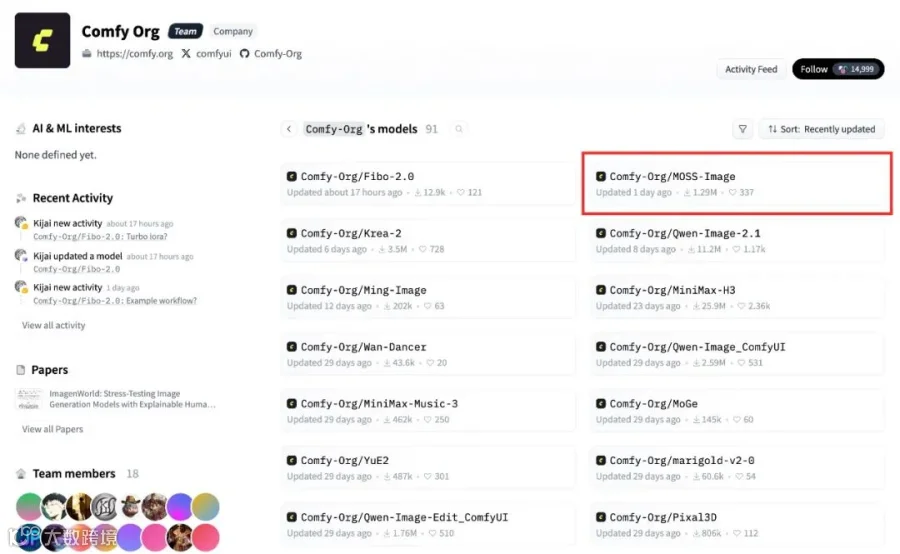
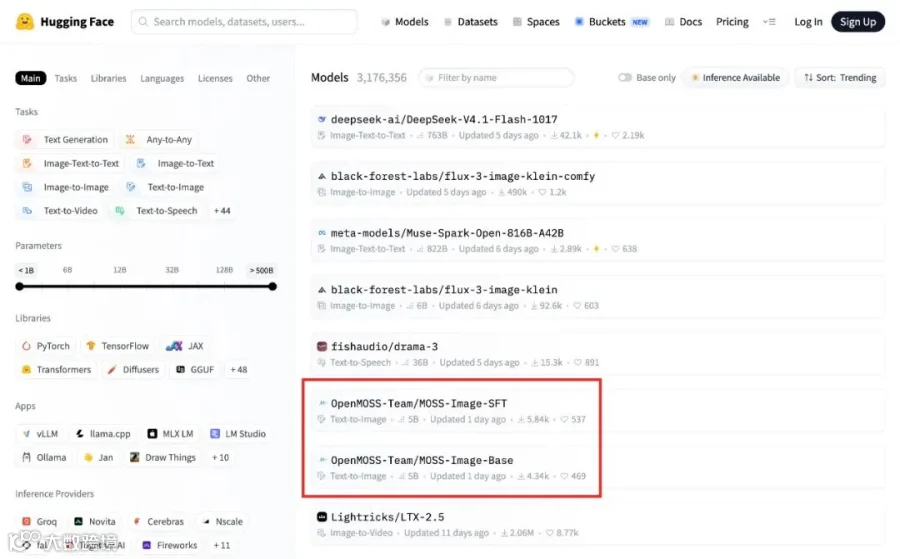
△Hugging Face全模型Trending榜

△Hugging Face文生图模型Trending榜
发布后,开发者社区迅速响应,衍生出8步/4步加速版、INT8量化版、GGUF版及各类风格LoRA。在X、Reddit等平台,MOSS-Image被频繁与FLUX.3-klein、Krea2、Qwen Image 2.1等模型进行对比测试,涵盖画面风格、人物细节、文字渲染及复杂构图等多个维度。
海外社区热议:多维度实测对标主流模型
除画面自然度外,海外开发者重点测试了MOSS-Image的人物姿态、细节表现及风格一致性。从动漫插画到照片级写实,其风格多样性获得广泛验证。

△图源:Reddit@Ok-Option-6683

△图源:Reddit@NoMouse9610

|
|
|
|
|

|

|
|
|
|

此外,日文渲染、复杂构图及长提示词遵循等测试也获得积极反馈。在Reddit r/StableDiffusion板块,MOSS-Image成为热门话题,核心开发者AMA帖获置顶推荐,被评价为“近期表现突出的Base模型”,部分开发者将其比作新一代SDXL。

在与FLUX.3-klein、Krea2等模型的横向对比中,MOSS-Image在画面自然度、细节表现及写实质感方面获得肯定,但在特定画风稳定性上仍有提升空间。综合来看,文字渲染与布局控制是其最受关注的差异化优势。

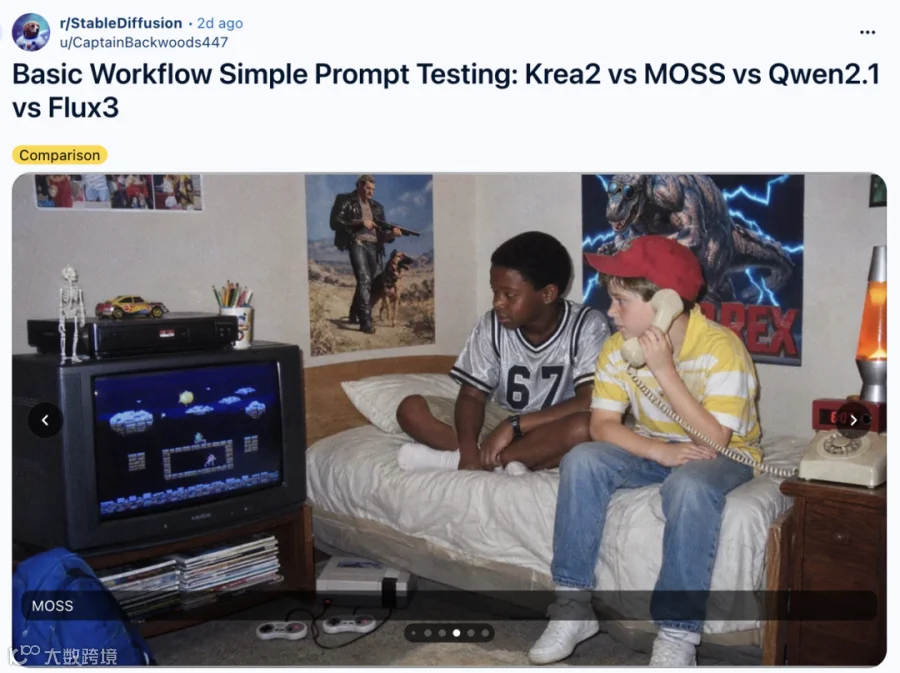
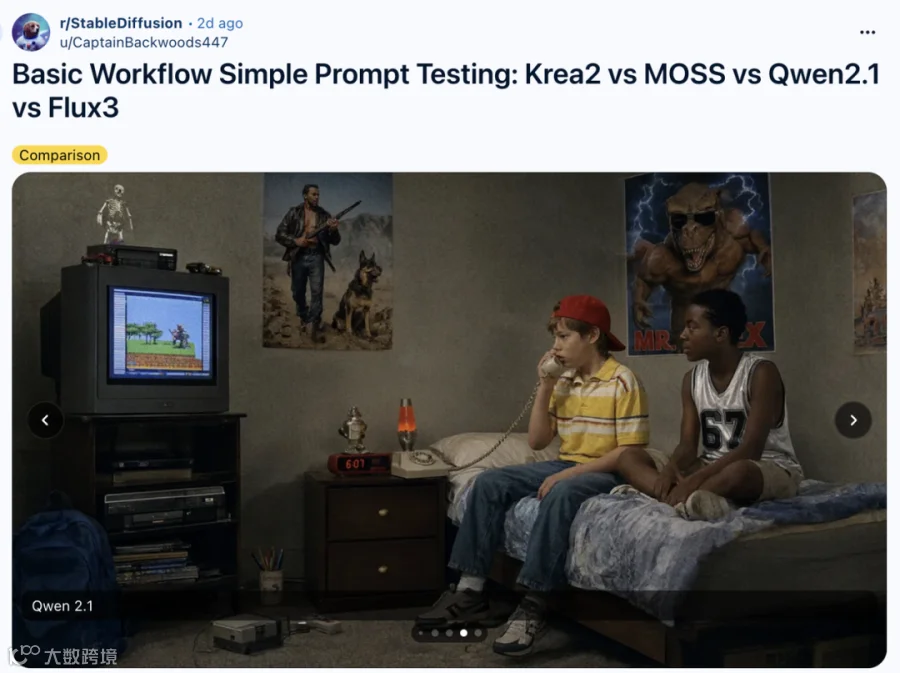

△可左右滑动查看

△截图来源:Reddit
核心技术突破:文字渲染、布局控制与长Prompt支持
针对AI生图在商业设计中常见的文字错误、排版混乱等痛点,MOSS-Image重点优化了以下三项能力:
中英文文字渲染
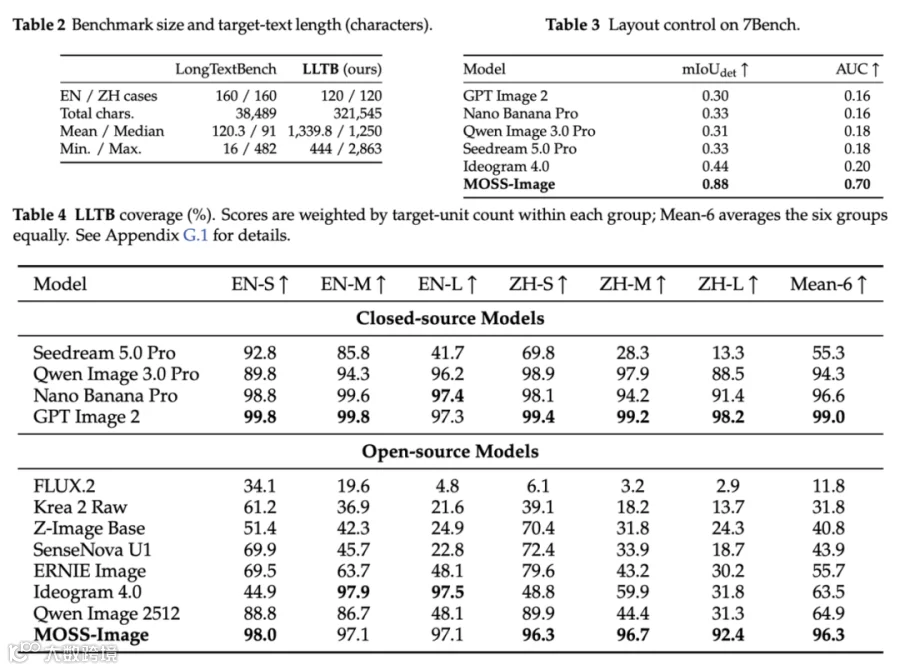
模型针对密集文本生成进行专项优化,支持长文本并保留换行结构。在Long Long Text Benchmark (LLTB)评测中,Mean-6文本覆盖率达96.3%,位列开放权重模型第一。

|

|
|
|
|
结构化Layout布局控制
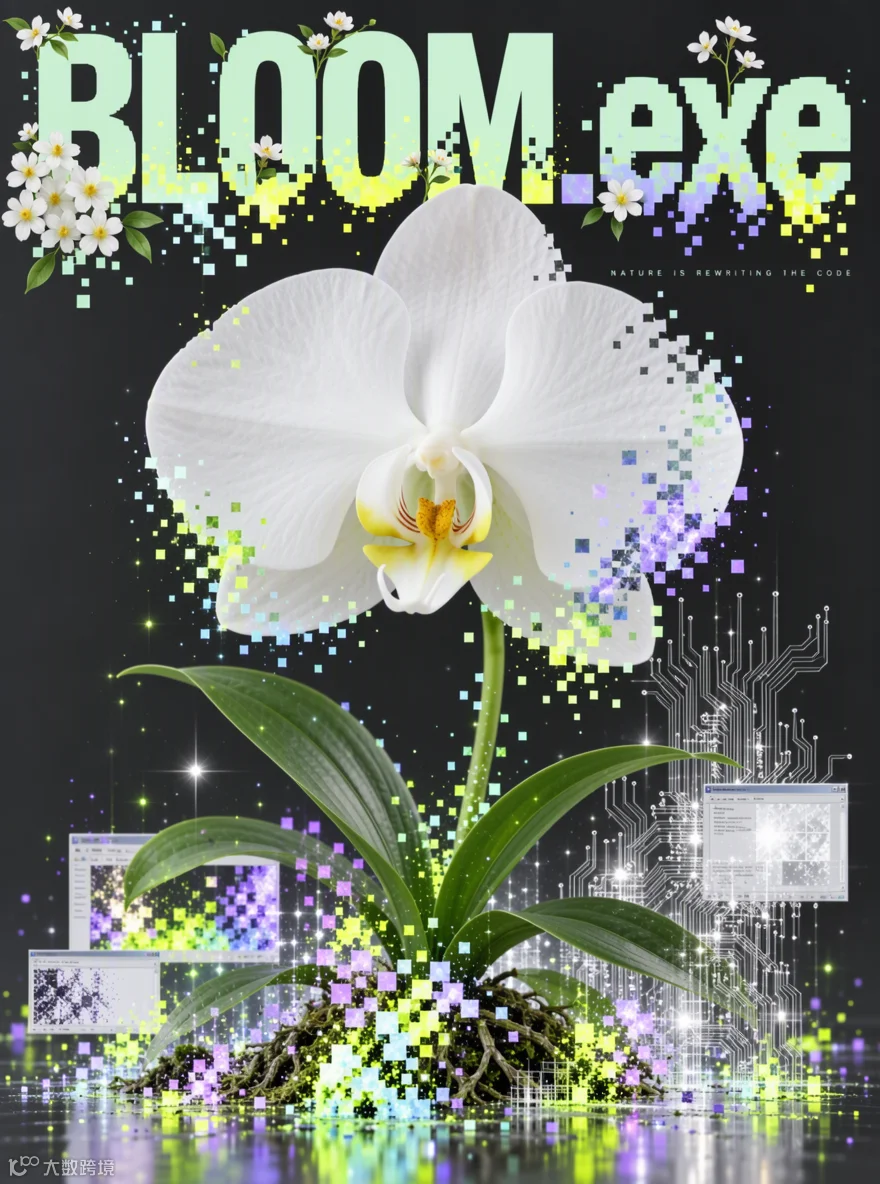
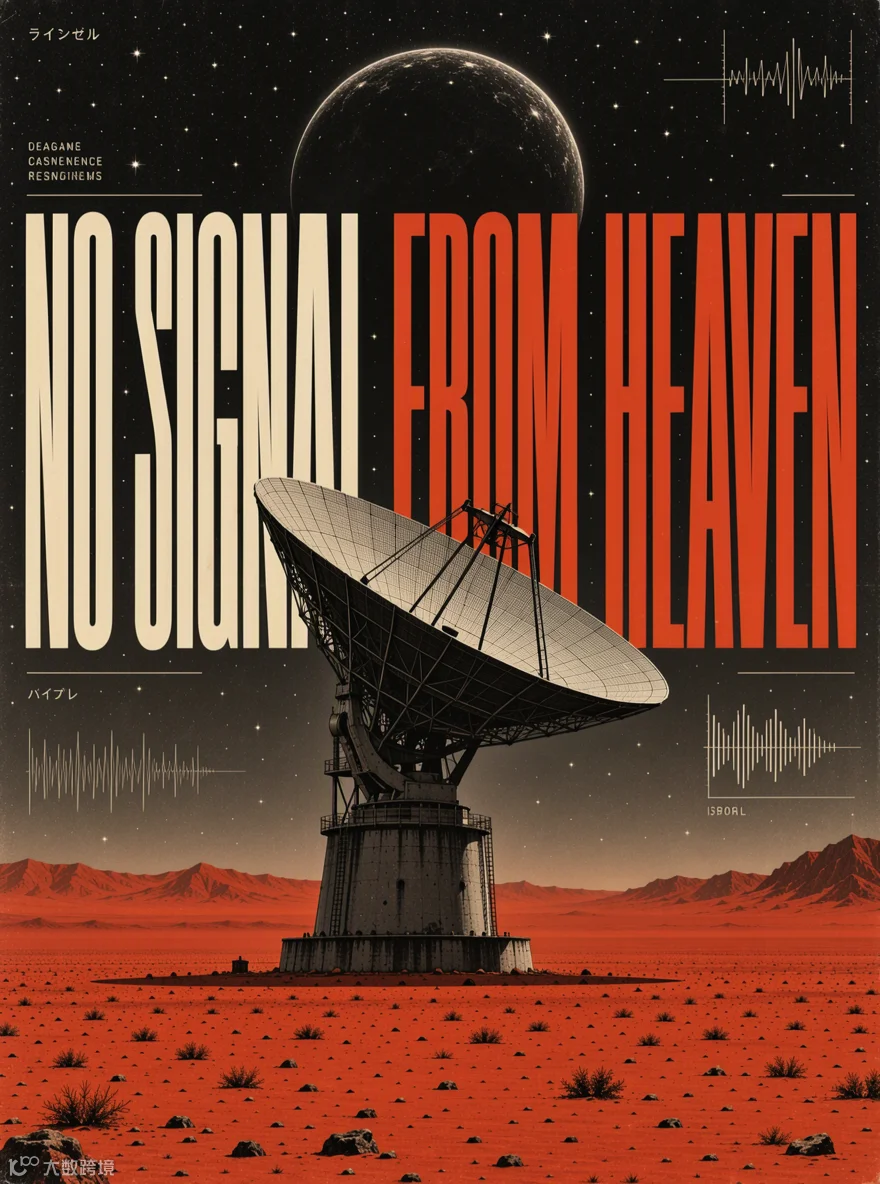
MOSS-Image引入结构化JSON Layout输入,支持通过summary描述场景、items定义元素特征、Bounding Box精确定位。在7Bench评测中,目标定位mIoU达0.88,布局AUC为0.70。

|
|
|
|
|
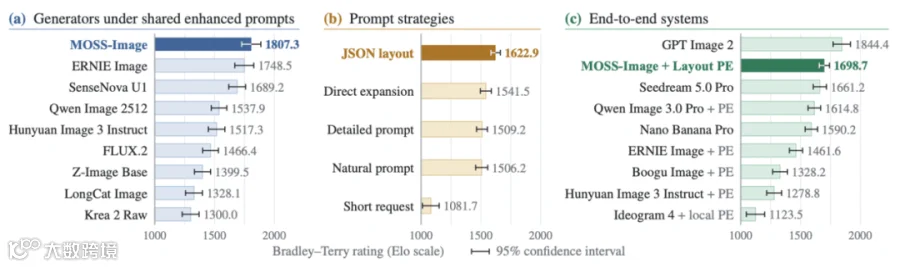
RLA真实设计盲评显示,在简短设计要求下Elo点估计达1698.70(第二);使用增强提示词时Elo达1807.34,超越ERNIE Image和SenseNova U1。
长Prompt支持与架构创新
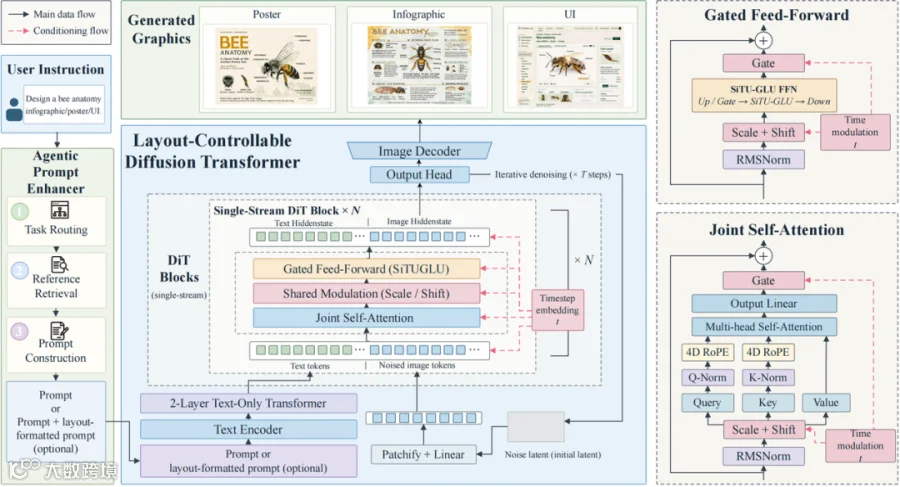
模型支持最长4096 tokens文本输入,配合Prompt Enhancer Skill可将简短创意扩展为结构化指令。技术架构采用5B参数DiT主干,结合冻结Qwen3.5-9B文本编码器与FLUX.2 VAE,实现统一生成框架。训练数据经去重筛选并剔除AI生成图像,且全程基于国产PPU算力平台训练。
生态快速成型:加速版、量化版与API同步上线
开源数日内,社区已推出8步DMD加速版(Lodestone)、4步生成版(Rapid-MOSS)及INT8/GGUF/MLX量化版本,显著降低部署门槛。手机摄影、胶片颗粒、水粉画等风格LoRA陆续涌现,SGLang、vLLM-Omni等推理框架完成适配。


|

|
|
|
|
MOSS-Image API已正式上线,支持直接集成至现有工作流;桌面端语音助手MosMos亦提供语音交互创作入口。