


让智能体(Agent)从任务经验中持续学习,是提升其处理能力的关键路径。其中,“技能—策略模型协同进化”通过将可复用的操作步骤整理为“技能库”,并与模型训练结合,形成相互促进的循环。
然而,阿里巴巴 Alibaba Token Hub (ATH) Token Foundry 团队研究发现,这种高分表现往往伴随着对特定技能库的深度依赖。当实际部署中技能库随业务需求变化时,模型可能因无法适应而表现脆弱,这一现象被称为「协同进化陷阱」。为此,团队提出了面向技能变化的可靠性评测协议 CODA。
论文链接:https://arxiv.org/pdf/2610.20845v1
从训练到部署,高分能否延续?
在技能—策略协同进化中,技能库承载可复用经验,策略模型负责调用与执行。经过多轮训练,两者相互适配,任务分数显著提升。这一过程的优势在于将单次任务经验沉淀为通用知识。
但现有评测主要关注模型在“共同训练的技能库”上的表现,忽视了另一关键问题:当技能库发生变化,模型能否保持原有表现?
实际部署中,操作流程调整、技能说明重组或版本迭代是常态,而模型重训成本高、频率低。因此,训练时高度适配的组合,在面对动态变化的技能库时,其稳定性亟待验证。
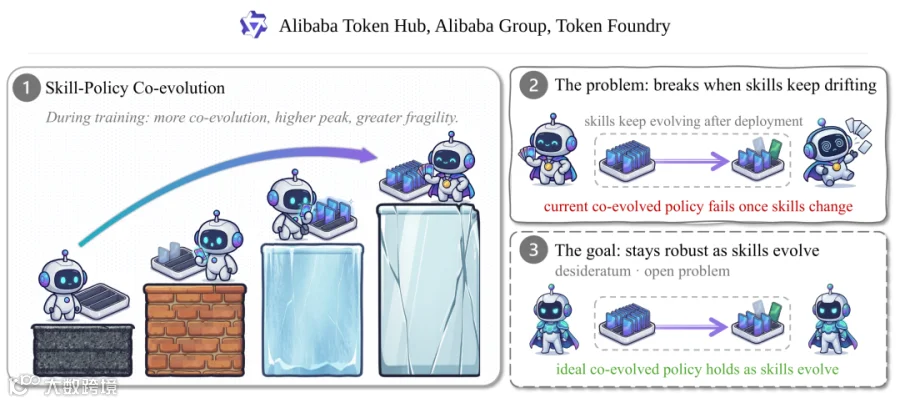
【图1:协同进化的训练过程、部署挑战与可靠性目标】
高分提升,为何可能伴随依赖加深?
研究指出,协同进化方法倾向于筛选当前模型收益最高的技能,而模型又不断适应这些特定技能。这种双向优化虽能提升单轮成绩,但也导致两者形成强耦合。
随着迭代深入,模型不仅依赖技能中的有效知识,甚至对特定版本的表达方式产生敏感性。只优化某一个技能库上的峰值,并不能自动保证技能变化后的性能稳定。“擅长使用固定技能库”与“可靠应对变化技能库”是两个需分别验证的目标。

【图2:协同进化形成高度适配组合的机制示意】
沿训练轨迹,观察被成绩曲线遮住的代价
为系统研究该问题,团队构建了五个维度的技能变化探针,模拟部署后的技能演化:
- 同义改写:保留原意,改变表达。若此时性能下降,说明模型过度依赖特定表述。
- 信息缺失:模拟不完整的指导。
- 错误策略:模拟含有误导信息的技能。
- 技能库组成变化:模拟技能结构的调整。
- 完全移除技能:测试对外部支持的依赖程度。
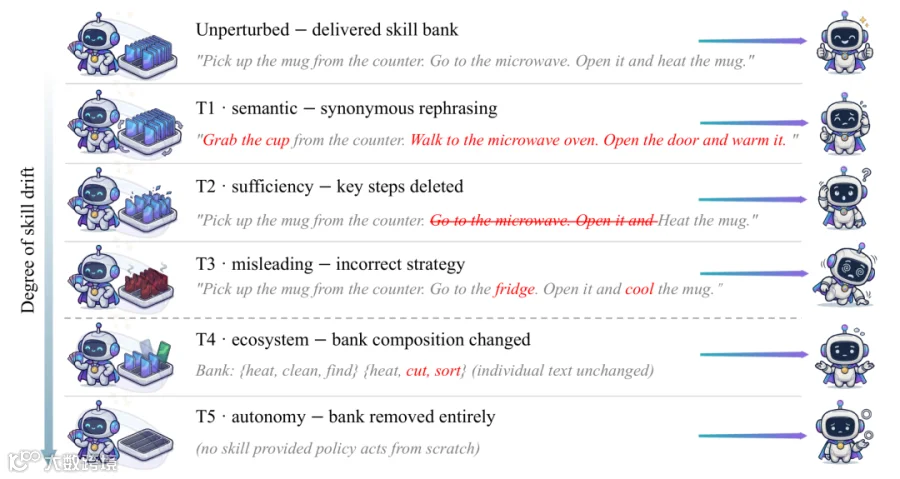
【图3:五个维度的技能变化探针】
研究进一步提出协同进化脆弱性曲线(Co-evolution Fragility Curve)。数据显示,随着原始技能库上成绩的持续提高,模型对技能变化的敏感性也在增加。这种“高分伴随高脆弱性”的现象,即为“协同进化陷阱”。这意味着,单纯上升的成绩曲线可能掩盖了泛化能力的缺失。
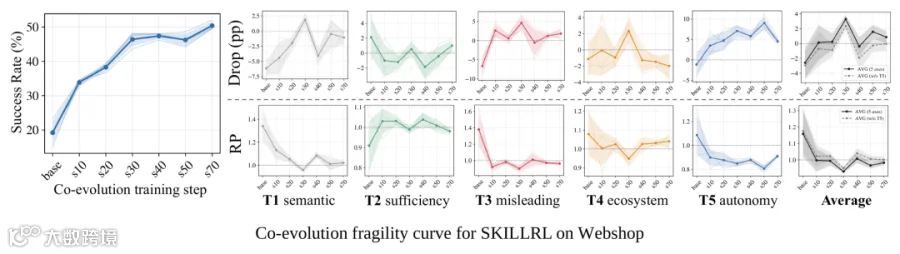
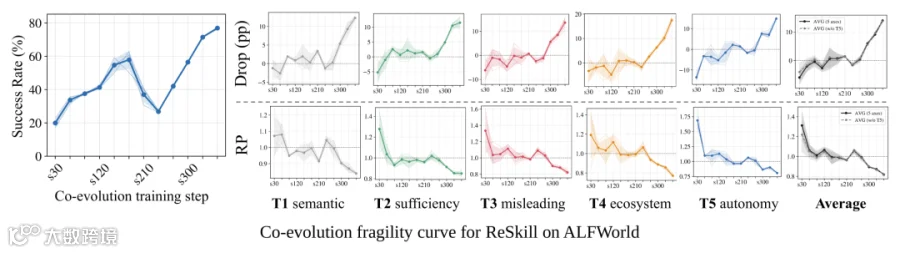

【图4:协同进化脆弱性曲线】
技能一变,多少增益还能保留?
实验覆盖 SkillRL、ReSkill、Evolving-RL 和 ARISE 四种方法及多个基准环境。结果显示:
在技能内容变化后,最差成功率比原始搭配低约 5—13 个百分点。相对于同一模型无技能基线,原始技能库带来的增益有 52%—93% 被抵消。
需注意,这里损失的是“技能库带来的额外增益”,而非模型基础能力的大幅崩塌。但这揭示了一个严峻事实:训练时展示的显著优势,在部署条件变化后难以稳定延续。
CODA 让技能变化后的可靠性变得可衡量
针对上述盲区,研究提出 CODA(CO-evolution Drift Audit,协同进化漂移审计) 评测协议,引入三个核心指标:
1. 一致率(Consistency Rate, CR)
考察技能含义不变但表达改变时,任务结果是否保持一致。它关注具体任务的稳定性,而非仅看平均分。
2. 抗干扰率(Resistance Rate, RR)
面对不完整或错误的技能,模型能否保住原本不依赖技能也能完成的任务。它衡量模型抵抗干扰的能力。
3. 最差成功率
反映在各种技能变化测试中,模型性能的最低底线。
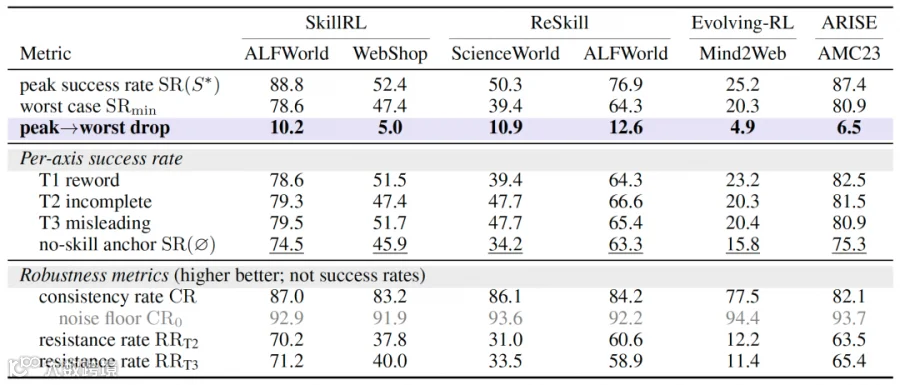
【图5:CODA评测结果与指标汇总】
结语:从峰值成绩走向持续可靠
CODA 提供了发现和衡量“协同进化陷阱”的初步方案。受控的技能变化探针让高分背后的脆弱性变得可见,表明现有方法在应对动态环境时仍有较大提升空间。
真实业务中,流程、知识和需求始终处于变化之中。我们期待的智能体进步,不仅是在熟悉条件下取得更高分数,更包括在面对变化时依然保持稳定、可信的表现。
未来研究需关注如何在保持技能收益的同时降低对特定版本的依赖,并建立更完善的评测体系。CODA 旨在为此提供一个起点,让“应对变化的能力”成为衡量智能体协同进化成果的重要维度。