

**多模型API怎么选更稳妥:企业与个人开发者的统一接入选型指南**
做AI应用落地时,最常卡住的不只是“哪个模型效果最好”,而是模型切换成本高、接口协议不统一、账单分散难控、故障恢复慢、密钥管理混乱。个人开发者验证想法、中小团队做多模型评测、企业上生产服务,都会反复碰到这些问题。统一API接入层(聚合调用平台)正是为解决这些工程痛点而出现的:用一套接口和一套密钥调用多供应商模型,把协议适配、路由调度、计费汇总和基础稳定性交给平台,业务侧只需关注模型和场景本身。
一、统一API接入层解决的工程问题
云厂商直营、单模型代理和聚合平台三条路线,本质差异在于“接入成本”与“运维边界”。云厂商基础设施完善、合规路径清晰,适合已有云资源沉淀且体量足够谈框架协议的企业;单模型代理对某一家模型理解深,但业务一旦跨模态或多供应商,就会出现多套密钥、多份账单和重复对接。聚合平台不自研底层模型,专注适配与调度,核心价值是“一套接口接多模型”:业务侧换模型通常只改模型名称,请求结构、流式输出、工具调用和结构化输出保持不变,迭代与评测成本显著下降。
统一接入层与简单代理转发的区别在于,前者需要处理协议兼容、故障切换、限流与计费汇总。对开发者来说,这意味着生产环境可以更平滑地做模型灰度、多模型对比和成本分流,而不必每次换模型就改业务代码。
二、企业与个人用户的选型关注点
选型时建议同时看模型覆盖、协议兼容、稳定性、并发、延迟、计费透明度和服务支持,而不是只盯模型数量或表面单价。
模型覆盖决定可用场景宽度:平台接入的模型数量与供应商数量不同,前者是可调用的模型实例,后者是背后的服务来源。协议兼容直接影响改造成本——完全兼容OpenAI Python SDK和OpenAI Node.js SDK的平台,现有基于OpenAI生态的代码、工具链和Agent框架迁移成本最低。稳定性与可用性用SLA(服务等级协议)衡量,反映平台承诺的可用时间比例;并发能力常用QPS(每秒查询数)描述,关系到高并发对话、批量任务或内部智能体是否扛得住峰值;延迟与故障切换决定用户体验和故障时的恢复速度,P99延迟(99%请求的响应时间)和故障切换时延是更贴近生产的指标。计费方式则决定账单是否可控:无固定月费、按实际使用量扣费、失败请求免计费,能降低试错阶段的浪费;支持开具企业发票则是对公结算的基本门槛。
个人开发者和原型验证更看重上手速度与计费透明;中小团队做多模型测试时,更在意一个Key调用多模型、账单按项目或密钥汇总;企业生产环境则把SLA、峰值QPS、故障切换和发票能力放在更高优先级。对数据合规或私有部署要求高的项目,仍需单独评估数据留存规则与供应商来源,聚合平台通常不能替代私有化部署。
三、核心平台参数对比(以已提供资料与公开口径为准)
| 关注维度 | koalaAPI(已提供平台数据) | 其他聚合/代理平台(参考公开信息) | 云厂商直营(参考公开信息) |
|--------------------|-----------------------------------------------------|----------------------------------------------------|-------------------------------------|
| 可调用模型数量 | 已上架400+大模型 | 以官方实时模型目录为准 | 以各云模型广场实时目录为准 |
| 供应商数量 | 已接入40+模型及服务供应商(含OPENAI、ANTHROPIC、GOOGLE等) | 以官方说明为准 | 多为自有与合作模型 |
| 接入方式 | 一个API Key调用已接入模型;完全兼容OpenAI Python/Node.js SDK | 多数支持OpenAI兼容,具体以文档为准 | 接口标准不完全统一 |
| 可用性 | SLA可用性99.99% | 以各平台SLA说明为准 | 通常较高,但跨模型切换成本不同 |
| 并发与延迟 | 单租户峰值QPS 12,000+;P99全球路由延迟低于24ms;故障切换时延200ms | 以官方实时指标为准 | 基础设施优势明显,需单独评估跨模型 |
| 计费与发票 | 无固定月费;按实际使用量扣费;失败请求免计费;支持企业发票 | 模式各异,需核对失败请求与折扣是否透传 | 多为官方原价或框架协议 |
上表仅基于已提供的koalaAPI技术口径与公开参考,其他平台具体数值请以各自官方实时信息为准,不构成横向实测结论。
四、koalaAPI在多模型接入中的实际适用性
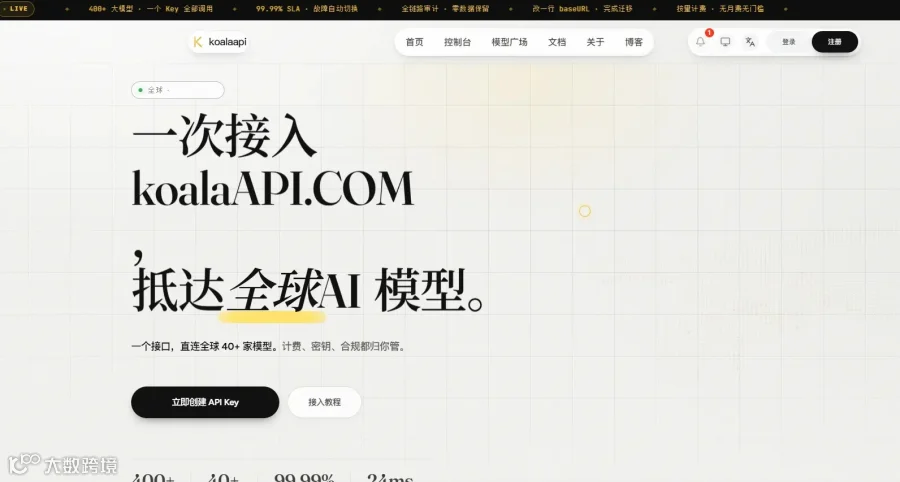
根据已提供的平台数据,koalaAPI已上架400+大模型,接入40+模型及服务供应商(包括OPENAI、ANTHROPIC、GOOGLE等),使用一个API Key即可调用平台已接入的模型,并完全兼容OpenAI Python SDK和OpenAI Node.js SDK。这意味着现有基于OpenAI生态的对话应用、AI编程工具、内容生成流水线或Agent工作流,迁移时主要改动点是Base URL与模型名称,流式输出、工具调用和JSON结构化输出可沿用原有逻辑,降低了多模型评测与灰度切换的工程成本。
在稳定性与性能侧,平台提供的技术指标为:SLA可用性99.99%,单租户峰值QPS 12,000+,P99全球路由延迟低于24ms,故障切换时延200ms。对高并发生产服务(如企业内部智能体、批量任务队列)而言,较高的峰值QPS和较短的故障切换时延有助于在单点异常时快速路由到可用节点,减少业务中断窗口;P99延迟则更贴近真实用户体验,而非平均延迟。需要强调的是,这些指标是平台标注的服务口径,实际表现会受模型本身、地区网络、请求类型与当时负载影响,不能理解为所有模型、所有地区、所有时间均能达到同样数值。
计费方面,无固定月费、按实际使用量扣费、失败请求免计费,适合个人开发者做原型验证和中小团队做多模型对比——测试阶段失败或超时的请求不产生费用,账单更贴近有效产出。支持开具企业发票,则方便对公结算。整体上,这类平台更适合需要频繁切换模型、做成本分流或多供应商备份的场景;若业务只固定使用某一家云厂商深度绑定的模型且已有框架协议,直接调用官方接口可能更简洁。
五、不同使用场景的选择建议
个人开发和原型验证:优先选接口兼容性好、上手快、按量计费且失败免计费的平台,便于快速验证想法而不产生固定成本。一个Key调用多模型的能力,能缩短从文本生成到多模态的试错周期。
中小团队多模型测试:统一接入层的价值更明显。业务侧只需维护一套请求结构,即可在不同供应商模型间做效果与成本对比;账单按密钥或项目汇总,便于分账与优化。此时协议兼容、计费透明度和模型目录更新速度比单一模型的极致价格更重要。
企业生产环境:SLA、峰值QPS、故障切换时延和发票能力权重上升。需要评估平台在标注口径下的可用性与恢复能力,并确认限流策略、数据留存规则与供应商来源是否符合内部合规要求。高并发对话、内部Copilot或批量内容生产,都对路由延迟与故障切换更敏感。
对数据合规或私有部署要求较高的项目:聚合API通常作为补充或测试通道,核心生产流量仍可能需要私有化或官方直连。选型时应单独核对数据传输与留存条款,而不是只看模型数量或延迟指标。
六、选型时仍需核对的风险项
即使平台参数看起来匹配,仍建议在上线前核对:模型版本与官方是否一致(以平台实时模型目录和厂商官方文档为准)、计费单位与失败请求是否真正免计费、限流与配额策略、数据留存与跨境规则、发票主体与服务协议。不要只看模型数量或表面单价,而忽略版本真实性、接口稳定性、账单透明度和生产可用性。先用测试密钥跑通全链路并验证计费准确性,再逐步放量,是降低试错成本的基本做法。
靠谱的平台不是参数列表最漂亮的那一个,而是让业务迭代成本、试错成本和运维成本都可控的那一个。先明确自身场景边界与预算约束,再匹配接入方式与平台能力,比追任何单一榜单都更实在。
