

一个"还没发布"的模型,为什么这么火?
你有没有想过:
-
手机相册为什么能自动认出"猫""汽车""蛋糕"? -
无人机怎么在飞的时候躲开电线杆? -
工厂流水线上,摄像头怎么一秒内挑出有瑕疵的零件? -
门口的监控,怎么分得清是人还是路过的流浪猫?
这背后有一类技术,叫目标检测。简单说就是:让机器看一眼画面,立刻告诉你"哪里有什么东西",并用一个框把它框出来。
而这个领域里最出名的名字,就是 YOLO,全称 You Only Look Once,"你只需要看一眼"。
最近,Ultralytics 公司(目前 YOLO 最主流的开源工具库就是他们在维护)在官方文档里悄悄上线了一个页面:YOLO27。

页面上顶着一行字:"即将推出"。
没有权重,没有代码,连发布日期都没有。
但数据已经摆在那儿了,这就很有意思了。
先泼一盆冷水:它还不能用
在你兴奋之前,先说清楚三件事,这也是官方自己写在页面上的:
- 模型目前尚未推出,也没有确定发布日期
,只说"预计今年晚些时候发布"。 - 页面上的成绩是"初步结果"
,最终发布前可能变化。 -
页面里的代码示例,现在的软件包跑不了,因为权重和实现都没公开。
所以现在谁要是跟你说"我已经用上 YOLO27 了",大概率是在吹牛。
那我们为什么还要聊?因为它预告的内容,透露了这个行业接下来的走向。
它到底厉害在哪?用大白话讲
官方给了四个"尺码":N、S、M、L,就像衣服的 S/M/L 码。
- N、S(小码)
:跑得最快,适合手机、无人机、树莓派这种"小身板"设备。 - M、L(大码)
:追求准,适合服务器、工业级场景。
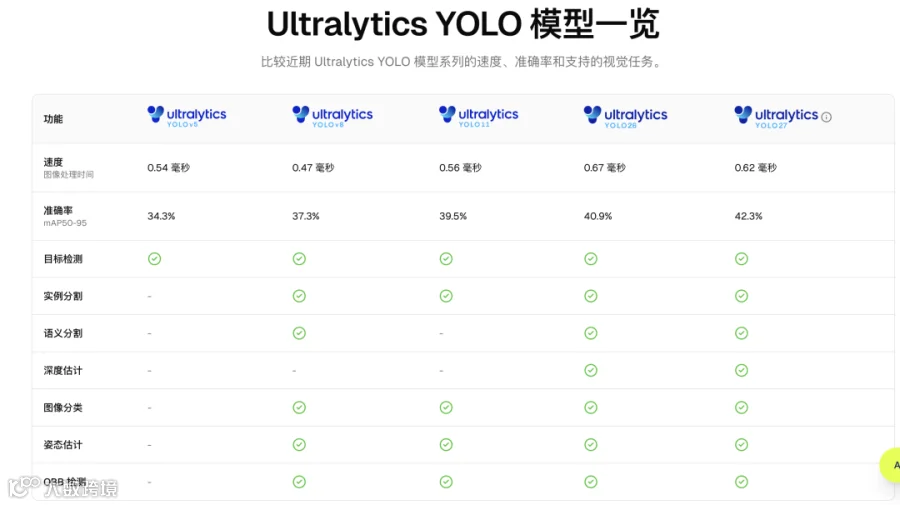
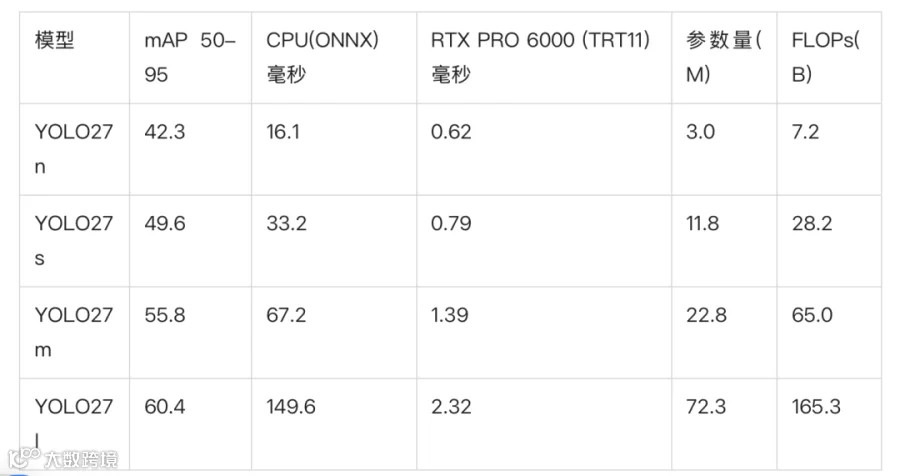
重点来了:官方宣称 L 号是 Ultralytics 家族里第一个在 COCO 测试中成绩突破 60 分的模型。
COCO 是目标检测领域最常用的"高考题库",mAP 是它的"得分"。60.4 分(输入 640 像素),换成更大的 800 像素输入能到 61.2 分。
而且速度没有牺牲:官方给的数据是在 NVIDIA RTX PRO 6000 显卡上,L 号约 2.3 毫秒处理一张图。
2.3 毫秒是什么概念?你眨一次眼大约 100 到 150 毫秒。这个模型在你眨眼的时间里,能看几十张图。
最小的 N 号更夸张:约 0.62 毫秒,参数量只有 300 万。
三个看得懂的"黑科技"
1. 小码模型:去掉中间层,直接"两眼看世界"
传统检测器会用三种"视力"同时找东西:近视(找小东西)、中等、远视(找大东西)。
YOLO27 的 N 和 S 干脆把"中等视力"砍掉,只留两头。
好比一个保安,不再逐层排查,而是只盯"远处的大目标"和"眼前的小细节"。计算量大幅下降,速度更快,精度据说还没掉。
2. 大码模型:干掉了"NMS"这道老工序
以前的检测模型有个尴尬的问题:同一只猫,会被框出七八个重叠的框,之后还得用一道叫 NMS(非极大值抑制) 的后处理,把多余的框删掉。
YOLO27 的 M 和 L 换了思路,采用 Transformer 风格的"查询式"解码器,一次直接输出最终结果,不需要再去重。
这相当于从"先拍十张再挑一张",变成"一次就拍对"。
3. 训练时有个"陪练",上线时就撤掉
官方设计了一个只在训练阶段存在的辅助分支,帮助模型更好地区分"这是目标"还是"这是背景"。训练完成后它会被移除,部署时不增加任何成本。
据官方说法,这让 YOLO26 上 0.9/0.8 mAP 的"训练与部署精度落差",缩小到了 YOLO27 上的 0.4 mAP。

它不只会"画框"
YOLO27 计划支持 7 类任务:

争议:版本号卷到 27,到底是真进步还是营销?
这是评论区最容易吵起来的一点。
支持派认为: 从数据看,N/S 在速度几乎不变的前提下精度提升,L 号首次站上 60 分,M/L 还引入了无 NMS 的新架构,这不只是改个名字。
质疑派认为:
-
YOLO 这个名字,最早出自 Joseph Redmon 的原作者系列,后来被不同团队接力使用。"27"是 Ultralytics 自己的编号,并不代表整个行业的"第 27 代"。 -
数据来自官方自测,目前没有第三方复现。 -
测试用的是新一代显卡(RTX PRO 6000)和 TensorRT 11,数字好看,不代表你的设备也能跑出来。
数据值得关注,但别急着下结论。等权重放出来,自己跑一遍再说。
对大多数人,官方的建议其实很实在,原话大意是:"目前的项目请继续使用 YOLO26。"
别觉得这只是工程师的事。几年后你可能会在这些地方"撞见"它:
-
你家的智能门锁、扫地机器人,识别会更准、更省电; -
无人机、自动驾驶对远处小物体的反应更快; -
工厂的质检成本更低; -
手机里的相机、相册、AR 功能更流畅。
技术的进步,常常就是这样:先在论文和文档里"安静地出现",再悄悄渗进你的日常生活。
技术细节
以下内容基于官方预告页,均为"发布后"的用法,目前无法实际运行。
1. 模型规格一览(官方初步数据,640 输入)
注意事项:
-
参数量和 FLOPs 是融合后的数值(Conv/BN 折叠,并移除了未使用的检测分支)。 -
速度测试用的是 nms=False 的无 NMS 检测头。 -
预训练检查点保留完整训练架构,实际显示的参数量可能更高。 -
GPU 为 TensorRT 11 + FP16,CPU 为 AMD EPYC 9655 + ONNX Runtime FP32。
2. 架构要点
- N/S
:精简 CNN,双尺度检测(砍掉中间尺度特征图),早期高分辨率阶段加宽以增强小目标,配合前景对齐监督(训练期辅助分支,推理/导出时移除)。默认使用带 NMS 的一对多检测头,可通过 nms=False切换到无 NMS 头。 - M
:YOLO26 风格卷积骨干 + 基于查询的 Transformer 解码器。 - L
:保留 FPN/PAN 颈部,骨干换为 UltraViT,在最深阶段使用自注意力捕捉全局上下文。 -
除检测外的其他任务(分割、姿态等)全部使用 CNN 架构。
3. 代码用法(发布后)
4. 现在能做的事-
项目现在就要上线:继续用 YOLO26,官方也是这么建议的。 -
想抢先体验:到官方页面加入候补名单。 -
想提前准备:用 yolo26 把数据集、训练流程、导出链路跑通,等 27 发布后只改一个模型名。 -
迁移前一定要用自己的数据、自己的硬件做对比,别只看 COCO 分数。
结尾
一个还没发布的模型,能引起这么多讨论,说明大家都在等下一个"拐点"。
不过,真正的好技术,不是预告页上的数字,而是发布之后经得起每个人的复现。