

导读Quant-Arena 的评测显示,整体排序信号有用,不保证实际买入的股票赚钱,仓位与交易成本还会进一步改变收益。Einsia.AI 的 Navers Lab 团队让九个模型编写并修改量化策略,再用封存的 A股历史行情检验。拆开这份榜单里的亏损、避跌与错过反弹,可以看清研究型 Agent 从会写代码到产生收益之间的距离。
本文 2290 字,阅读约 6 分钟
A股这道题,大模型也没拿稳
模型交策略,评估器负责把策略变成账户
排序有一点用,最看好的股票却未必最好
Astra 躲过了下跌,也少吃了反弹
多改几轮,改善的究竟是什么
A股这道题,大模型也没拿稳
会写代码,会分析数据,还能根据反馈修改方案。把这样的模型放进 A股,它能不能研究出一套赚钱策略?
Einsia.AI 的 Navers Lab 团队开发了 Quant-Arena(量化研究评测基准与公开竞技平台),并发布论文介绍规则与测试结果。论文 v1 于 2026 年 10 月 21 日提交 arXiv,属于预印本;下面讨论的是团队报告的历史模拟结果。
这份榜单测的是模型完成量化研究的表现。九个模型分别测试了所支持的推理强度档位,合计 38 种配置。medium、xhigh 等标签表示推理设置,不是模型参数规模。
榜单按综合得分排序,同时考察收益、风险、信号质量等表现。下表取每个模型总分最高的代表配置:四个盈利、五个亏损,九个都没跑赢收益为 17.1% 的股票池等权基准。等权是指给各只股票相同的目标权重。
总分最高,不等于收益最高。展开全部 38 种配置,Sol 的 medium 配置收益为 18.4%,是其中唯一跑赢基准的配置;但它的最大回撤也达到 −35.9%,即账户净值从此前高点一度回落了 35.9%。
因此,这次评测的结果是:多数配置未能跑赢,而不是所有模型、所有设置都失败。比较时还要记住,策略收益扣除了交易成本,17.1% 的股票池等权基准没有扣费,它也不是上证指数或沪深 300。
相比重新排一遍模型名次,我更关心的是:模型已经找到了有用信号,账户为什么还是可能亏钱?
模型交策略,评估器负责把策略变成账户
Quant-Arena 让模型扮演量化研究员。它获得数据接口与任务说明,自己写 Python,从 3042 只股票的日频行情,以及更细的报价、委托和成交记录中构造特征,再给股票打分。
特征是从原始记录中整理出的数值描述,策略再把它们组合成选股评分。用哪些特征、怎样评分,由模型编写的程序决定;平台不提供预定义因子库。
模型用 2022—2023 年的历史数据开展研究。每次研究运行最多评估五个候选策略,模型根据允许返回的收益、信号表现和错误信息改代码。最后冻结一份策略,再在封存的 2024 年行情上评估一次。这一年未参与前面的策略修改,因此称为样本外评估。
 上方是读取反馈、修改候选的研究阶段,下方是冻结程序在封存年份中的执行;两阶段之间不回传评估反馈 | 来源:Quant-Arena 论文 v1,图 2
封存评估运行的是冻结程序,模型不能根据 2024 年的评估结果继续修改策略。程序每天仍可按权限读取截至当时可用的历史观测,计算分数。模型利用反馈所作的改进,保存在提交的策略代码中。
分数随后交给统一评估器:目标是买入排名前 75 只股票,构成等权多头组合。多头指通过持有股票获取上涨收益,实际持仓还受评分覆盖、参与规则和成交约束影响。
评估器按整手交易,计算订单相关成本,以及买卖订单对成交价格造成的影响,后者通过模拟订单簿估计。没有投入股票的钱留在现金里,不产生收益。
这使评分到收益之间多了两道实际检验:买入的那部分股票表现如何,以及资金是否充分参与、成交付出了多少成本。
排序有一点用,最看好的股票却未必最好
论文用 RankIC 衡量信号:比较股票评分的排名与下一期收益的排名是否一致,再跨交易日取平均。数值为正,意味着整体排序平均有一定同向关系;它不是“预测对了多少只股票”的准确率。
但账户只买排名最前面的一小部分。全体股票排得更有条理,不保证最靠前的股票选得更好。
GLM-5.3 的代表配置,RankIC 为 0.046,年化收益却是 −7.8%;Opus 5.5 的 RankIC 为 −0.002,年化收益反而为 4.4%。只按这一个指标排序,无法判断账户结果。
为看清差别,研究团队每天按评分从低到高,把股票分成十组,检查各组次日平均收益。
 每幅图从左到右对应低分组至高分组,纵轴为次日平均收益,单位基点;多数模型的峰值出现在第二或第三组,最右侧高分组反而回落 | 来源:Quant-Arena 论文 v1,图 3
看 Gemini、GLM 等曲线,模型打分很高的那组股票,后续平均收益不如部分低分组。模型可能分辨出了一部分差异,却没有把最值得买的股票稳定放到最前面。
十组图反映的是股票分组后的平均表现,没有包含完整的仓位与成交过程,最右一组也不能等同于前 75 只股票组成的账户。它暴露了排序最前端的问题;这部分问题最终造成多大损失,仍要结合实际持仓与成本判断。
Astra 躲过了下跌,也少吃了反弹
即使选股信号较好,何时投入资金仍会改变结果。总分第一的 Astra 就主要通过减少市场参与,避开了一部分下跌。
它的 xhigh 配置在研究迭代中加入了一个开关:只有股票池过去五日和二十日对数收益的中位数都为正,才给股票打分,否则持有现金。对数收益用价格比值的对数衡量涨跌;取股票池的中位数,是用市场整体表现决定是否参与。
规则在研究阶段写入并冻结,随后用于 2024 年。两条净值曲线都从 1 开始:2 月 6 日,市场基准跌至 0.704,即比起点低约 29.6%,它仍为 1.000;直到 2 月 28 日才首次买入。
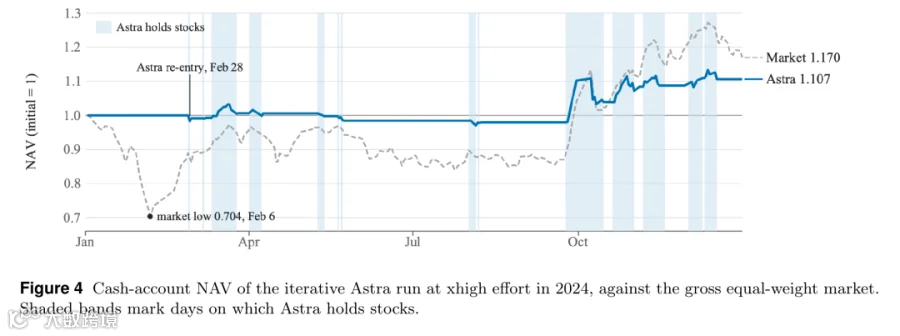 蓝线为 Astra xhigh 策略,灰色虚线为未扣费市场基准,浅蓝阴影为持股日;蓝线的长水平段显示了空仓避跌与错过行情的两面 | 来源:Quant-Arena 论文 v1,图 4
避跌确实降低了风险:它全年最大回撤为 −6.8%。代价也在图上——全年约 75% 的交易日持有现金,市场反弹时,它没有充分参与,最后收益为 10.7%,仍低于基准。
这让“模型学会了择时”有了具体含义:它写出了按市场状态切换参与的规则,并在这个年份避开了部分下跌。至于换一个年份是否仍有效,还需要验证。
多改几轮,改善的究竟是什么
这项测试也比较了单次生成与反馈迭代。按每个模型在两种设置下各自总分最优的配置配对,九个模型的分数全部提高,均分从 36.47 升到 43.55,但只有四个模型的样本外年化收益更高。
这个结果说明,研究得分的进步没有稳定转化为收益。不过,两边最优配置可能用了不同推理档位。附录进一步按同模型、同档位配对,38 组里,迭代有 34 组总分更高、26 组年化收益更高。
比较口径改变,看到的迭代收益也会改变。不能拿“四个提高”断言反馈多数时候无用,也不能拿“分数全部提高”断言多改代码就能持续赚钱。
别把反思当进化:Agent 真正“越用越强”,要补齐哪四个环节?
这些结果还限于给定研究预算与单一历史年份,本文没有独立复现。封存协议控制了研究中的数据访问与反馈,不能据此确认预训练阶段完全没有相关历史知识。榜单另列的 Kepler-1 是主办方自研私有策略,构建过程未披露,也不能直接用作同预算的通用模型对照。
我认为,这份榜单最有价值的地方,是让研究过程与最终账户放在一起接受检查。评估一个量化研究 Agent,既要看它能否改进代码,也要追问:它挑中的股票真的更好吗,仓位规则付出了什么代价,扣费后还剩多少收益?这些问题有了答案,模型的得分才更容易解释。
参考资料
•Quant-Arena 原论文 v1,研究协议、全部配置、信号诊断与配对实验: https://arxiv.org/html/2610.30113v1
•Quant-Arena 官方项目页,任务介绍、代表配置与私有策略说明: https://lab.einsia.ai/quant-arena
文章仅做学术分享,如有侵权请联系删除,非常感谢!