

导读据 Recursive 披露,AI 已参与 Flint 的架构搜索、量化方案和推理内核优化,团队将这些改进汇集成一款可本地部署的编程模型。2026 年 10 月 21 日发布的 Flint,为 AI 参与模型研发提供了一个具体案例。沿着“调用哪些参数、权重怎样存、硬件怎样执行”展开,可以看清这次交付的技术价值,以及判断自主研发程度还缺哪些证据。
本文 2563 字,阅读约 6 分钟
AI 参与研发,开始有了可下载的交付物
先选架构:总参数变多,激活参数变少
再做量化:连输出层也压缩,然后恢复精度
最后写内核:让压缩后的模型高效运行
参与范围更广,下一步要看改进能否延续
AI 参与研发,开始有了可下载的交付物
2026 年 10 月 21 日,Recursive 发布首款模型 Flint,并以 Apache 2.0 许可证开放权重。它面向本地编程智能体,支持文本输入输出和多轮工具调用;接入编程工具后,可用于阅读代码库、修复问题和实现功能。
模型卡给出的规模是总参数约 398 亿,每个 token 激活约 25 亿。Token 是模型处理文本的基本单位,由分词器切分得到。Recursive 报告,配合优化后的推理实现,Flint 在 M4 Pro MacBook Pro 的短上下文测试中,生成速度超过每秒 125 个 token。
这些指标之外,我更关心的是它的研发过程:Recursive 称,小规模人类团队与智能体在不到四个月内,从零训练并完成了这个模型。公司的自动科研系统 Eureka Machine,参与范围涉及数据、训练方法、基础设施和推理优化。
按官方说明,Eureka Machine 会提出候选想法,把想法实现为代码,运行实验,再根据结果决定下一步尝试。它能并行探索不同方向,并组合此前有效的方案。这里被自动化的是一轮轮研究与试错,Flint 则是人类团队与这套系统共同交付的模型。
这属于 AI4AI,也就是用 AI 帮助研发和改进 AI。此前,DeepMind 在 2025 年公布的 AlphaEvolve 已用 Gemini 生成并评估优化代码;据其披露,一项内核改进让 Gemini 整体训练时间减少约 1%。这条路线已经有实际成果。
Flint 值得展开的地方,是多个研发环节的改进,最终汇集到了同一个可部署模型中。要看清 AI 的贡献,可以沿着本地生成一个 token 的过程,拆开三件事:需要调用哪些参数,怎样读取它们,以及硬件怎样执行计算。
先选架构:总参数变多,激活参数变少
Flint 采用混合专家架构,也就是 MoE。它在相应网络层中设置多个专家子网络,由路由模块根据输入,为当前 token 选择其中一部分参与计算。
模型卡显示,每个 MoE 层有 256 个路由专家,每次选中 6 个,此外还有一个始终参与的共享专家。专家只是网络里的参数模块,并非 256 个独立聊天机器人。
这种设计让总参数规模与每步计算涉及的参数量分开。模型可以容纳更多参数,同时让一次生成只使用其中的一部分;但未被当前 token 选中的专家,仍属于需要存储和管理的模型权重。

Eureka Machine 在这里参与的是架构配置搜索。按官方披露,它从总参数 350 亿、激活参数 30 亿的基线出发,探索专家配置和网络宽度,最终选出了约 400 亿总参数、25 亿激活参数的方案。
这组搜索结果同时增加了总参数、减少了激活参数。按官方表述,在系统测试过的配置中,该方案被预计能取得最好的速度与编码表现组合;这个范围限定在它探索过的候选里。
激活参数量描述一次计算调用了多少参数,并不等于实际运算次数或耗时。注意力计算、输入长度、权重读取和运行实现,都会影响速度。架构搜索控制了其中一部分,后面还要继续处理权重和执行方式。
再做量化:连输出层也压缩,然后恢复精度
量化把权重从较高精度的数值表示,改成位数更少的表示,减少存储占用和读取的数据量。代价是表示变粗,可能改变模型输出,需要检查能力损失。
Flint 的一个具体选择,是将输出层 lm_head 的权重量化到 4 bit。输出层负责把网络内部表示转换成词表中各 token 的分数,随后再据此选择生成内容。
为什么专门处理这一层?在稀疏模型里,每步只调用部分专家,但输出层仍要参与生成。Recursive 的解释是:Flint 激活参数较少,输出层占每个 token 所读取权重的比例就相对较大。压缩这部分,便有机会进一步降低读取开销。
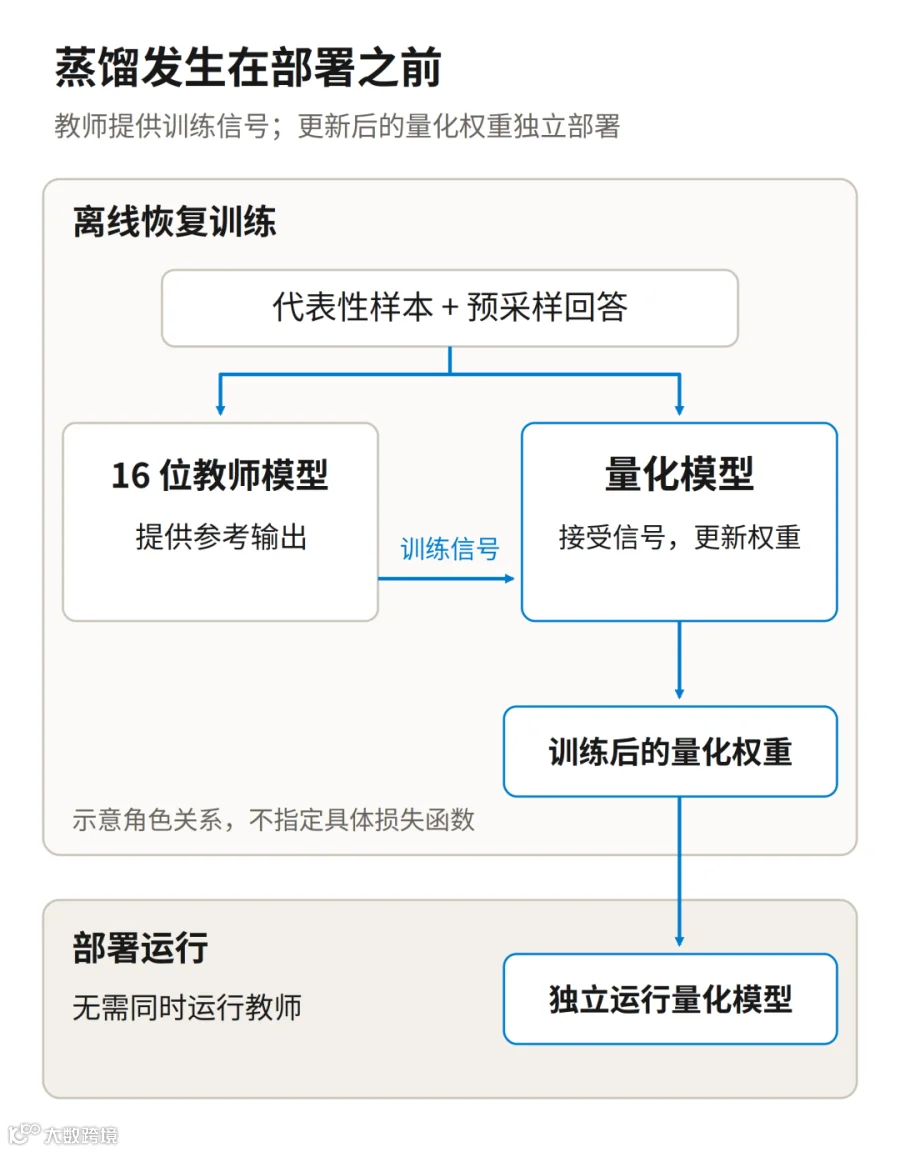
压缩之后,系统又加入离线蒸馏来恢复精度。蒸馏是在训练阶段,让压缩后的模型学习较高精度模型提供的输出信息。按官方说明,这一步使用量化模型预先采样的回答,以及系统选出的代表性样本集合,由 16 位模型担任教师。
这意味着,量化后的模型还经过了额外训练;用户运行时,不需要再调用一份教师模型。
恢复训练之后,能力保留了多少,要回到结果检查。下面的 BF16 是 16 位浮点权重版本,NVFP4 是面向 NVIDIA 硬件的低位浮点量化版本;Mac 使用的是另行准备的量化权重与运行实现。
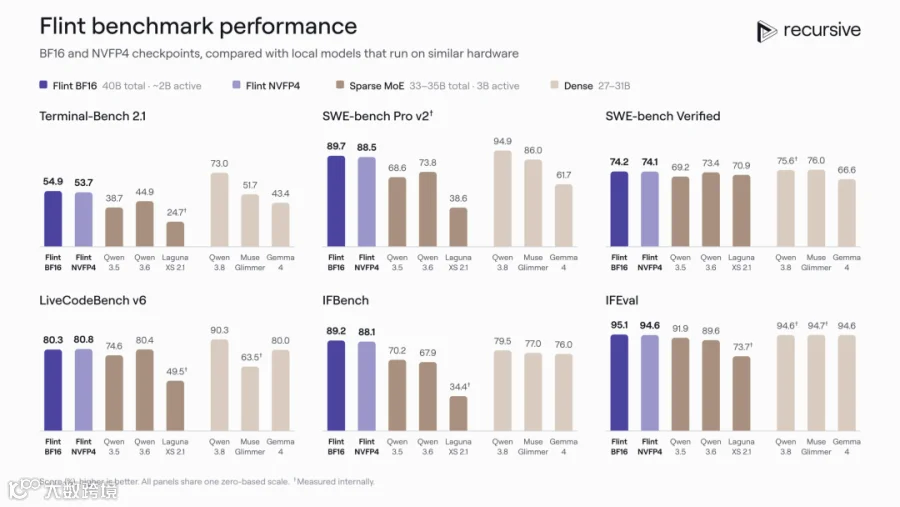 深紫色为 BF16,浅紫色为 NVFP4;重点比较每组前两根柱子,观察同一模型压缩前后的成绩变化 | 来源:Recursive 官方模型卡
官方图中,六项成绩按相同权重取算术平均,量化前后差约 0.6 个百分点;但 Terminal-Bench 与 SWE-bench Pro 两项各下降了 1.2 个百分点,LiveCodeBench 则略有上升。
这支持的判断是:在这组评测中,压缩后总体成绩接近原版,各任务仍有差异。它不能保证任意代码库和任意精度版本都没有损失。
图中的编程智能体成绩还依赖外部运行框架:例如 SWE-bench 使用 mini-swe-agent,让模型与工具共同完成软件修复任务。报告的平均 pass@1,衡量的是单次尝试成功率,并对至少五轮运行取平均。这些都是 Recursive 报告的评测结果,本文没有独立复现。
最后写内核:让压缩后的模型高效运行
架构选出了每步调用的参数规模,量化减少了权重数据量,接下来还要把这套模型高效地执行出来。
内核是硬件执行某项计算的底层程序。相同数学运算,采用不同的数据组织和执行方式,耗时可能不同。因此,“参数少”与“实际跑得快”之间,还隔着推理实现。
据 Recursive 披露,Eureka Machine 针对 Apple Silicon 和 NVIDIA RTX Spark,生成了低位计算、MoE、注意力与提示词处理等专用内核。在 M4、M5 芯片上,它还生成了针对苹果 GPU 的融合内核,称为 Metal megakernel,将解码阶段一次前向传播融合执行。
这里的前向传播,是模型根据已有输入计算下一步输出的过程。融合执行把原本分散的计算合并组织,为减少调度和中间数据处理开销创造条件;具体能快多少,仍需要硬件测试。
 左列是 1K 输入长度下的解码吞吐,右列是覆盖至 128K 上下文的平均指标,均不含提示词预处理;两列口径不同,不能互换 | 来源:Recursive,Flint 官方发布页
看配备 48GB 统一内存的 M4 Pro:Flint 使用优化后的 MLX 推理实现,短上下文为 131.22 tokens/s,使用另一套推理实现 llama.cpp 为 87.98;右列的平均指标则分别为 68.89 和 47.58。这测的是逐个生成 token 的解码速度,不包括先处理输入提示词的阶段。
同一个模型,运行实现改变,速度就变了;上下文长度改变,速度也变了。每秒生成多少 token,还不能直接换算成完成一次编程任务需要多久:读取提示词、推理生成、运行工具和修改代码,都在总耗时之内。
Recursive 同时开源了本地引擎 rec。按 10 月 22 日核对的文档,其 Mac 路线支持 M4 Pro、M5 Pro、M5 Max,要求至少 48GB 统一内存和约 30GB 空闲磁盘空间,并针对单会话优化。调用少量专家,并没有让硬件门槛自动降到普通小模型的水平。
参与范围更广,下一步要看改进能否延续
这三项改进连在一起:架构搜索确定模型配置,量化与恢复训练改变权重的表示和数值,专用内核负责高效执行。AI 研究系统在多个环节产生的方案,被组合成了最终可运行的模型与工具。
不过,参与范围和自主程度需要分别判断。公开材料没有充分量化人类设定目标、审查实验、筛选方案和整合成果的投入,也没有提供足以拆分各项贡献的完整消融与研发成本对照。因此,四个月交付一款模型,还无法证明自动科研系统究竟节省了多少总成本。
OpenAI 公开内部 AI 研发方法论:研究员每天烧 600 美元,但 Agent 真正接管了什么?
Recursive 希望进一步实现 RSI,也就是递归式自我改进:用更强的模型增强研发系统,再由更强的研发系统推动下一代模型。Flint 展示了其中一轮的人机协作成果,后续还要检验这套方法能否持续提高研发效率。
我会继续关注下一款模型:在可比预算下,Eureka Machine 能否利用这一轮积累,用更少的人类投入或算力,交付更强的结果。能参与多个研发环节,已经有了具体案例;能否持续提高研发效率,还需要后续交付来回答。
参考资料
•Recursive Flint 官方发布,研发过程、架构搜索、量化与内核优化: https://recursive.com/updates/introducing-recursive-flint
•Recursive 官方更新列表,Flint 发布日期: https://recursive.com/updates
•Flint 官方模型卡,参数口径、量化对照与评测条件: https://huggingface.co/RecursiveSI/flint
•rec 官方仓库,推理引擎、运行条件与吞吐测试口径: https://github.com/recursive-oss/rec
•rec 官方文档,Mac 支持范围与启动方式: https://docs.recursive.com/edge/rec
•AlphaEvolve 官方发布,利用 AI 优化 Gemini 训练的前例: https://deepmind.google/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/
文章仅做学术分享,如有侵权请联系删除,非常感谢!