


语音识别的目标,是将语音转换为文本。但在真实交流中,说话人的语言表达具有丰富的地域差异。当识别对象从标准语转向地方方言时,模型需要适应的变化不仅包括发音,还涉及词汇、句法和书写习惯。这也使方言语音识别面临一个基础问题:同一段语音,应当以怎样的文字形式呈现?
▎从一个现象说起:为什么练好了客家话,粤语反而退步?
同一个语音识别模型可以支持多种方言,也可以根据任务要求,保留方言原文或转换为普通话。当不同方言采用不同输出模式时,这些能力之间可能出现相互影响。
例如,粤语要求保留原文,客家话要求转换为普通话。加强客家话训练后,客家话结果有所改善,粤语输出却可能变得更“普通话化”,即方言词被替换,句式被改写,原文转写的准确率随之下降。
为什么这两项任务可能互相影响?从现实世界中的关系来看,粤语与客家话在广东部分地区毗邻或交错,不少变体也具有共同的语音特征,如保留塞音韵尾。
粤语主要分布在广东中、西部、广西东、南部、以及海南和港澳地区。客家话主要分布在广东东北部、江西南部、福建西南部。
从模型角度看,当两种方言共用编码器和解码器时,相近的语音特征可能形成部分重叠的内部表示,但训练目标却不同。
加强客家话训练,可能同时增强解码器的普通话生成偏好,使这种偏好迁移到粤语输出中;反过来,强化粤语原文转写,也可能让客家话输出保留更多方言词汇和句式,偏离原本的普通话转换要求。
▎如何选择并控制合适的输出策略?
一种直接的处理思路,是分别设置提示词(prompt),明确要求“保留粤语原文”或“将客家话转换为普通话”。这样可以减少输出目标的歧义,但如果系统根据已知的方言类别选择 prompt,就相当于提前提供了方言先验信息。在 qwen-audio-3.1-asr 中,就支持了 16 种方言可控的 ASR/AST 转写模式。
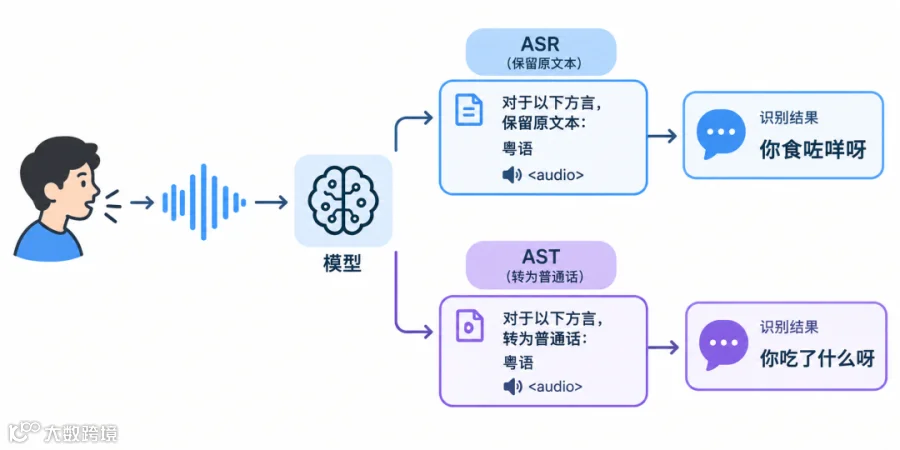
(图 1:通过提示词控制方言语音的输出模式)
(图 1:通过提示词控制方言语音的输出模式)
而在直面用户真实应用中,往往没有输入方言的先验知识,一句话内还可能存在混用,难以预先控制转写合适的模式。如果统一采用“粤语保留原文,客家话转普通话”的指令,模型就需要同时处理两个问题:
当前语音属于哪种方言;
这个方言应当采用哪种输出方式;
当语音特征存在歧义时,模型可能采用错误的方言解释,进而偏离目标模式。即使方言判断正确,也可能受到早期已生成的偏好的影响,沿用错误的转写模式。
▎CER 上升背后:模型究竟错在哪里,如何评测?
同样是 CER 上升,背后可能对应不同的问题:模型可能听错了内容,也可能保留了原义却采用了错误的输出模式。要解释“跷跷板”效应,需要结合多种评测方式来判断。
▶ CER / SER
这些指标适合衡量输出与目标参考的匹配程度,但不能直接解释错误原因。
在 AST 模式下,同一个意思可能存在多种普通话表达,措辞不同也会产生编辑距离。
在 ASR 模式下,同一个方言发音也可能对应不止一种写法,例如借音字的使用差异,以及尚未统一的书写习惯。
因此,应按不同的转写模式分别记分,并固定简繁体、方言用字、数字等归一化规则,避免评分方式掩盖真实变化。
▶ 转写风格浓度
以要求保留原文的粤语“佢聽日唔嚟”为例:
他明天不来:核心语义保持,但转成了普通话佢聽日嚟:保留粤语形式,但丢失否定信息
仅看原文 CER,两种输出都会被计错为了区分这类问题,可以引入“转写风格浓度”这一辅助观察维度,检查方言词、语气词和句式被保留或转换的情况。
值得注意的是,不见得所有方言 ASR 转写结果都应当具备“方言风格”,从文本层面判断“转写浓度”并不全面,风格浓度更不宜简单等同于方言字占比,需要在构建测试集或做评测时注意。
▶ 语义一致性
语义评测重点检查实体词、时间、数量、否定和条件等信息。
上例中的“他明天不来”保持了核心意思,而“佢聽日嚟”虽然更像粤语,却改变了事实。
可以依据人工核验的原文与普通话释义,结合人工或大模型评审,判断输出是否存在信息遗漏、增添和替换。评价重点应落在信息保持上,流畅程度只能作为辅助。
▎既要声学,也要语义
ASR 强调对原话的忠实记录,AST 则要求语义转换,但两者都依赖准确的语音感知与上下文理解。缓解“跷跷板”效应,需要根据评测结果,判断应当调整语音表示、任务选择,还是文本生成策略。
▶ 稳定编码器,减少语音表示漂移
如果模型已经具备较好的方言感知能力,可以尝试在训练早期冻结编码器,优先训练连接模块或解码器,减少适配过程对已有语音表示的扰动。
但冻结的前提是已有表示足够可用。如果模型尚不能区分目标方言的关键发音,仍需要逐步解冻相关层,让编码器学习新的语音特征。
▶ 调整可训练范围,让任务选择得到适配
有时候,模型已经具备了各种转写能力,只是在路径选择上不太确定。如果模型基本保持了原义,却频繁采用错误模式,值得检查负责条件控制的模块是否得到充分训练。
例如,对于包含显式路由的 MoE 模型,可以考虑将路由器纳入适配;对于普通编码器—解码器模型,则需要检查任务标签、连接模块或解码器的训练范围。
▶ 增加显式标签,让判断与生成可以分别观察
还有一种思路是显式区分方言标签与任务标签:先预测方言,再根据应用规则指定 ASR 或 AST,最后生成文本。这样可以分别检查方言是否判断正确、模式是否执行正确。
但是,标签还需要配套的训练监督;如果数据始终将一种方言绑定一种模式,仅增加标签仍可能延续原有绑定关系。对于方言混用的语音,还需要考虑片段级判断,避免一个句级标签决定整句话的输出策略。
▎让每一次提升与退化都可以被解释
多方言识别中的“跷跷板”效应,反映了内容识别、语义转换与输出控制之间的复杂关系。
因此,评价一次训练的收益,需要同时观察各项任务:哪些内容识别得更准了,哪些输出偏离了目标模式,以及一项能力的提升是否影响了其他方言。
当我们能够说明模型提升了什么、退化在哪里,并为原因找到证据,后续优化就有了更明确的方向。这也是多方言模型走向稳定可用的重要一步:既准确理解不同的语言表达,也按照任务要求,可靠地写下它们。
