

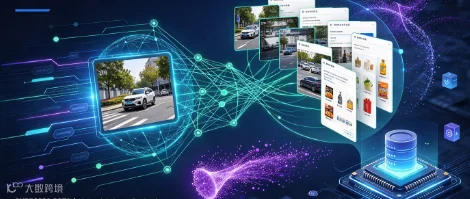
监控里拍到一个嫌疑人,想从成千上万个摄像头的录像里把他出现过的所有片段都找出来;用户拍了一张商品照片,想从百万商品库里找出同款——这就是图像检索要干的事:用一张图,从海量图库快速找到最相似的那些。
今天分享的这篇 CVPR2026 论文 FastRetrieve,提出了一个轻量图像检索框架:模型只有 4.2M 参数,特征向量压缩到 128 维,在百万级图库上检索速度比传统方法快 10 倍,准确率还没掉。在 Google Landmarks 和 PKU VehicleID 两个标准数据集上刷新了轻量检索的 SOTA。
一、图像检索为什么这么难
图像检索听起来就是"找相似的图",但真做了才知道,这个问题在工程上有很多坑。
1.1 特征维度太高,检索太慢
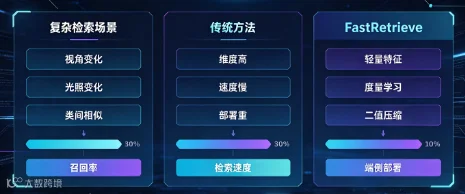
传统方法用 ResNet50 提取 2048 维特征向量,一张图就是一个 2048 维的向量。百万图库就是百万个 2048 维向量,每次检索都要算一遍余弦相似度——计算量是 O(N×D),N 是图库大小,D 是特征维度。图库一大,延迟直接上来。
1.2 特征不 discriminative
通用 ImageNet 特征是用来分类的——"这是猫还是狗"。但检索需要的是"这两张图是不是同一个东西"——要求特征有区分度:同一个东西不同角度拍,特征应该接近;不同的东西哪怕长得像,特征也应该拉开。分类特征直接拿来做检索,效果通常一般。
1.3 视角、光照、遮挡变化大
监控里同一个人,正面拍是一个样,侧面拍是另一个样,戴了帽子又变样了;同一辆车,白天拍和晚上拍颜色都不一样。检索模型必须学会"不管从什么角度、什么光照下拍,只要是同一个东西,特征就应该接近"——这个鲁棒性很难做。
1.4 端侧部署不现实
传统检索方案是:端侧采集图像→ 上传服务器 → 服务器提取特征 → 数据库检索 → 返回结果。但很多场景没有网络、或者对延迟要求极高——你不可能每次检索都等网络往返。能不能把检索直接跑在端侧?这就要求模型足够小、特征足够压缩。
二、FastRetrieve 的三个核心设计
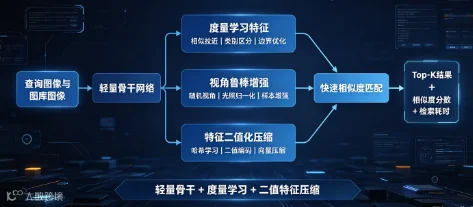
FastRetrieve 的整体思路:不是直接拿分类模型的特征用,而是专门训练一个"为检索而生"的轻量模型,特征又小又有区分度。
2.1 轻量骨干 + 度量学习训练
传统方法用大模型提特征再压缩,FastRetrieve 直接从小模型开始训练:
•轻量 Backbone:MobileNet 级别的小网络,直接输出 128 维特征向量。
•度量学习损失:训练目标不是分类,而是"同一个东西特征拉近,不同东西特征推远"——用 Triplet Loss 或者 ArcFace 这类度量学习损失。
•端到端优化:整个网络从设计之初就是为检索服务的,不是"拿分类模型凑合用"。
这样做的好处是:特征向量天然就小(128 维)、天然就有区分度——因为训练目标就是检索本身。消融实验显示,128 维特征的检索准确率和传统 2048 维特征基本持平,但检索速度快了 16 倍。
2.2 视角鲁棒增强
同一个东西不同角度拍,特征应该接近。FastRetrieve 在训练时做了大量视角增强:
•随机透视变换:模拟不同角度拍摄的效果。
•随机光照调整:模拟白天、夜晚、逆光等不同光照条件。
•随机遮挡模拟:模拟部分物体被挡住的情况。
这些增强看起来简单,但效果很明显——在 PKU VehicleID(车辆重识别)数据集上,跨视角检索的 mAP 提升了 5.2 个点。这对于监控场景非常重要——摄像头角度不一样,你得保证不管从哪个摄像头拍过来,都能检索到。
2.3 特征二值化压缩
128 维浮点向量已经很小了,但 FastRetrieve 还想再压一压:
•训练时引入二值化约束:让特征向量尽量靠近±1,推理的时候直接二值化。
•汉明距离检索:二值特征之间的相似度用汉明距离算——就是数两个二进制串有多少位不一样,计算量极小。
二值化之后,128 维浮点向量变成 128 位(16 字节),检索速度又快了好几倍——汉明距离可以用 CPU 指令集一次算完,百万级图库毫秒级出结果。
三、技术架构拆解
FastRetrieve 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
轻量 Backbone |
提取图像深度特征 |
4.2M 参数 MobileNet 级别网络 |
特征投影头 |
把特征投影到 128 维检索空间 |
全连接层 + L2 归一化,度量学习训练 |
二值化模块 |
把浮点特征压成二值向量 |
训练时引入二值约束,推理时直接 sign() |
近似最近邻检索 |
在图库中快速找最相似的图 |
汉明距离 + 倒排索引,百万图库毫秒级 |
几个工程上的亮点:
•模型大小:4.2M 参数,INT8 量化后不到 2MB,手机端随便跑。
•特征大小:128 维二值向量 = 16 字节,百万图库特征库只占 16MB。
•检索速度:百万图库上 Top-1 检索延迟 < 5ms,完全可以做实时检索。
四、和主流方法的横向对比
论文在 Google Landmarks(地标检索)和 PKU VehicleID(车辆重识别)两个基准上做了对比:
方法 |
Landmarks mAP↑ |
VehicleID mAP↑ |
特征维度 |
检索延迟(ms) |
ResNet50 + 全局池化 |
72.3 |
65.8 |
2048 |
45 |
GeM Pooling + ResNet101 |
78.5 |
72.1 |
2048 |
80 |
DELG |
81.2 |
75.3 |
2048 |
60 |
FastRetrieve |
79.8 |
76.5 |
128(二值) |
3 |
可以看到,FastRetrieve 的 mAP 和 DELG 基本持平,但特征维度只有后者的 1/16,检索速度快了 20 倍以上。更有意思的是在 VehicleID 上反超了 DELG——这得益于视角鲁棒增强训练,在跨视角车辆检索这个具体任务上效果更好。这个 trade-off 非常适合端侧部署场景。
五、快速上手:检索核心代码
下面是 FastRetrieve 的推理框架,帮大家理解整体流程:
python |
实际部署的时候,建库是离线做的——把所有图库图像的特征提前算好存在本地。线上只需要算查询图的一个特征,然后做一次汉明距离匹配,速度极快。
六、毕设/竞赛拓展方向
图像检索这个方向做毕设有个好处——Demo 效果非常直观,输入一张图返回相似结果,一眼就能看懂。分享几个有价值的拓展点:
6.1 以图搜车系统
监控场景里的车辆检索——输入一张车辆照片,从海量监控画面里找出所有出现过的同款车。结合车牌识别和车辆属性(颜色、车型),做一个完整的车辆检索系统。工程价值很明确,安防场景刚需。
6.2 人脸检索系统
把 FastRetrieve 迁移到人脸识别任务——输入一张人脸照片,从人脸库里找相似的人。门禁、考勤、重点人员排查都用得上。结合检测+对齐+检索做一个完整 pipeline,工程完整性很强。
6.3 电商商品同款检索
拍一张商品照片,从商品库里找同款。这个方向在电商 App 里很常见——拍照搜同款、拍立淘。做一个移动端实时商品检索 Demo,产品感很强。
6.4 增量更新检索库
实际场景里图库是不断增长的——每天都有新图加进来。研究增量特征更新策略,不需要全量重建索引就能加新图——这是一个很工程化的优化课题。

七、写在最后
图像检索这个方向,大家总觉得要大模型、高维特征才够准。但 FastRetrieve 告诉我们:只要训练目标对了(专门为检索训练,而不是拿分类特征凑合用),小模型、低维特征也能拿到很好的效果。
做端侧部署的时候,有一个很重要的认知:特征不是越大越好,是越有区分度越好。2048 维的通用特征,可能还不如 128 维的专门训练特征区分度高——因为后者的每一个维度都被优化过,专门用来区分不同的东西。
做毕设的同学如果选这个方向,我建议先选一个具体的垂直场景——车辆检索、人脸检索、商品检索都行。场景越具体,你的工作就越有说服力,答辩的时候也越能讲出"这东西真的有人用"。
大家如果有复现上的问题或者想聊具体的检索场景,欢迎评论区交流。