

哈喽,我是cos大壮~
“参数模型是不是参数少,非参数模型就是没有参数?”
这是很多同学第一次接触这两个概念时,最容易产生的误解。
假设我们想根据房屋面积预测房价~
参数模型的思路是:先确定一个函数形式,比如房价与面积满足线性关系:
其中, 是房屋面积, 是预测房价, 和 是模型需要学习的参数。
无论训练数据有100条还是100万条,模型始终只需要学习这两个参数。模型结构提前确定,参数数量不会随着样本量增长。
非参数模型则不急着规定房价一定满足哪条公式。比如K近邻回归会找到面积最接近的 套房子,再根据这些邻居的价格进行预测。
一句话概括的话,参数模型先规定函数长什么样,非参数模型让数据决定函数长什么样。
参数模型与非参数模型
参数模型通常可以写成:
这里的 是一组固定维度的参数。线性回归、逻辑回归、朴素贝叶斯都属于典型的参数模型。
参数模型的优势是训练快、占用内存少、解释性较好。但如果预设的函数形式与真实规律差别很大,就会出现欠拟合。
需要注意,参数模型不等于线性模型。多项式回归虽然能拟合曲线,但只要多项式次数提前固定,它依然是参数模型。
再来看K近邻回归。它的预测可以表示为:
表示距离 最近的 个样本, 是邻居的目标值, 是权重。距离越近,权重通常越大。
KNN会保存训练样本,数据增加后,模型需要保存和使用的信息也会增加,因此属于非参数模型。
这里的“非参数”不是没有参数。KNN依然有邻居数量 、距离度量等超参数,只是它没有固定维度的参数化函数。
完整案例
我们构造一组带噪声的非线性数据,分别训练:
-
五次多项式岭回归:参数模型; -
距离加权KNN回归:非参数模型。
下面代码可以直接运行,大家可以直接执行~
import numpy as np
import matplotlib.pyplot as plt

from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.linear_model import Ridge
from sklearn.neighbors import KNeighborsRegressor
from sklearn.metrics import mean_squared_error

# 1. 构造虚拟非线性数据
rng = np.random.default_rng(42)
X = rng.uniform(-3, 3, 240).reshape(-1, 1)

def true_function(x):
    return np.sin(1.5 * x) + 0.15 * x ** 2

noise_std = 0.18 + 0.05 * np.abs(X[:, 0])
y = true_function(X[:, 0]) + rng.normal(0, noise_std)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)

# 2. 参数模型:固定为五次多项式
param_model = make_pipeline(
    PolynomialFeatures(degree=5, include_bias=False),
    StandardScaler(),
    Ridge(alpha=0.05)
)

# 3. 非参数模型:距离加权KNN
nonparam_model = make_pipeline(
    StandardScaler(),
    KNeighborsRegressor(n_neighbors=15, weights="distance")
)

param_model.fit(X_train, y_train)
nonparam_model.fit(X_train, y_train)

param_test_pred = param_model.predict(X_test)
knn_test_pred = nonparam_model.predict(X_test)

print("Polynomial test MSE:",
      mean_squared_error(y_test, param_test_pred))
print("KNN test MSE:",
      mean_squared_error(y_test, knn_test_pred))

# 4. 图一:拟合曲线与残差联合分析
x_grid = np.linspace(-3, 3, 600).reshape(-1, 1)
true_grid = true_function(x_grid[:, 0])
param_grid = param_model.predict(x_grid)
knn_grid = nonparam_model.predict(x_grid)

plt.style.use("seaborn-v0_8-whitegrid")
fig, axes = plt.subplots(
    2, 1, figsize=(11, 9),
    gridspec_kw={"height_ratios": [2, 1]}
)

axes[0].scatter(
    X_train[:, 0], y_train,
    c="#00C2FF", edgecolor="white",
    s=38, alpha=0.75, label="Train data"
)
axes[0].plot(
    x_grid[:, 0], true_grid,
    color="#111111", linewidth=3,
    linestyle="--", label="True function"
)
axes[0].plot(
    x_grid[:, 0], param_grid,
    color="#FF2E63", linewidth=3,
    label="Polynomial Ridge"
)
axes[0].plot(
    x_grid[:, 0], knn_grid,
    color="#7B2CFF", linewidth=3,
    label="Weighted KNN"
)
axes[0].set_title("Model Fit Comparison", fontsize=16)
axes[0].set_ylabel("Target")
axes[0].legend(ncol=2)

param_residual = y_test - param_test_pred
knn_residual = y_test - knn_test_pred

axes[1].axhline(0, color="#222222", linestyle="--")
axes[1].scatter(
    X_test[:, 0], param_residual,
    color="#FF2E63", s=45, alpha=0.75,
    label="Polynomial residual"
)
axes[1].scatter(
    X_test[:, 0], knn_residual,
    color="#7B2CFF", marker="^",
    s=45, alpha=0.75, label="KNN residual"
)
axes[1].set_title("Test Residual Analysis")
axes[1].set_xlabel("X")
axes[1].set_ylabel("Residual")
axes[1].legend()

plt.tight_layout()
plt.show()

# 5. 图二:两类模型的复杂度曲线
degrees = range(1, 13)
poly_train_mse, poly_test_mse = [], []

for degree in degrees:
    model = make_pipeline(
        PolynomialFeatures(degree=degree, include_bias=False),
        StandardScaler(),
        Ridge(alpha=0.05)
    )
    model.fit(X_train, y_train)
    poly_train_mse.append(
        mean_squared_error(y_train, model.predict(X_train))
    )
    poly_test_mse.append(
        mean_squared_error(y_test, model.predict(X_test))
    )

neighbors = range(1, 41)
knn_train_mse, knn_test_mse = [], []

for k in neighbors:
    model = make_pipeline(
        StandardScaler(),
        KNeighborsRegressor(n_neighbors=k, weights="distance")
    )
    model.fit(X_train, y_train)
    knn_train_mse.append(
        mean_squared_error(y_train, model.predict(X_train))
    )
    knn_test_mse.append(
        mean_squared_error(y_test, model.predict(X_test))
    )

fig, axes = plt.subplots(1, 2, figsize=(13, 5))

axes[0].plot(
    degrees, poly_train_mse,
    color="#00C2FF", marker="o",
    linewidth=2.5, label="Train MSE"
)
axes[0].plot(
    degrees, poly_test_mse,
    color="#FF2E63", marker="s",
    linewidth=2.5, label="Test MSE"
)
axes[0].set_title("Polynomial Complexity")
axes[0].set_xlabel("Polynomial Degree")
axes[0].set_ylabel("MSE")
axes[0].legend()

axes[1].plot(
    neighbors, knn_train_mse,
    color="#00C2FF", linewidth=2.5,
    label="Train MSE"
)
axes[1].plot(
    neighbors, knn_test_mse,
    color="#7B2CFF", linewidth=2.5,
    label="Test MSE"
)
axes[1].invert_xaxis()
axes[1].set_title("KNN Complexity: Higher to the Right")
axes[1].set_xlabel("Number of Neighbors K")
axes[1].set_ylabel("MSE")
axes[1].legend()

plt.tight_layout()
plt.show()
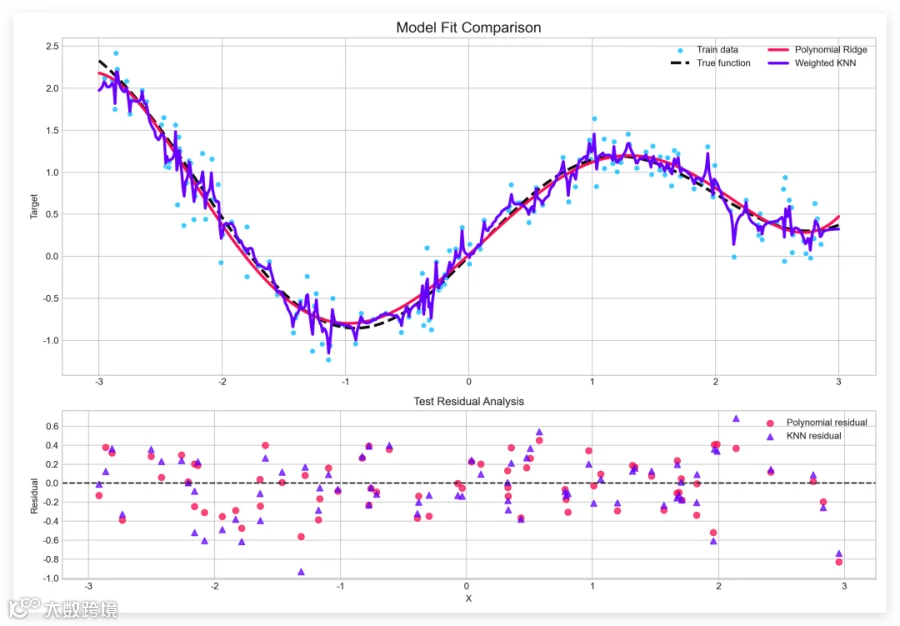
第一张图的上半部分比较了真实函数和两种模型的拟合曲线。多项式回归得到的是一条整体平滑的曲线,因为它必须遵守提前设定的五次多项式结构。
KNN更依赖局部样本,曲线会随着附近数据发生变化。它对复杂规律更灵活,但样本噪声较大、 又设置得太小时,曲线也会跟着噪声波动。
下半部分是测试集残差,残差定义为:
残差越均匀地分布在0附近,说明模型预测越稳定。如果某个区间的残差持续偏正或偏负,说明模型没有学好这一段规律。

第二张图展示模型复杂度变化。多项式次数越高,表达能力越强;但次数过高后,训练误差继续下降,测试误差反而上升,这就是过拟合。
KNN则相反。 越小,模型越关注局部数据,复杂度越高; 越大,预测结果越平滑。我们将横轴反转后,向右同样代表复杂度提高,更方便对比。
实验注意
数据量较小、强调解释性或推理速度时,可以优先尝试参数模型。它通常也是一个很好的基线模型。
当数据规律复杂、函数形式难以提前确定时,树模型、KNN等非参数模型更有优势。不过它们更依赖数据量,也需要认真控制复杂度。
真正决定效果的不是模型属于哪一类,而是模型假设、数据规模和任务规律是否匹配。
最后
参数模型用固定数量的参数描述规律,结构清晰、训练高效;非参数模型让数据决定函数形状,灵活性更强,但对数据和计算资源要求更高。
接下来大家可以继续尝试调整多项式次数、岭回归的 以及KNN的 ,观察偏差与方差如何变化。也可以把KNN替换成决策树或随机森林,再比较它们在复杂非线性数据上的表现。