

欢迎向本公众号投稿文献解读类原创文章,投稿邮箱:380198025@qq.com,请将稿件以附件形式发送。海内外招生、访学、招聘等稿件,请联系微信:xiongzhankun1997。
编辑 | 郑婧博
审核 | 王紫嫣
今天介绍一篇arXiv上的文章:“InstructPro2: Natural Language and Biological Grounding Guided De Novo Protein Design”。计算蛋白质设计的目标是按需生成具有特定功能的蛋白质,而自然语言能够灵活表达多样化的设计目标。然而,现有生成方法要么只支持狭窄的任务类型,要么对配体、抗原等生物学约束利用有限,导致设计成功率难以提升。针对这一问题,InstructPro2 提出了一个统一框架:用文本编码器处理自然语言指令,用专门的配体与抗原编码器提供生物学背景,再由蛋白质解码器在二者条件下生成序列。为支持预训练,作者基于 InterPro 注释构建了包含 2.057 亿对“功能描述–蛋白质”样本的 InstructPro2Bench 数据集,并采用文本前缀条件、辅助文本重建损失以及零初始化门控交叉注意力适配器,将通用指令跟随能力平滑迁移至抗体设计与配体结合蛋白设计任务。实验表明,InstructPro2 在功能恢复 F1(74.8 对 62.2)和全局 RMSD(3.04 Å 对 5.33 Å)上优于 Pinal 等基线,抗体设计 DockQ 达 0.39,配体结合对接成功率达 72.6%,说明语言指令与生物学 grounding 的结合能有效扩展蛋白质生成的应用场景,而湿实验验证仍是未来工作的重要方向。
介绍
蛋白质是生命功能的执行者。如果能让计算机直接根据需求“按需定制”蛋白质,将极大加速新药研发、酶工程和生物传感器的开发。近年来,计算蛋白质设计领域主要沿着两种范式进行探索:
-
传统功能性蛋白质设计:从无条件生成到条件引导早期研究证明了基于大规模进化序列训练的模型,无需显式条件就能生成多样且折叠良好的蛋白质。随后,研究者引入了各类条件信号来引导生成,例如基于标签的方法(利用蛋白质家族、EC编号等注释)和基于结构的方法(设计特定的骨架或支架功能基序)。近年来,更先进的模型甚至实现了针对特定结合伙伴的原子级设计。
-
自然语言引导的蛋白质设计:利用文本指令驱动生成受大语言模型指令跟随能力的启发,这一方向试图让模型直接理解人类的自然语言。现有方法通常采用两种路径:一是将文本描述映射为中间结构表示,再生成序列;二是学习蛋白质-文本的联合嵌入空间,以实现基于文本的序列检索或生成。最近,也有研究开始尝试直接根据开放式人类指令来设计蛋白质。
然而,现有方法仍存在明显的局限:无论是传统条件生成,还是自然语言引导,它们往往受限于特定且狭窄的设计任务;同时,模型对配体、抗原等关键的生物学约束条件利用不足,缺乏足够的“生物学根基(biological grounding)”。因此,如何高效、精准地设计出具备任意用户自定义功能,且真正贴合真实世界场景的蛋白质,仍是一个悬而未决的挑战。
为了打破这一瓶颈,研究团队推出了全新的功能性蛋白质设计框架——InstructPro2。该工作做出了以下三大核心贡献:
-
提出创新的双条件架构:模型不仅通过文本编码器读懂自然语言指令,还专门引入了配体和抗原编码器。通过零初始化的门控交叉注意力机制,将生物学背景平滑注入蛋白质解码器,让模型不仅“听懂人话”,还能“看懂靶标”。
-
构建超大规模数据集 InstructPro2Bench:团队基于 InterPro 注释,自动化构建了包含 2.057 亿对“功能描述-蛋白质”的数据集,并采用两阶段训练策略(先预训练通用指令跟随,后微调真实任务),赋予了模型广泛的泛化能力。
-
在多个基准与下游任务中刷新成绩:在通用功能蛋白生成上,InstructPro2 的功能恢复 F1 达到 74.8(最强基线为 62.2),全局 RMSD 降至 3.04 Å(基线为 5.33 Å);在下游任务中,抗体设计的 DockQ 达到 0.39,配体结合蛋白的对接成功率高达 72.6%。
这项研究证明,将自然语言指令与具体的生物学实体结合,能够有效拓展蛋白质生成的边界,为未来更精准、更可控的蛋白质设计提供了极具潜力的新范式。
方法
模型概览
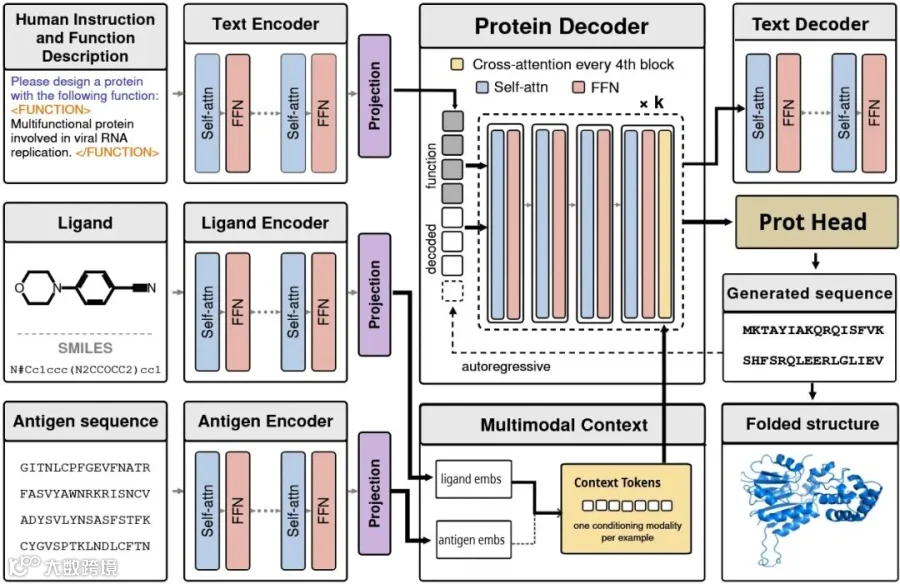
模型整体架构如图1所示。InstructPro2 采用多模态条件生成架构,将人类自然语言指令、配体(SMILES)或抗原(氨基酸序列)分别通过专门的文本编码器与生物编码器提取特征;文本特征经投影后作为“前缀”输入蛋白质解码器,而生物特征则被转化为“上下文令牌(Context Tokens)”,通过每四层插入的交叉注意力机制与解码器融合;最终,解码器在双重条件的引导下自回归地生成目标蛋白质序列,同时辅助的文本解码器利用隐藏状态重建指令以强化语义对齐,生成的序列随后可折叠为三维结构以验证其生物学功能。
问题定义
设 表示氨基酸词汇 上的蛋白质序列, 表示文本词汇 上的自然语言功能描述,其中 和 分别表示它们的序列长度。作者将生物学依据表示为 ,捕捉上下文特异性约束,如靶配体的SMILES链或抗原序列。目标是学习一个生成模型 ,参数为 ,设计功能性蛋白质序列 ,遵循自然语言指令 ,同时满足生物学基础 。
蛋白质解码器和文本条件
InstructPro2的核心是一个蛋白质解码器,一种类似GPT-J的自回归变换器,具有旋转位置嵌入。作者采用自回归文本编码器编码自然语言指令 :
并将投影表示 作为蛋白质符号嵌入 的前缀连接。通过解码器进行一次阻断因果处理,得到蛋白质序列logits:
其中 是解码器在目标位置 处的最终隐藏状态。第二个文本解码器接收解码器在文本位置上的隐藏状态 ,并通过一次教师强制(teacher-forced)的前向传递,从这些状态中重建条件描述,从而提供一个辅助信号,防止解码器在第一遍处理后丢弃该描述。
模态条件化
对于抗体和配体变体,冻结的模态编码器 会对相应的辅助模态 进行编码。所得的表示通过 投影到解码器的嵌入空间中,由一个学习到的每种模态标量 重新缩放,并由一个学习到的模态类型嵌入 进行偏置:
每隔四个解码器层插入零初始化的门控交叉注意力适配器,共八个适配器。将解码器第 个模块自身子层的输出记为 :
附加在该模块上的适配器计算方式为:
这里, 表示层归一化, 是进入解码器第 个模块的隐藏状态, 是该模块自注意力和前馈子层的输出。交叉注意力以 作为查询(queries),以多模态上下文 作为键(keys)和值(values)。由于 被初始化为零,该模态通路最初不贡献任何信号,从而在微调开始时保持预训练解码器的计算不变。在预训练期间,所有组件联合训练:蛋白质解码器、编码器层、文本投影和重建头。在微调期间,从预训练检查点初始化,并加入模态投影和门控交叉注意力适配器。所有这些组件在微调期间保持可训练,而文本编码器和两个模态编码器保持冻结,使得条件表示保持固定,模型学习去读取它们,而不是重塑它们。
训练目标
在两个阶段中,InstructPro2都会最小化以下损失函数:
在预训练阶段,生物学上下文 被省略(即不加该条件)。文本重建损失项由一个超参数 加权,这使其保持为一个辅助信号,从而让蛋白质生成始终是主要目标,在这里作者将 设置为0.5。
InstructPro2Bench构建
为训练基础模型,作者构建了InstructPro2Bench,这是一个包含205,727,986个“蛋白质-文本”对的大规模语料库。InterPro注释提供了与蛋白质功能直接相关的蛋白质结构域、位点、基序、家族和其他序列特征的结构化词汇表。作者使用Gemini 3.1 Pro对49,677个InterPro条目进行了一次性总结,生成了可复用的自然语言组件;通过组合与每个蛋白质相关的功能特征,这些组件可以跨蛋白质进行组合。

作者选择最多三个相关的InterPro条目来组装每个蛋白质的功能描述,这些条目的描述共同捕捉了不同的功能特征,优先选择更具体的功能注释,而非更宽泛的注释:首先选择位点、活性位点和翻译后修饰(PTMs),其次是结构域和重复序列,然后是家族,最后是超家族。随后使用Jaccard相似度去除所选条目中的冗余注释,使保留的条目能够捕捉蛋白质功能的不同方面。然后,使用在单个功能组件之间提供连接短语的模板,将选定的描述组合成一个单一的自然语言指令提示,从而为训练生成一致、可组合的蛋白质功能表示。
接着,作者使用两个互补的目标在得到的数据集上进行训练,使模型既能根据功能生成完整的蛋白质序列,也能根据功能补全部分指定的序列:
-
自回归生成(50%):模型接收自然语言功能描述,并被要求以自回归方式生成完整的蛋白质序列。
-
掩码填充(50%):作者应用了一种跨度破坏目标,每条序列随机挖去 20%–40% 的长度。挖空并非整块切除,而是被切分成多个平均长度约 20 个氨基酸的跨度,跨度之间保留至少 5 个已知氨基酸作为上下文。在输入时,每个被挖空的跨度会替换为专属的哨兵token( 到 ),模型需要根据残留的序列上下文以及经过功能描述指令,按编号精准复原缺失片段。这种相同的跨度填充公式被重新用于抗体设计任务中的HCDR生成,为跨训练阶段的局部序列设计提供了一种共享机制。
同时,为了防止训练集与评估集之间发生数据泄露,作者严格在“簇”级别对数据集进行划分:使用 MMseqs2以50%的序列一致性和80%的覆盖率为标准对序列进行聚类,共产生了29,008,229个不同的簇。随后分别为验证集和测试集分配了约 1,000 个簇,训练集使用其所属簇内的所有蛋白质序列,而验证集和测试集则每个簇仅评估一条代表性序列(通过水库采样法选取)。
真实世界任务的数据整理
抗体-抗原设计蓝图。 为了将模型扩展到抗体设计,作者构建了结合“抗体序列、抗原信息与自然语言描述”的样本。团队从 SAbDab 中提取了高质量的抗体-抗原复合物子集,利用其结构和功能信息生成自然语言描述;为解决配对数据规模有限的问题,又补充了来自 SAbDab、TrEMBL 和 SwissProt 的额外抗体样本,并通过模板将现有注释转化为自然语言描述,从而在没有抗原条件下也能提供序列-功能训练数据。另外,由于 CDR-H3 是核心设计目标,作者基于 CDR-H3 序列在 40% 一致性下进行聚类,并严格以“簇”为单位按 8:1:1 划分训练、验证和测试集,同时丢弃了落入已分配簇的补充数据以及重复 PDB ID 的样本,从而彻底杜绝了高度相似抗体序列在训练集与测试集之间的泄漏。
配体-蛋白质设计数据集。 为了将自然语言引导的设计扩展到配体结合蛋白,作者构建了“蛋白质-配体-文本”三元组数据。该数据基于InstructProBench划分,包含 872 万训练样本、3,263 个验证样本、1,500 个可见配体测试样本,以及 127 个未见配体测试样本(专门用于评估模型对未知配体的泛化能力)。功能描述沿用预训练时的 InterPro 流水线生成,配体则以 SMILES 字符串表示,并由冻结的 ChemBERTa 编码器提取特征,通过交叉注意力机制注入模型。
实验
预训练模型效果如何?
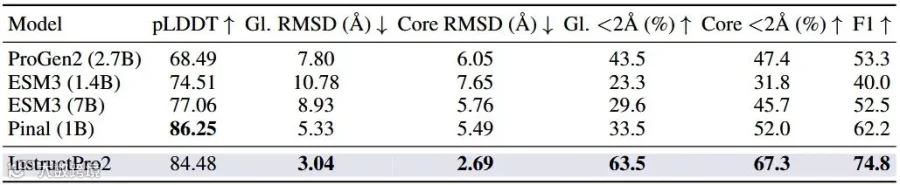
InstructPro2能够根据人类指令设计满足任意目标的蛋白质。表 1 报告了预训练模型在 InstructPro2Bench 上的性能表现。InstructPro2 在所有结构准确性评估指标上均取得了最佳性能。具体而言,与所有对比模型相比,InstructPro2 实现了最低的 RMSD 和最高的 <2Å 成功率:将全局 RMSD 从最强基线的 5.33 Å 降至 3.04 Å,并将 <2Å 准确率提升至 63.5%(次优模型为 43.5%)。在取得这些成绩的同时,它还超越了参数量是其两倍以上的 ESM3 7B 模型。
生成的序列不仅折叠合理,还表达了所需的功能。 仅凭结构正确并不能证实生成的蛋白质执行了所需功能。表 1 的最后一列直接评估了这一点,通过检查条件文本中指定的 InterPro 结构域是否真实存在于折叠后的设计中。InstructPro2 获得了所有模型中最高的 F1 分数,其恢复所需结构域的频率显著高于最强基线(74.8 对 62.2)。
利用InstructPro2可以设计出高质量的抗体吗?

作者在整理好的抗原-抗体复合物数据集上对预训练的 InstructPro2 进行了微调。在推理阶段,微调后的模型 InstructPro2-Ab 能够根据给定的抗原和自然语言设计蓝图,生成全部三个重链 CDR 环(HCDR1–3)。表 2 报告了抗体设计的性能。InstructPro2 在所有指标上均取得了最佳性能,甚至略优于专门针对抗体设计的模型 RefineGNN。具体来说,InstructPro2-Ab 获得了所有对比模型中最高的 DockQ 和 ipTM,不仅明显领先于通用的蛋白质语言模型(DockQ 为 0.39,而 ESM3 为 0.29,ProGen2 为 0.28),也以微弱优势领先于专为抗体 CDR 设计构建的 RefineGNN(0.39 对 0.38)。这些结果表明,InstructPro2 不仅能够遵循自然语言指令,还能考虑生物学基础信息(即抗原),从而设计出高亲和力的抗体。
InstructPro2可以设计配体结合蛋白吗?
最后,作者评估了 InstructPro2 的配体条件化变体设计质量,既包括训练期间见过的配体,也包括一个用于测试泛化能力的零样本未见配体集。
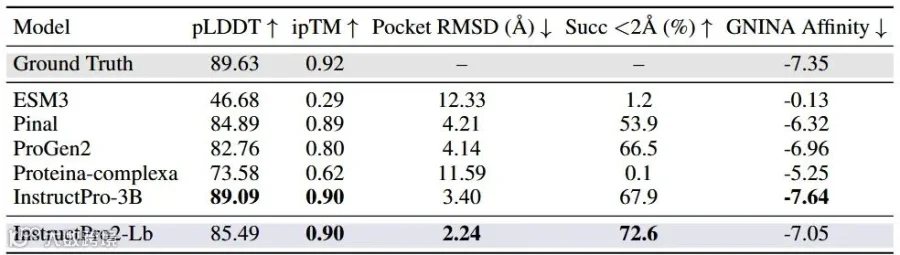
在见过的配体上,InstructPro2-Lb 对结合口袋的定位最准确。表3报告了口袋 RMSD、对接成功率以及预测的结合亲和力。与所有对比模型相比,InstructPro2-Lb 取得了最高的成功率和最准确的口袋定位,大幅优于 ESM3 和 Proteina-complexa,并将口袋 RMSD 从最强基线 InstructPro-3B 的 3.40 Å 降至 2.24 Å。虽然 InstructPro-3B 获得了更低的 GNINA 预测亲和力(-7.64 对 -7.05),但它对口袋的定位不够准确,且成功完成的目标更少(67.9% 对 72.6%)。

在训练中未见过的配体上,口袋准确度依然保持。表4在留出的未见配体上重复了该项评估。InstructPro2-Lb 在口袋 RMSD 和成功率上继续保持领先,这表明其配体条件化能力能够泛化到训练分布之外,而不是仅仅记住了见过的配体化学性质。在这个较小的留出集上,Pinal、ProGen2 和 Instruct-Pro-3B 的差距不大,并在 pLDDT 上略微超过了 InstructPro2-Lb,但它们的口袋定位都不够准确(分别为 2.56 Å、2.47 Å 和 3.05 Å,而 InstructPro2-Lb 为 1.81 Å)。
生物学条件真的有用吗?
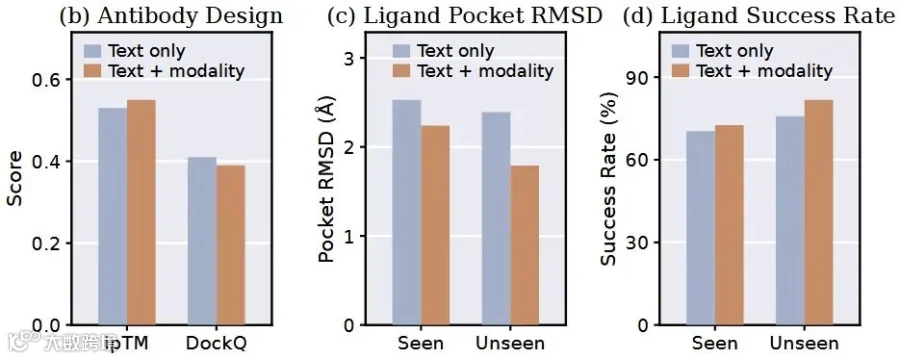
既然自然语言提示词已经把设计靶标描述得很清楚了,专门引入配体/抗原编码器还有必要吗?消融实验给出了一个精准的答案(图3(b-d)):文字描述无法完全替代直接的物理结构输入。在抗体设计中,由于文字提示已极其精确,加入抗原编码器带来的增益微乎其微;但在配体结合任务中,引入配体模态让结合口袋的精准度显著提升。尤其是在面对训练中完全没见过的化学配体时,模态输入带来的提升幅度是见过配体的两倍以上(误差从2.41 Å骤降至1.81 Å)。这证明:当面对完全未知的化学空间时,光靠文字描述是不够的,直接的生物学实体编码才是模型精准“捏”出结合口袋的关键。
案例分析
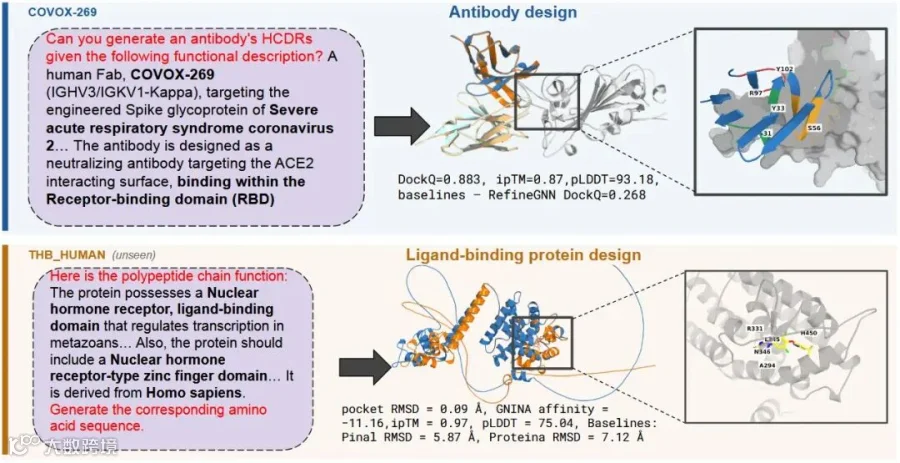
图4展示了一个抗体设计案例和一个配体结合蛋白设计案例,说明了模型的条件化机制是如何在单个设计中体现出来的。针对靶向 SARS-CoV-2 受体结合域(RBD)的 COVOX-269 抗体,InstructPro2-Ab 以 0.883 的 DockQ 分数成功复原了结合界面,而 RefineGNN(0.268)则未能做到。自然语言指令中明确指出了 ACE2 相互作用的表位及其在 RBD 中的位置,这是仅靠抗原结构本身无法获得的信息。对于未见过的 THB_HUMAN 靶标(属于训练中留出的功能家族),InstructPro2-Lb 达到了 0.09 Å 的口袋 RMSD,而 Pinal 和 Proteina-complexa 分别为 5.87 Å 和 7.12 Å;其 GNINA 预测亲和力为 −11.16,与实验结构的 −11.12 高度吻合,表明该结合口袋在化学性质和几何结构上都非常准确。需要说明的是,这些是精选案例,而非随机抽样。
结论
InstructPro2 是一个功能性蛋白质设计框架,它通过文本编码器、配体/抗原编码器以及蛋白质解码器,将自然语言指令与生物学背景知识相结合。利用 InterPro 注释的可组合性,团队构建了包含 2.057 亿对“功能描述-蛋白质”的 InstructPro2Bench 数据集,以极低的成本实现了跨家族的指令跟随。实验表明,InstructPro2 在结构准确性和功能恢复上均优于基线模型;同一解码器还能迁移至真实任务,在抗体设计上达到 0.39 的 DockQ,在配体结合设计上达到 72.6% 的对接成功率。但目前评估均基于计算,缺乏湿实验验证是本工作的主要局限,也是未来研究的重要方向。InstructPro2为整合生物学依据提供了统一机制,推动了自然语言引导的蛋白质设计,并为更可控的蛋白质生成及实际应用提供了实用资源。
原文及代码
原文:https://arxiv.org/abs/2610.19592
代码:https://github.com/chovak/InstructPro2

扫描二维码获取
更多精彩
AI in Graph

点个在看+赞支持一下