

10 月 22 日前后,Hugging Face 生物研究线放出 Carbon-X。团队成员 Loubna Ben Allal 在 X 上发帖,工具侧到当晚显示大约 5.9 万次展示、五百多个赞;Lewis Tunstall 同日跟进,把「DNA 和自然语言第一次放进同一套 14B 开源权重」写进推文。Business Insider、TNW 跟了报道;TNW 转述 WIRED 的一句尤其刺耳——这些预测还没经过实验室验证。
模型卡上的定位不绕弯:把原始 DNA 贴进普通聊天,它用自然语言回答。突变更像良性还是致病、哪一段可能调控基因表达、序列更像哪类生物、后面的碱基怎么续,并给出理由。回复里可以同时出现碱基串和说明文字。权重挂在 HuggingFaceBio/Carbon-X,许可 Apache 2.0;同日还有官方量化仓 HuggingFaceBio/Carbon-X-GGUF。
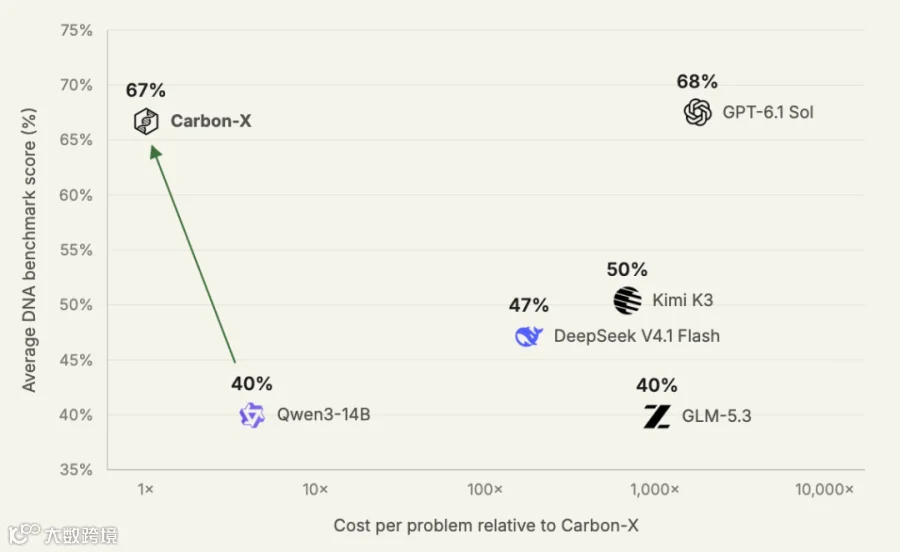
我先把结论撂这:它确实把「读序列」和「说人话」揉进同一个解码器,做应用的人第一次可以用开源权重在内网搭「DNA 助手」原型;但模型卡写明未临床验证、不该用于医疗决策,基因数据又极度敏感。自报分数贴近一张前沿闭源对照表,不等于你可以拿它出诊断报告,更不等于实验室已经点头。
01
PART
它是什么,能干嘛
WHAT IT DOES
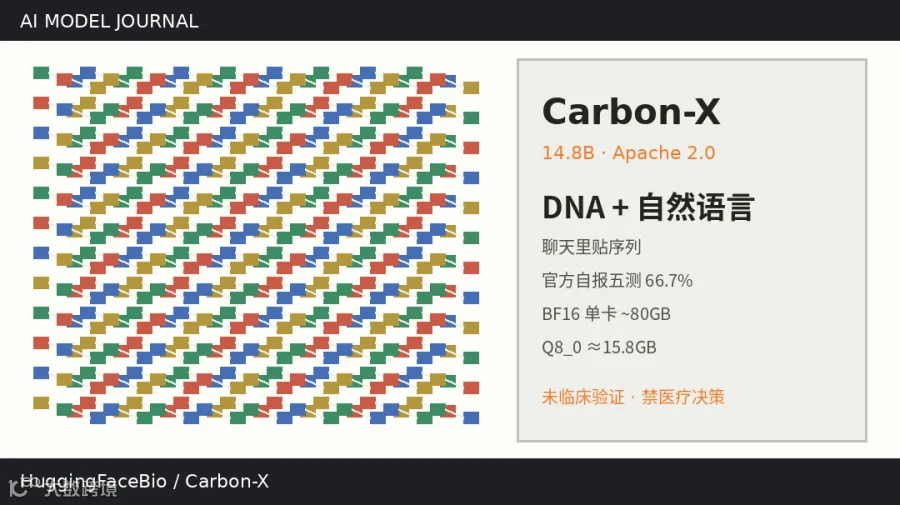
Carbon-X 总参数 14.8B,结构是标准的 decoder-only:40 层,hidden 5120,GQA(40 个 query 头、8 个 KV 头),SwiGLU,带 QK-norm。起点是 Qwen3-14B。没有单独的 DNA 编码器——DNA 和文本走同一条 token 流、同一个解码器。
分词是混合方案:文本仍用 Qwen3 的 BPE;DNA 按不重叠的 6-mer 切,一个 DNA token 覆盖 6 个碱基。词表里额外加了 5,515 个 DNA 相关 token(含 4,096 个 6-mer 与尾部 token、起止标记)。提示里至少 6 个连续 A/C/G/T 会被自动打上 DNA 标记。上下文窗口模型卡写的是 40,960 token。
训练量官方写:大约 302B token 的 mid-training,配比大致是原始 DNA 约 55%、英文约 20%、生物学文本约 15%、指令数据约 10%;再加监督微调,以及两轮带可验证奖励的异步 GRPO。评测与后训练都按关闭 thinking;生成默认温度 0.6、top-p 0.95、top-k 20,与 generation_config.json 一致。
官方五张 DNA 榜(均自报、thinking off):BioReason Coding(编码区变异,提示里去掉基因名)、BioReason Non-SNV(插入缺失等)、GenomeQA、NextBase、FrontierVEP。五测均分 66.7%,比起点 Qwen3-14B 高 27 个点,也压过他们表里其他开源模型;对照表里 GPT-6.1 Sol 是 67.5%。成本口径按 H200 小时约 5 美元折算吞吐,约对方每题的 1/1,800。
他们还估过:ClinVar 约 240 万条意义未明变异,用 Carbon-X 大约 300 美元量级,对照前沿模型 3.2 万到 400 万美元——这是厂商估算,不是你的云账单,引用请标「官方估算」。
GenomeQA 细分更能说明强弱:生物类群 93.2%、motif 90.0%、增强子/启动子 70.0%;剪切位点只有 29.8%,组蛋白标记 34.6%。同一张卡上的数字,已经把冷水写进规格表里了。
合作方模型卡写明:Hugging Face、中关村学院(Zhongguancun Academy),以及意大利 Telethon 遗传医学研究所 / 那不勒斯费德里科二世大学。媒体引过 Tunstall:训练数据里刻意去掉病毒相关内容,降低滥用面;同时强调开源是为了让研究者不必事事仰仗少数前沿实验室。
02
PART
对做应用的人意味着什么
FOR BUILDERS

第一,权重可下、许可干净。Apache 2.0,可改可商用(托管 API 与第三方 Endpoint 的数据条款另算)。未发表或受控序列可以留在自己的机器上。
第二,接口按聊天模型来。Transformers 需 v5+,tokenizer 必须 trust_remote_code=True;或 vLLM 起服务后走 OpenAI 兼容口。仓内带 Agent 示例和 carbon-dna skill,前面通常要先有一台能扛约 80GB 显存的服务。
第三,提示有讲究。序列和问题放同一条 user 消息;基因名、链、坐标、注释尽量带上;问变异时给参考与突变序列。给 Agent 用时序列按名字引用、由代码查表传入,减少抄错长串碱基。
第四,它擅长解释与分类,不擅长精确编辑。数碱基、对坐标、做精确修改应配对 Python。产品层要把「模型建议」和「代码/实验核实」拆开,文案写清非诊断意见。
对「会工具不会变现」的读者:能卖的通常不是「AI 看基因」口号,而是「内网可审计的序列解释工作台」——权限分级、调用日志、人工复核流、拒绝输出医疗结论的产品边界。这些才是交付物。空口说取代测序报告,既踩红线也撑不住复购。
最小可报价闭环可以长这样:本机或内网 vLLM → 业务系统只传脱敏/授权序列 → Carbon-X 出解释草稿 → 规则引擎拦截「诊断/用药」类措辞 → 生信或临床同事签字。过关标准写成「20 条公开示范序列解释完整率 + 零医疗断言泄漏」,比空喊「AI 看懂基因」好卖得多。
03
PART
能不能本地跑:先看文件大小
WILL IT FIT
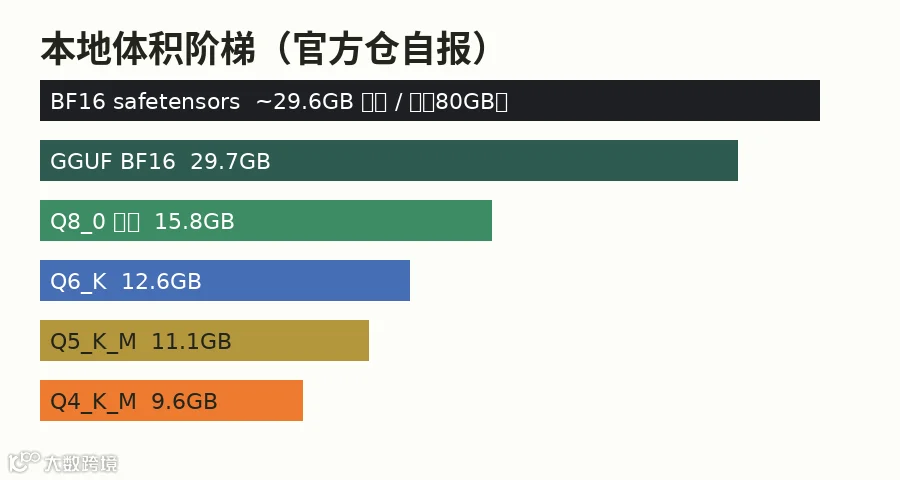
评论区反复问量化。我按 Hugging Face 主仓与 GGUF 模型卡核了一遍(10 月 23 日早上):
BF16 safetensors两片合计约 29.6GB,推理建议单卡 80GB 级 GPU + vLLM / Transformers;GGUF BF16 29.7GB;Q8_0(官方推荐) 15.8GB;Q6_K 12.6GB;Q5_K_M 11.1GB;Q4_K_M 9.6GB。K 量化里 DNA 相关 embedding 与输出保持 Q8_0。
「单卡 80GB」对的是 BF16 推理余量,不是「硬盘上只有 30GB 文件就够」。KV 缓存和长上下文还要另留。Q8_0 官方写大约需要 16GB 显存,再加每 token 约 0.16MB 的 KV;开满 40960 上下文时,还要看 llama-server 默认把上下文分给几个并行槽。
GGUF 硬前提:llama.cpp b11742 或更新才带 HybridDNATokenizer;旧版能加载,但会把 DNA 切错——等于白跑。主仓 Agent 章节也提醒:没有正确 DNA 分词的运行时不要硬上。采样请跟模型卡:关闭 thinking,温度 0.6 / top-p 0.95 / top-k 20 / min-p 0;llama.cpp 自己的默认温度和 top-k 不一样,不改就和官方评测错位。
命令摘自官方模型卡与 GGUF 卡(10 月 23 日)
# A. vLLM(BF16,约 80GB 卡)
vllm serve HuggingFaceBio/Carbon-X --trust-remote-code
# B. llama.cpp(需 b11742+)
llama-server -hf HuggingFaceBio/Carbon-X-GGUF:Q8_0 \
-ngl 99 -c 40960 --jinja \
--chat-template-kwargs '{"enable_thinking": false}' \
--temp 0.6 --top-p 0.95 --top-k 20 --min-p 0
只有笔记本、显存不到 16GB 的人,Q4 也许能挤进去,但 DNA 任务掉点要自己测。文件大小只是权重,按「内存刚好等于文件」下单,长窗任务很容易中途爆。
04
PART
冷水:别写成诊断终点
COLD WATER

模型卡 Limitations 写在最前:Carbon-X 是研究起点,未经临床验证,不应用于医疗决策。
基因数据高度敏感。本地下载、推理 API、Endpoint、Spaces,数据处理方不一样;患者或未发表序列进公共 Demo 前先搞清会不会出域。
精确操作不可靠。可能数错碱基、搞混坐标;精确编辑交给代码。缺标注时可能编造序列身份或功能。
任务覆盖不均。剪切位点、组蛋白标记仍弱。长 DNA 生成会掉点——模型卡写它主要是读和解释已有序列,并不是按「设计新序列」系统训出来的;媒体「可写新 DNA」的想象请回到这句限制。
长输入也要泼冷水:mid-training 用的是 8,192 token 序列(大约对应数万碱基量级),后训练样例短于 16k;窗口标到 40,960,但远长于训练分布的输入,官方说还没系统评。
分数全部是官方设置下的自报。到 23 日早上,我还没看到成体系的第三方 DNA 榜把 Carbon-X 嵌进去复测。引用请写「官方自报」,别写成「业界实测第一」。IFEval 上它仍有通用助手能力(模型卡自报 prompt-level strict 79.3%),那是指令遵循,不是临床有效性。
和昨天 Flint 对照:Flint 的钩子是「笔记本速度」对上 BF16 约 80GB;Carbon-X 的钩子是「聊天框里读 DNA」对上「未临床验证」。开源权重先看你要它干什么,再看文件形态,最后看边界写在模型卡哪一行。
05
PART
谁该现在试,谁可以等
WHO SHOULD TRY
现在值得试:有 80GB 级卡或能舒适跑 Q8 的人,要在内网做序列解释原型;已在搭生物 Agent、需要 DNA 专用工具;接受输出必须人工或实验复核的研究团队;关心数据不出域的院所 IT。
可以先等等:想直接用于患者报告或临床路径的人;只有消费级小显存又指望「一贴就出可靠致病结论」的人;不做序列的通用闲聊应用;等第三方复测和湿实验对照再定预算的人。
照着做:① 有 80GB 卡走 vLLM / Transformers BF16;16GB 左右优先 Q8_0 + llama.cpp b11742+。② 关闭 thinking,采样用官方默认。③ 序列带注释,变异给参考和突变。④ 精确操作配对代码。⑤ 产品文案写明非诊断。⑥ 文中分数均为官方自报。⑦ 敏感序列默认本机,慎用公共 Demo。
很多人卡在下一步:模型跑起来了,却写不出能报价的交付——比如给实验室搭内网序列解释台,过关标准怎么写、复核谁来签。
你会先在本机用 Q8 跑通一条公开示范序列,还是等第三方复测和实验对照再动手?评论区聊聊。
官方入口:HuggingFaceBio/Carbon-X ;GGUF:HuggingFaceBio/Carbon-X-GGUF 。
CHECKLIST
对机器 → 挑一档文件 → 关闭 thinking → 带注释提问 → 代码核实精确操作 → 文案写明非诊断
出处:Hugging Face 模型卡 HuggingFaceBio/Carbon-X 与 Carbon-X-GGUF(2026-10-22/23 查看)、X @LoubnaBenAllal1 / @_lewtun(10月22日)、TNW / Business Insider 同日报道(WIRED 经媒体转述)。文中分数与成本均为官方自报或估算。
往期 · 接着看
Recursive开源Flint:说笔记本125token/秒,BF16原版约80GB
Ornith开源122B说单卡能跑:原版250GB,真正塞进80GB的是4bit版
MiniMax揭晓Space Bunny:M3.1 Flash官方自报200T+,权重要到10-23
「AI商业实战」新人邀请礼遇 ¥25,进圈可领两张短卡:「交付定义卡」把买家、交付文件、过关标准、改稿轮次一次写清;「一周试跑清单」按天跑通一个最小交付闭环。不保证接单,帮你少走弯路。
工具会用了,下一步是把它变成能交付的活。「AI商业实战」里有人在做本地模型部署和科研工具链的实单,欢迎来交流。
点文末「阅读原文」开启 AI 实战交流
觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING