AI for Science浪潮正持续驱动科研范式革新。依托深度学习强大的分子表征与建模能力,分子性质预测、药物虚拟筛选、量子化学计算、新材料设计等生命科学、先进材料前沿场景实现研发效率大幅提升,其中DeepChem是AI4S领域最受欢迎的开源深度学习工具链之一。通过DeepChem-Ascend完成框架深度适配,业务代码无需改动即可将模型迁移至昇腾NPU,依托CANN高性能算子与HCCL多卡分布式能力显著提升训练效率,加速药物筛选、新材料设计等科研场景从“能运行”走向“高性能”,为AI4S前沿创新释放昇腾算力价值。
DeepChem是一个高质量的开源深度学习工具链,致力于推动深度学习在药物发现、材料科学、量子化学和生物学等领域的广泛应用。该项目为科学计算领域提供了端到端的机器学习解决方案,从数据加载、特征工程到模型训练和评估,覆盖了完整的科学AI工作流。DeepChem在GitHub star数约7k,声明使用DeepChem套件的企业和高校超过33家(包括IBM Watson等)。其中,基于DeepChem的ChemBERTa模型(分子表示学习),在HuggingFace上月下载量超过20w。
全流程覆盖:数据加载、特征工程、模型训练、评估与部署,覆盖完整科学AI工作流
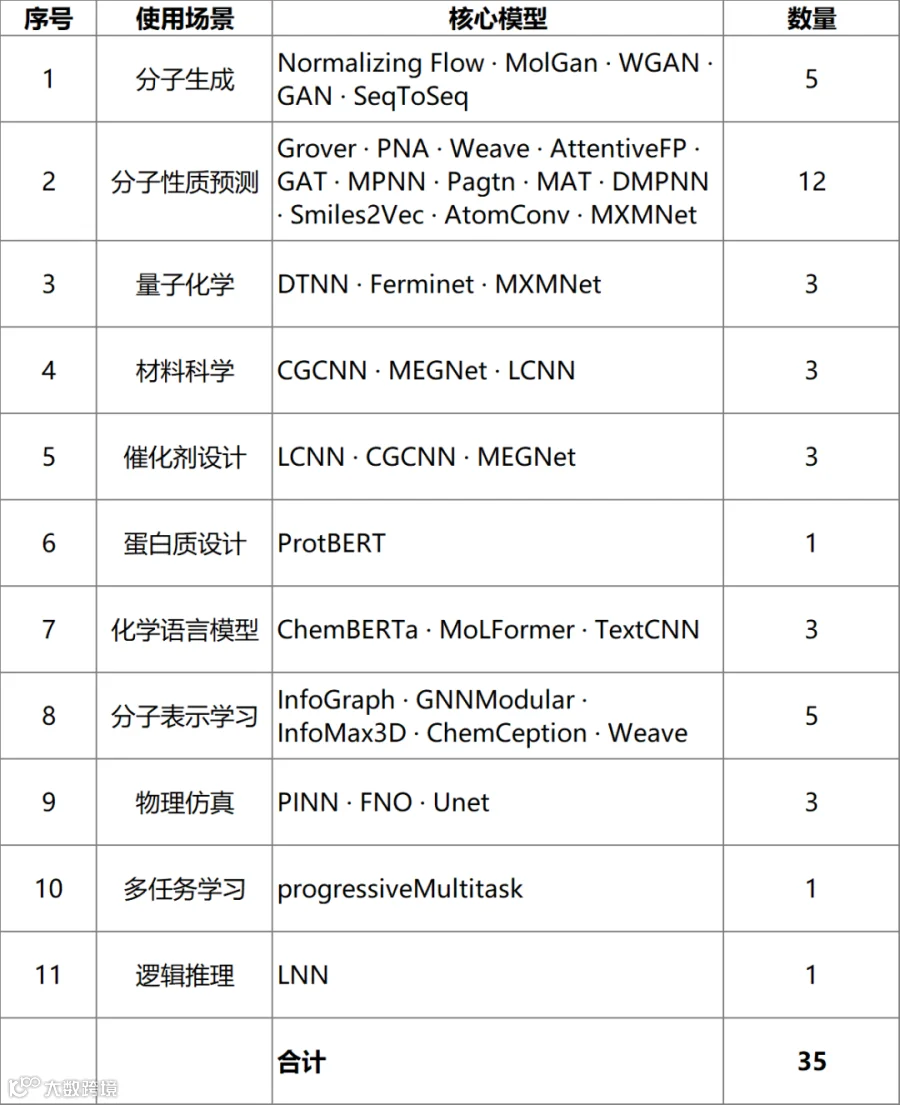
模型丰富:已完成35个模型昇腾NPU适配,覆盖分子生成、分子性质预测、量子化学、材料科学等11大场景
数据集生态:提供MoleculeNet基准数据集集,包含Tox21、Delaney、QM9等化工领域标准数据集
框架兼容:提供PyTorch实现,支持PyTorch Lightning分布式训练框架
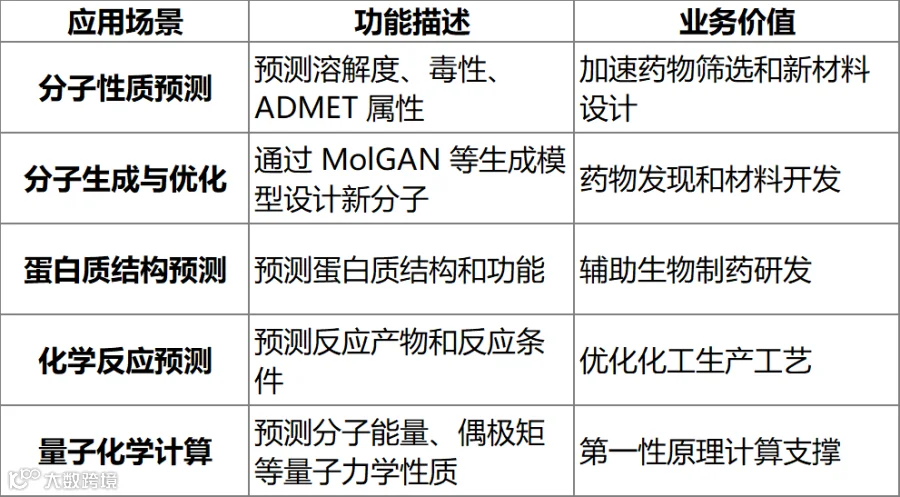
DeepChem在AI4S领域提供了大量SOTA模型,支持以下典型场景:
长期以来,DeepChem框架原生仅支持CPU/GPU运行,AI4S模型难以直接在昇腾AI软硬件平台高效运行,限制了分子智能与科学计算领域的自主创新应用落地。为进一步拓宽AI4S算力生态适配边界,充分释放昇腾AI基础软硬件在基础科研场景的算力效能,DeepChem适配昇腾专项攻坚项目已启动。该项目旨在完成DeepChem框架与昇腾AI基础软硬件平台深度适配,实现各类模型在昇腾NPU上高效、稳定运行,为AI4S前沿科研创新提供更强算力支撑。
DeepChem-Ascend的设计沿用DeepChem原有的分层架构,实现层面遵循开闭原则,只扩展,不修改,既保留了DeepChem原有的灵活性,也为昇腾AI基础软硬件平台提供了统一、高效、可扩展的运行支持。
框架适配:锁定基类设备检测链,一键改写派生全局生效,model.to(device)触发H2D迁移,算子自动路由
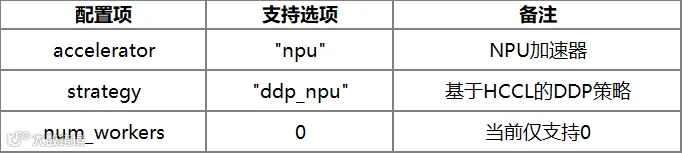
Lightning分布式训练适配:在Lightning插件层做扩展,而非修改DeepChem核心或Lightning源码;插件扩展方式使NPU适配对上层用户透明——只需传accelerator="npu", strategy="ddp_npu"即可
NPU加速器插件:提供NPUAccelerator类,通过torch.npu.is_available()自动检测设备
DDP分布式策略:提供NPUDDPStrategy类,使用HCCL作为分布式通信后端
NPU加速器插件实现:
class NPUAccelerator(Accelerator):"""Ascend NPU 硬件加速器"""@staticmethoddef is_available() -> bool:return torch.npu.is_available()
DDP分布式策略实现:
class NPUDDPStrategy(DDPStrategy):"""专为 Ascend NPU 优化的 DDP 策略"""def __init__(self, process_group_backend: str = "hccl", **kwargs):# 使用 HCCL 作为分布式通信后端os.environ.setdefault("HCCL_WHITELIST_DISABLE", "1")
DeepChem-Ascend的目标不止是让模型在昇腾上“跑起来”,更是依托昇腾软硬件深度协同让模型“跑得更快”。
NPU原生算子加速
借助昇腾CANN高性能算子库,模型核心计算自动路由至NPU算子高效执行。分子图模型中的SpMM稀疏矩阵乘、ChemBERTa等Transformer模型的Attention/GEMM等算子均获得NPU原生加速,相比CPU显著降低单步训练耗时。
多卡分布式训练近线性扩展
基于HCCL通信后端的DDP策略,训练性能随卡数显著提升。以ClinTox数据集(1184样本)分子毒性预测、MultitaskClassifier模型30 epoch训练为例,实测指标如下:
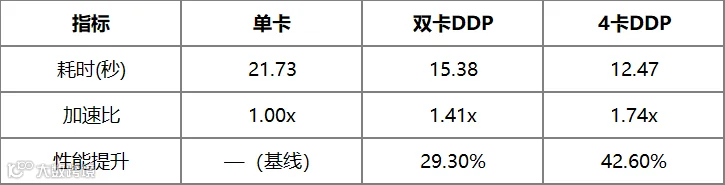
数据解读:4卡DDP训练耗时由单卡21.73s缩短至12.47s,加速比达1.74x、性能提升42.6%。
目前DeepChem-Ascend已完成35个模型的NPU单卡验证适配,覆盖分子生成、分子性质预测、量子化学、材料科学、催化剂设计、蛋白质设计、化学语言模型、分子表示学习、物理仿真、多任务学习与逻辑推理共11大场景:
DeepChem-Ascend通过集成PyTorch Lightning实现分布式训练能力,已支持单机多卡DDP训练:
ClinTox数据集用于预测分子在临床试验中的毒性和FDA批准状态,是药物安全性评估的标准基准。以下示例展示基于DeepChem-Ascend在NPU上进行分子性质预测训练:
# 安装deepchem-ascend二进制包pip install "deepchem-ascend[torch]"# 进入容器后验证 NPU 可用python -c "import torch; import torch_npu; print(torch.npu.is_available())"import osimport deepchem as dcfrom deepchem.models.lightning.trainer import LightningTorchModelimport torch# 获取分布式训练环境变量rank = int(os.getenv("RANK", "0"))world_size = int(os.getenv("WORLD_SIZE", "1"))local_rank = int(os.getenv("LOCAL_RANK", "0"))print(f"当前进程 RANK: {rank}, 全局进程数: {world_size}, 本地设备号: {local_rank}")# 加载 ClinTox 数据集(临床试验毒性预测)tasks, datasets, _ = dc.molnet.load_clintox()_, valid_dataset, _ = datasets# 创建多任务分类模型model = dc.models.MultitaskClassifier(n_tasks=len(tasks), # 任务数量n_features=1024, # 特征维度layer_sizes=[1000], # 网络层结构dropouts=0.2, # Dropout 比例learning_rate=0.0001, # 学习率device="npu", # 指定 NPU 设备batch_size=16 # 批次大小)# 配置 Lightning 分布式训练器trainer = LightningTorchModel(model=model,batch_size=16,devices=world_size, # 使用全部 NPU 设备strategy="ddp_npu", # NPU 分布式策略accelerator="npu", # NPU 加速器log_every_n_steps=1, # 日志记录频率fast_dev_run=False # 正常训练模式)# 执行训练trainer.fit(valid_dataset, nb_epoch=30, num_workers=0)
基于ClinTox数据集(1184样本),使用MultitaskClassifier模型进行30 epoch多卡DDP训练:
# 单卡训练torchrun --nproc_per_node=1 --master_port=29500 test_train.py# 单机 2 卡分布式训练torchrun --nproc_per_node=2 --master_port=29500 test_train.py# 单机 8 卡全量训练torchrun --nproc_per_node=8 --master_port=29500 test_train.py
多卡训练执行成功后输出:当前进程RANK信息、数据集加载状态、模型训练进度日志、训练完成确认。数据集仅1184样本,使用8卡DDP通信同步开销占比过高,效果不及4卡。建议小数据集分布式训练2-4卡效果更佳。
昇腾持续推动DeepChem在AI4S场景落地,现已完成35个模型NPU适配,覆盖11大应用场景。
其中,AttentiveFP、GAT等11个DGL图神经网络模型,依托DGL-Ascend项目实现NPU原生支持。该项目在DGL C++ Runtime层扩展AscendDeviceAPI,内置SpMM等核心图算子,使上层代码无需修改即可迁移至昇腾NPU。后续DGL-Ascend将合入CANN OpsGNN算子加速库,为DeepChem图模型提供更深层的性能优化与更广的硬件覆盖。
下一步将重点推进性能调优与精度对齐验证,欢迎分子智能与科学计算领域的开发者参与共建或反馈使用体验。
开源代码仓地址:
GitCode地址:
https://gitcode.com/AI4Science/deepchem-ascend