



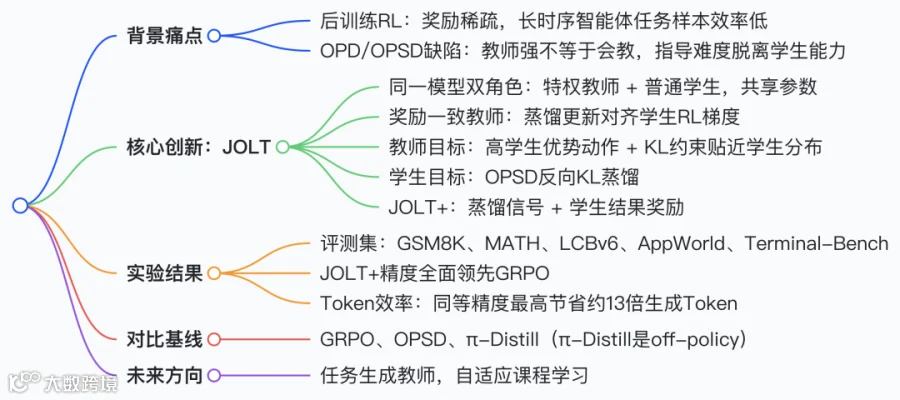
10 个关键问题 Q&A
-
Q:JOLT 全称是什么? A:Joint on-policy learning and teaching,联合在线策略学习与教学。 -
Q:JOLT 要解决什么核心痛点? A:自蒸馏里教师能力强,但给出的指导对学生来说太难、不匹配学生当前水平。 -
Q:JOLT 和 OPSD 最大区别? A:OPSD 只训练学生模仿教师;JOLT 同时训练教师,约束教师输出适配学生。 -
Q:什么是 “奖励一致教师”? A:教师带来的蒸馏梯度,和学生直接做 RL 的策略梯度方向一致,只差一个正缩放系数。 -
Q:JOLT 和 JOLT + 的差别? A:JOLT 只有教师目标 + 蒸馏损失;JOLT + 额外增加学生自身的结果奖励项。 -
Q:JOLT 学生是 on-policy 还是 off-policy? A:On-policy,使用学生自己生成的轨迹,这是和 π-Distill 关键差异。 -
Q:教师训练时 KL 惩罚项有什么作用? A:限制教师不要脱离学生动作分布太远,避免给出学生完全无法学习的捷径方案。 -
Q:主要测试了哪些任务? A:数学推理、代码生成、工具调用、长时序终端智能体任务。 -
Q:效率提升有多明显? A:MATH 任务同等精度下,相比 GRPO,JOLT 最多节约约 13 倍 Completion Token。 -
Q:文章提出的未来研究方向是什么? A:训练任务生成型教师,根据学生学习进度动态生成课程化训练题目。
01 引言
强化学习(RL)广泛用于大模型后训练,用来提升模型在复杂推理、长时序智能体任务上的能力。
标准流程里:模型反复尝试完成任务,每次尝试结束仅收到一个结果奖励,学习倾向选择奖励更高的动作。但单一结果奖励是稀疏学习信号,无法区分中间哪一步动作促成、或是破坏了最终结果。这种稀疏性严重限制样本效率;尤其高难度智能体任务,轨迹很长、成功样本极少。
在线策略蒸馏(OPD)是解决稀疏性的主流方案:用更强的教师模型,对学生自己生成的轨迹逐 token 给出指导,提供稠密奖励。 但教学本身也是一种能力:擅长解题的模型,未必擅长教学;它给出的反馈可能远超学生当前能力上限。 这引出核心动机:不只要训练学生模仿教师,同时训练教师,让它给出适配学生当前水平的引导。
本文提出 JOLT 方法。它基于在线策略自蒸馏(OPSD),同一个模型承担两个角色:
-
教师角色:可以访问特权信息(标准答案、验证过的解法) -
学生角色:无特权信息,只能正常做题 两个角色联合训练:学生遵循标准蒸馏目标;教师的优化目标,要求它给出的引导,对学生产生的更新方向,和学生直接做 RL 策略梯度方向保持一致。 两个目标共同作用,训练教师做到 “因材施教”,让学生可以在自己能力范围内从引导中学习。
实验证明:在数学推理、代码、智能体多类任务上,JOLT 同时提升模型精度、训练样本效率。
02 从稀疏奖励到稠密反馈
最基础的结果奖励 RL,优化期望回报目标:
\(J_{\text{RL}}(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}[R(\tau)]\) \(\tau\) 是策略 \(\pi_\theta\) 采样得到的轨迹,\(R(\tau)\) 是该轨迹回报。对应的策略梯度:
\(g_{\text{RL}}(\theta)=\nabla_\theta J_{\text{RL}}(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}\left[\sum_t R(\tau)\,\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]\) \(s_t,a_t\) 分别代表 t 时刻状态、动作。为降低采样估计方差,梯度一般写成优势函数形式:
\(g_{\text{RL}}(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}\left[\sum_t A_{\pi_\theta}(s_t,a_t)\,\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]\) 优势 \(A_{\pi_\theta}(s_t,a_t)\):在状态 \(s_t\) 下,动作 \(a_t\) 相对当前策略,能带来的超额期望回报。 GRPO(2402.03300)就是同类方案:把同 prompt 一组采样轨迹的回报均值作为基准,估算优势。
即便做了以上改进,基于结果奖励的强化学习依然存在监督稀疏问题,长时序高难任务尤为明显。越来越多工作引入额外信息,构造稠密学习信号。
OPD(2306.13649)就是代表:不再只从最终奖励学习;学生自己采样轨迹,更强教师对学生每一步动作打分。 教师策略 \(\pi_T\),\(\bar\theta\) 是生成轨迹时固定的学生参数快照。在 \(\theta=\bar\theta\) 处的局部梯度:
\(J_{\text{OPD}}\) 是反向 KL 蒸馏目标的负值;求梯度时教师策略、采样前缀固定。教师 - 学生对数概率比值,在每一个访问状态上都给出稠密信号,替代优势作为动作权重。
OPSD(2601.18734,在线策略自蒸馏)进一步去掉独立教师模型:同一个学生策略,在附加特权信息(标准答案、参考轨迹)时充当自己的教师。 但 OPSD 只训练学生模仿教师,没有任何机制约束教师输出对学生有用的信号。
03 联合在线策略学习与教学(JOLT)
JOLT 在 OPSD 基础上扩展:共享一套参数的模型,同时做「给出适配引导的教师」+「接收引导学习的学生」。
-
拥有特权信息的教师:在 KL 正则约束下,基于结果奖励学习,不能脱离学生分布太远 -
无特权学生:从教师给出的稠密蒸馏信号学习 -
JOLT:教师更新用教师自己生成的轨迹;学生更新用学生自生成轨迹、由教师打分 -
JOLT+:在蒸馏信号之外,额外叠加学生自身的结果奖励 
图 01:同一个策略,同时扮演教师与学生
训练教师:定义教师应该做什么
教师自己解题很强 ≠ 对学生的更新有用。 教师手握特权信息,可能走学生学不到的捷径、给出学生分布下几乎不可能出现的轨迹;或者在学生已经走偏之后,给出不可靠指导。 教师好坏,应该由它给学生带来的学习信号决定,而不是教师自身任务得分。
我们定义「奖励一致教师(reward-consistent teacher)」:它给学生带来的 OPD 蒸馏更新方向,和学生期望任务回报的 RL 策略梯度方向一致,只差一个正缩放系数。 理想教师 \(\pi_T^\star\) 满足:
\(g_{\text{OPD}}(\bar\theta;\pi_T^\star)=\frac{1}{\beta_T}\,g_{\text{RL}}(\bar\theta)\) \(\beta_T>0\) 为标量系数。 满足这个条件的理想教师形式:
\(\pi_T^\star(a\mid s,c)=\frac{1}{Z(s)}\,\pi_{\bar\theta}(a\mid s)\exp\left(\frac{1}{\beta_T}A_{\pi_{\bar\theta}}(s,a)\right)\) \(A_{\pi_{\bar\theta}}(s,a)\) 是学生后续动作优势;\(Z(s)\) 归一化常数,保证是合法概率分布。
从理想目标到教师优化目标
固定学生和状态s,训练教师逼近 \(\pi_T^\star\),等价最小化 KL 散度:
\(\min_{\pi_T}\text{KL}\big(\pi_T(\cdot\mid s,c)\,\|\,\pi_T^\star(\cdot\mid s,c)\big)\) 代入理想教师表达式,等价最大化:
\(\max_{\pi_T}\Big\{\mathbb{E}_{a\sim\pi_T(\cdot\mid s,c)}\big[A_{\pi_{\bar\theta}}(s,a)\big]-\beta_T\,\text{KL}\big(\pi_T(\cdot\mid s,c)\,\|\,\pi_{\bar\theta}(\cdot\mid s)\big)\Big\}\) 含义:鼓励教师选择学生视角下优势更高的动作,同时保持和学生动作分布接近。 \(\beta_T\) 控制 KL 惩罚强度:\(\beta_T\) 大,教师贴近学生当前行为;\(\beta_T\) 小,教师可以更大胆偏向高优势动作。
实用替代目标
上面目标依赖学生在每个动作之后的后续优势,这个量在训练时拿不到。 因此本文用教师自身轨迹的中心化回报作为替代代理:奖励项鼓励教师解出任务,KL 项约束教师不要偏离学生分布太远。
注意:这只是近似替代,教师回报 ≠ 学生后续优势。
\(\hat A_T(\tau)\):该教师轨迹回报,减去同批次教师轨迹回报均值; \(\text{sg}\) 是停止梯度算子:求梯度时,括号内的值固定不变,采样前缀、学生参考分布同样固定。
训练学生
学生更新是标准 OPSD 更新:学生自主生成任务轨迹;同一个模型带上特权信息,给学生每一个 token 打分。 学生目标惩罚学生策略和特权教师策略之间的反向 KL:
教师偏好的 token 被增强,教师认为概率低于学生的 token 被抑制。
合并联合目标
教师目标 + 学生蒸馏目标,构成 JOLT 总目标:
\(\beta_S\):控制学生蒸馏损失在总更新里权重的标量。
JOLT+ 在 JOLT 基础上,额外加入学生自身结果回报:把学生轨迹中心化回报加到蒸馏信号上,融合稠密教师监督 + 学生轨迹直接结果反馈;教师目标不变:
\(\hat A_S(\tau)\):学生轨迹回报减去同批次学生轨迹回报均值。
两种变体里:
-
教师、学生角色,各自在自己的上下文下生成轨迹 -
两个角色共享同一套策略参数,一起更新 下方附有单步训练伪代码 
图:JOLT 单步训练伪代码


04 实验
在数学推理、代码生成、工具调用、长时序终端智能体任务上评估 JOLT / JOLT+;使用不同基座模型、不同特权信息配置:
-
GSM8K:DeepSeek-V2-Lite,小学数学题;教师可看标准答案 -
MATH:Qwen3-0.6B,竞赛数学;教师拿到完整参考步骤解 -
LCBv6:Qwen3-8B,131 道代码题;教师拿到通过测试的模型解,无通过解时拿到执行反馈 -
AppWorld:Qwen3-4B-Instruct-2507,交互式智能体;教师看到之前尝试的摘要 -
Terminal-Bench:Qwen3-30B-A3B-Instruct-2507,终端命令智能体长时序任务;教师拥有私有验证信息
对比基线:GRPO、OPSD、π-Distill π-Distill 同样在单模型内部区分特权教师 / 学生,但教师目标不一样、学生更新是 off-policy,依赖教师生成轨迹,不是学生自己 rollout。
精度结果
✅ JOLT+ 在全部评测设置下平均分最高: 对比最强基线 GRPO:
-
GSM8K:+1.5pp -
MATH:+4.2pp -
LCBv6:+3.0pp -
AppWorld 状态测试通过率:+9.9pp
图 02:JOLT+ 在四个基准上均值最优
无学生直接奖励的原生 JOLT:GSM8K / MATH / LCBv6 精度高于 GRPO;但 AppWorld 上弱于 GRPO、π-Distill。
Terminal-Bench 2.1 是最长时序最难场景: JOLT+ 在所有 pass@k 指标全部领先:pass@1=10.96%,pass@32=34.83% 原生 JOLT 优于基座、优于 OPSD,但低于 GRPO;OPSD 在所有 k 上甚至弱于基座模型。
图 03:Terminal-Bench,JOLT + 在所有尝试预算下 pass@k 最高
Token 效率与缩放曲线
在 MATH 上,固定精度对比训练 token 开销:
-
JOLT 前期样本效率高,最终三方法里上限最高,接近 72% -
OPSD 小预算涨得快,但很快平台,封顶约 62% -
GRPO 起步慢,但持续提升,最高约 70%
以精度 63.44% 对齐对比: GRPO 需要 840 万处理 token;JOLT 拟合曲线仅 130 万,减少 6.5× 处理 token。 如果只统计生成 completion token(不计 prompt、特权上下文、额外优化步),同等精度下差距扩大至约 13 倍。 在 55%~65% 精度区间:JOLT 节省 9.5–14.4× completion token、4.3–7.4× 处理 token。
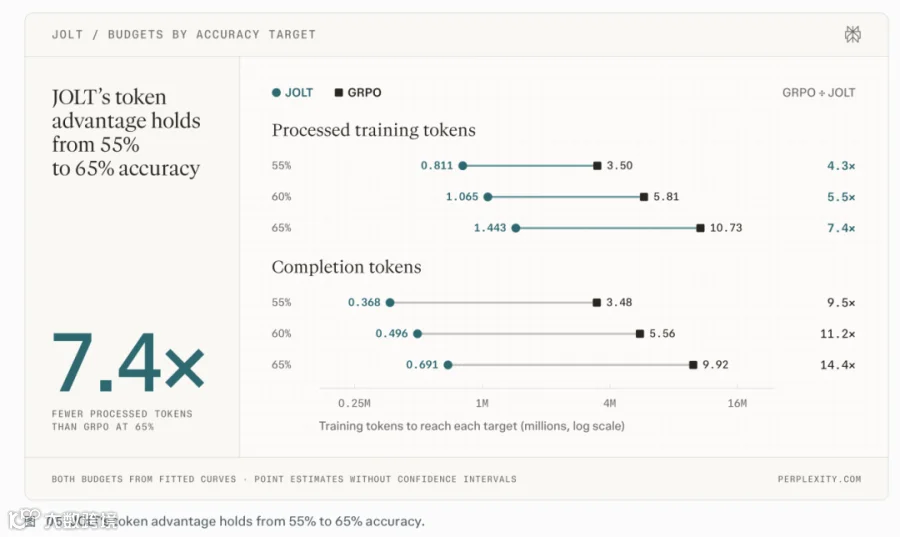
图 04:达到 GRPO 同等精度,JOLT 消耗 token 更少 图 05:55%–65% 精度区间内 JOLT 的 token 优势稳定
05 结论
拥有特权信息,只能让教师自己解题更强,不等于它能教会没有特权信息的学生。 JOLT 解决这个矛盾:教师的优化目标绑定学生当前行为,跟着学生水平调整教学方式。
联合训练同时提升精度与样本效率。带学生奖励的 JOLT + 相对 GRPO 增益:GSM8K+1.5pp、MATH+4.2pp、LCBv6+3.0pp、AppWorld+9.9pp、Terminal-Bench 2.1 pass@1 +2.7pp。 MATH 任务上,同等精度下原生 JOLT 相比 GRPO,completion token 少 13 倍、处理 token 少 6.5 倍(不叠加学生奖励)。
JOLT 让教师引导随学生能力同步演化。未来一个有意思方向:联合训练任务生成教师 + 解题学生,用学生学习进度动态生成适配课程任务,让合成题目可以响应学生当下学习状态。
详细内容见 arXiv:2610.10447;代码后续开源。
06 Citation
@online{perplexity2026AGoodTeacherMeetsTheStudentWhereTheyAre,
  author = {{Perplexity} and Randy Ardywibowo and Arnav Dalal and Jiantao Jiao and Jarrod Bryan and Claire Beamer and Jeremy Yang and Jerry Ma},
  title = {{A good teacher meets the student where they are}},
  date = {2026-10-21},
  url = {https://www.perplexity.ai/hub/blog/a-good-teacher-meets-the-student-where-they-are}
}