



10 个关键问题 Q&A
-
Q:开放权重和真正开源有什么区别? A:开放权重仅提供模型权重;真正开源同时开放权重、完整代码、训练数据,支持完整复现。 -
Q:开放模型的主要价值是什么? A:服务科研、支撑商业私有部署、分散 AI 控制权,避免少数企业垄断。 -
Q:国内开源模型快速发展的原因? A:争取国际影响力、低成本获客落地行业、DeepSeek-R1 带动赛道热潮。 -
Q:中美开源模型性能差距大概多少? A:国产开源距离闭源前沿约 3–5 个月,美国本土开源再滞后 3–4 个月,差距持续收窄。 -
Q:中美算力差距有多大? A:美国头部实验室总算力约为国内头部的 10–16 倍,是核心优势。 -
Q:大模型训练三阶段是什么? A:预训练、监督微调 SFT、强化学习 RL。 -
Q:现在训练算力消耗特点? A:RL 阶段算力消耗已经超过预训练阶段。 -
Q:什么是对抗蒸馏? A:抓取闭源 API 的输出与推理链,用来训练自己模型,存在灰色访问行为。 -
Q:讲座对蒸馏的核心判断? A:蒸馏效果被舆论高估,国内已有原生 RL 能力,单纯限制蒸馏会伤害开源生态。 -
Q:讲座最后三个治理核心问题? A:谁掌控最强 AI 技术?鼓励 / 约束哪些路线?开放 AI 平台能否有效管控?
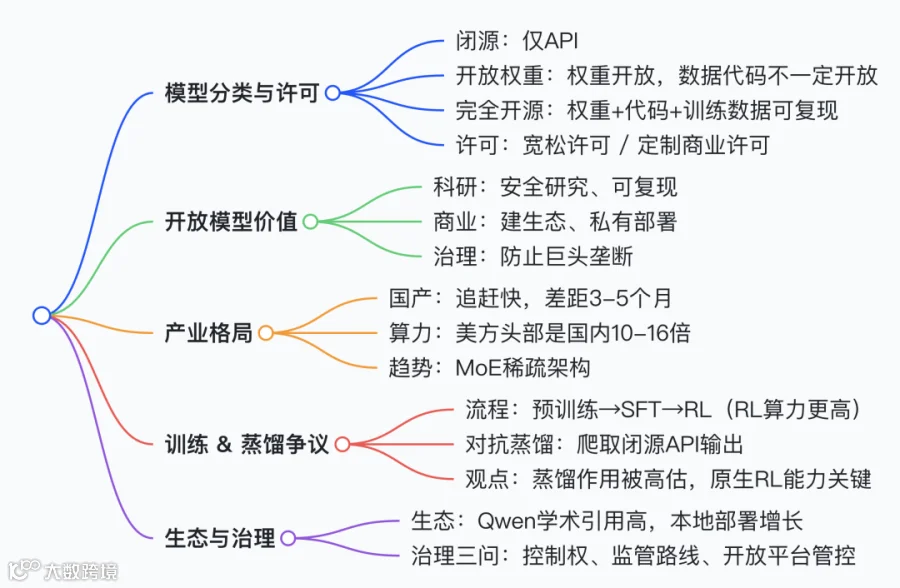
这份是 Nathan Lambert 于 2026‑10‑22 在哈佛大学 CS2881R 人工智能安全课程的 guest 讲义,围绕开源大模型(Open Language Models),从定义、动机、许可协议、产业格局、技术、中美对比、蒸馏争议、生态数据多维度展开分析。
一、概念区分:开放权重 vs 真正开源
- 开放权重(Open weights)
发布训练权重,任何人下载运行,但不一定开放训练数据与全部代码;代表:Llama、通义千问 Qwen、DeepSeek、Kimi、GLM。 - 开源(Open‑source)
权重 + 训练数据 + 完整代码全部公开,支持复现、修改、研究;代表 BLOOM、Pythia、OLMo、SmolLM、Tülu3。 -
开放是光谱概念,很多模型只开放部分资产,和 GPT、Claude 这类仅 API 调用的闭源模型形成对比。 - 许可证两类
-
宽松许可:MIT、Apache2.0、OpenMDW,允许商用、修改、再分发。 -
定制商业许可(不属于开源许可证):设置营收门槛、品牌署名、使用限制(如营收超过阈值需要签署额外协议、安全审查、品牌标注),这类条款大多尚未经过法庭检验。
二、为什么要做开放模型:历史与多方动机
追溯自由软件(伦理:用户拥有计算控制权)与开源(务实协作)两大思想传统。支持开放模型的群体动机包括:
- 商业资本视角
企业通过开源商品化互补产品,第二名企业借助开源争夺市场份额、获取软实力、压制竞争对手、规避监管风险。 - 科学研究
开放促进教育、科研创新与 AI 安全研究。 - 权力分散
避免顶尖 AI 技术被少数机构垄断。 - 技术自由价值观
作者本人做开源模型的动因:促进 AI 安全与长期创新;美国闭源模式削弱科研生态;普惠 AI 红利;个人职业差异化路径。Meta 等企业将开源 AI 视为重要商业策略,开源可以打造行业标准、化解监管压力。 同时开放模型催生新商业模式:企业基于开源底座做二次后训练,行业客户可以拥有私有模型、控制成本(例如法律行业基于 Kimi‑K3 做行业微调)。
三、中国实验室大规模投入开放模型的原因
-
希望自身技术在西方 AI 话语体系获得影响力;很早就开始开源实践,例如智谱 GLM 最早 2021 年就开源。 -
创业公司如 Moonshot 通过开放权重快速获取用户与行业采用。 -
DeepSeek‑R1 在 2025‑01 发布后,带动蚂蚁、美团、小米等更多国内机构入局开源大模型赛道。
四、性能现状:开源模型追赶闭源前沿
-
整体:中文开源模型相比闭源前沿差距约 3‑5 个月;美国本土开源模型再落后 3‑4 个月;性能差距正在持续收窄。 -
现象讨论 “benchmaxxing(刷榜)”:中国实验室更看重公开榜单;美国开源模型综合长尾能力更强;但顶尖国产开源(Kimi、GLM、DeepSeek)在很多任务上可以和闭源顶尖模型正面竞争。 -
算力格局:美国顶尖实验室总计算资源大约是中国头部实验室的10‑16 倍;OpenAI、Anthropic 算力规模大幅领先。 -
2026 新模型举例:小米 MiMo‑V2.6‑Pro、DeepSeek V4.1 Flash、MiniMax M3.1 Flash;2026 行业视角下万亿参数以下属于 “小模型”,大量采用 MoE 稀疏激活架构。
五、模型构建流程与蒸馏(Distillation)争议
训练三阶段
预训练 → 中期训练 / 监督微调 SFT → 强化学习 RL;如今 RL 消耗的算力已经超过预训练,需要大量 GPU 做 rollout 采样。
蒸馏争议重点
-
传统蒸馏:教师‑学生知识蒸馏;现在语境的蒸馏指抓取闭源 API 输出的推理链,训练自己模型,作者称之为 “对抗蒸馏”。 -
现象:中国有专门团队尝试绕过 API 限制获取隐藏推理 token;同时国内开发者通过各类灰色渠道访问被封禁的 Claude。 -
作者核心观点:不应过度放大蒸馏的作用 -
公开研究证据表明蒸馏并不会带来简单的巨大性能跃升,RL 的作用愈发关键。 -
即便禁止蒸馏,中国实验室依靠自身算力、数据、RL 工程,依然是强有力竞争者;快速跟随前沿本身比从零开拓前沿更加节省算力。 -
短期内缺少可行政策工具,过早打压会损害全球开源生态;API 厂商本身也刚刚开始加固反蒸馏防护。 -
小米 MiMo 公开完整 RL 运行仪表盘,是证明国内具备原生大规模 RL 训练能力的证据。 -
很多 API 访问流量未必用于模型训练,这一点尚不明确。
六、开源模型生态的实际使用情况
-
HuggingFace 下载量是并不完美但最常用衡量指标;同等性能下美国模型下载量是中国模型的 2‑5 倍,但国产开源下载体量巨大。 -
本地部署模型下载量持续加速增长。 -
科研影响力:作者扫描 37 万篇 arXiv 机器学习论文,Qwen 在论文中被引用频次已经接近 OpenAI 的 GPT 系列,开源模型深刻驱动学术研究。
七、讲座开篇提出的核心议题
-
谁应当掌控人类史上最强大的技术? -
应当鼓励、管控怎样的技术发展路径? -
开放技术平台是否具备可管控性?
核心结论:开放大模型具备重大科研、商业、权力分散价值;中国开源模型快速追赶闭源前沿,算力仍是美国最大优势;蒸馏被舆论高估,本土 RL 训练能力不可忽视;开放模型正在实实在在驱动产业落地与学术进步,但开放模型的治理仍是悬而未决的命题