




10 个关键问题 Q&A
-
Q:Shopify Sidekick 的模型分工是什么? A:前沿大模型负责商家对话、任务规划、工具调用;Token 密集的专项任务交给后训练开源子智能体。 -
Q:为什么选择 Nemotron 3.5 Lightning 做 GraphQL 子智能体? A:它是 MoE 模型,综合基线能力、推理速度、Megatron Bridge 适配性最优,后训练后效果超越前沿模型。 -
Q:什么是 LLM 裁判模型? A:用 GEPA、ACE 优化器调优,对齐人工标注,自动评估每一轮模型、提示词改动效果。 -
Q:AIPerf 的作用? A:Dynamo 内置压测工具,回放线上流量,验证多轮对话、缓存命中,提前评估推理性能。 -
Q:自愈机制如何生成训练数据? A:裁判识别失败样本,前沿模型给出提示线索仿真重试;修复成功后脱敏加入训练集,无需全部人工标注。 -
Q:Megatron Bridge 解决什么痛点? A:不用改写模型代码,直接加载 Hugging Face 权重接入 Megatron Core,简单配置即可多机分布式训练。 -
Q:Blackwell 对比 H200 收益如何? A:同一份 FP8 后训练任务,8 卡 B300 快 1.86 倍,GPU 小时消耗减少 46%;SimGym 仿真在 B200 提速 4.5 倍。 -
Q:GraphQL 任务最终指标有哪些? A:6 轮迭代后得分 74.5,中位数延迟 0.87s,P99 速度提升 8 倍,部署成本降低 90%。 -
Q:这套方案整体成本收益? A:自研后训练模型自托管,对比商用前沿模型接口,成本普遍降低 90%–98%。 -
Q:这套飞轮的核心复利逻辑是什么? A:人工标注持续校准裁判,线上流量源源不断产出训练样本,NVIDIA 软硬件持续压缩每一轮迭代的时间与成本。
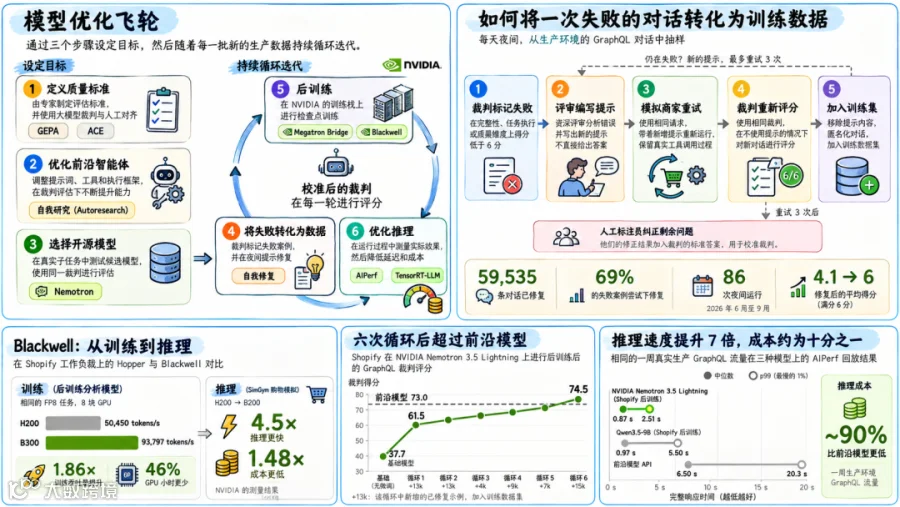
Sidekick 的前沿大模型会把高 Token 消耗的任务交给开源模型,由 Shopify 做后训练并自主部署。下文介绍这套搭建闭环,以及 NVIDIA 的模型、软件和 GPU 如何让每一轮迭代更快、成本更低。
Shopify 的 AI 商业助手 Sidekick(https://www.shopify.com/ca/sidekick)依托前沿大模型和商家对话、规划任务、调用工具。针对专项工作,它会把任务交给子智能体,其中多个子智能体基于开源模型,由我们针对单一任务做后训练。
以 GraphQL 子智能体为例。当商家提问:“哪些商品快要缺货?”,它会读取 Shopify API 规范、查阅文档、编写并执行查询语句,最后返回结果。这类任务上下文开销巨大:子智能体每输出 1 个 Token,就要读取约 40 个 Token;而前沿大模型的接口是按全部 Token 计费的。
针对这个子智能体,我们基于 NVIDIA Nemotron 3.5 Lightning做后训练,打造了专属任务专家模型。在该任务上,它的评测得分略高于前沿大模型,响应速度提升 7 倍,部署成本降低约 90%。同时因为权重由 Shopify 自主掌控,我们可以在自有 GPU 上部署,自主控制模型迭代节奏。
这套模型的构建闭环是【Sidekick 持续学习闭环】(https://shopify.engineering/sidekicks-continual-learning-loop),并叠加了硬件优化设计。
模型优化飞轮
先完成三步基线设定,之后每接入一批新生产数据,就循环迭代。图中标注绿色的部分为 NVIDIA 技术组件。 所有任务专家模型都遵循统一流程:
1. 定义质量标准
产品专家把业务需求转化为评分细则。GraphQL 任务的评分维度包含完整性、执行结果、回复质量。两位专家对同一段对话的标注一致性作为基准;我们使用 GEPA、ACE 优化器调优 LLM 评测裁判模型,直到它和预留人工标注的对齐水平达标。此后,这个裁判模型会评估每一次智能体改动、候选模型与训练实验。
2. 优化前沿大模型基线智能体
在引入开源模型之前,我们先把前沿大模型版本的智能体优化到上限。一套自动研究闭环(https://shopify.engineering/autoresearch)每次只对提示词、工具描述、控制逻辑做微小改动;只有裁判模型评分提升时,改动才会保留。优化后的前沿智能体,就是开源模型需要追上并超越的标杆。
3. 挑选开源基座模型
我们不做预训练。在真实子智能体链路里,搭配相同工具与裁判模型,对 NVIDIA Nemotron 等开源模型做实测评估,综合考量基线效果、推理速度,以及在 NVIDIA Megatron Bridge(我们的训练框架)中的适配能力。GraphQL 场景最终选用 Nemotron 3.5 Lightning:一款混合专家模型,总参数量 300 亿,每个 Token 激活 30 亿参数。
4. 推理性能优化
我们从项目初期就评估部署性能:如果模型在线上速度不达标,后训练就没有意义。使用 NVIDIA Dynamo 内置开源压测工具 NVIDIA AIPerf对所有负载做基准测试,用合成文本回放线上流量轨迹,规避客户原始数据。Shopify 也贡献了 AIPerf 多轮测试的支持代码,让多轮对话测试可以像真实线上流量一样命中服务端前缀缓存。
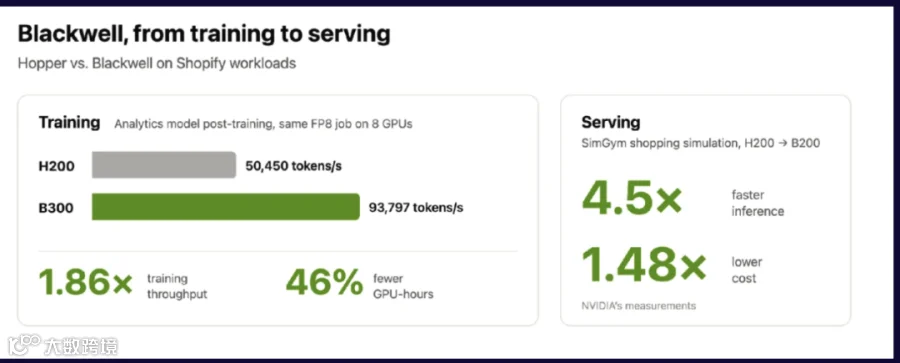
基于测试结果选择推理栈。针对批量任务「买家画像」,我们对比了 vLLM、SGLang、NVIDIA TensorRT-LLM,TensorRT-LLM 的单 GPU 吞吐最优。NVIDIA 实测数据显示:我们的购物仿真器 SimGym 在 Blackwell B200 上运行速度是 H200 的 4.5 倍,单位成本下降 1.48 倍。
5. 把失败样本转化为训练数据
自愈机制可以把线上失败对话自动转为训练样本。最近 86 轮夜间迭代中,它修复了 69% 的待处理失败案例。
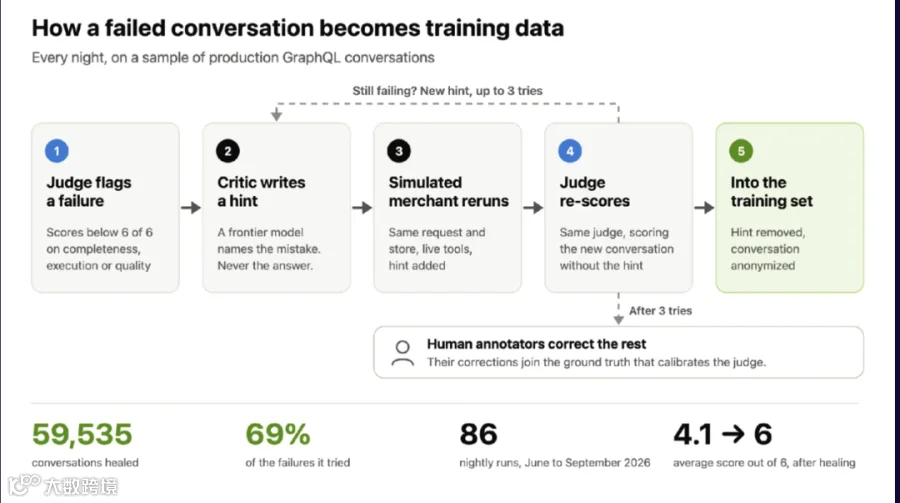
每晚,裁判模型会抽样评估线上 GraphQL 对话;结果不达标的样本送入自愈流程。由前沿大模型担任评审,只生成提示线索(不直接给出正确答案),仿真商家基于这条线索重新发起请求。如果裁判判定重试通过,就剔除提示线索、脱敏对话,加入训练集;如果失败,评审最多重试 3 次。
在最近 86 轮夜间任务里,自愈流程一共修复 59535 条 GraphQL 对话样本,覆盖 69% 的失败案例;剩余样本由人工标注修正,人工结果同步加入真值集,持续校准裁判模型。
6. 在 Blackwell GPU 上完成后训练
后训练依托 NVIDIA Megatron Bridge:无需改写模型代码,即可把标准 Hugging Face 权重接入 NVIDIA Megatron Core 训练库;依托 Nebius 平台,仅调整配置就能实现多机分布式扩容。Blackwell 降低了迭代成本:同样一份 Analytics 模型 FP8 后训练任务,8 张 B300 GPU 训练速度比 8 张 H200 快 1.86 倍,GPU 小时消耗减少 46%。训练完成后裁判模型评估新权重,飞轮继续循环。
Hopper(H200)与 Blackwell(B300/B200)在 Shopify 负载对比:训练侧是 Analytics 模型 FP8 后训练任务(8 卡);推理侧为 SimGym 仿真负载(NVIDIA 实测)
GraphQL 任务效果
Nemotron 3.5 Lightning 的 GraphQL 裁判得分随 6 轮飞轮迭代提升,每一轮都注入自愈样本。
-
开箱基线:Nemotron 3.5 Lightning 得分 37.7;前沿大模型基线 73 -
第 1 轮迭代:提升至 61.5 -
6 轮迭代、累计 61000 条自愈样本后:后训练模型得分 74.5,超过前沿基线
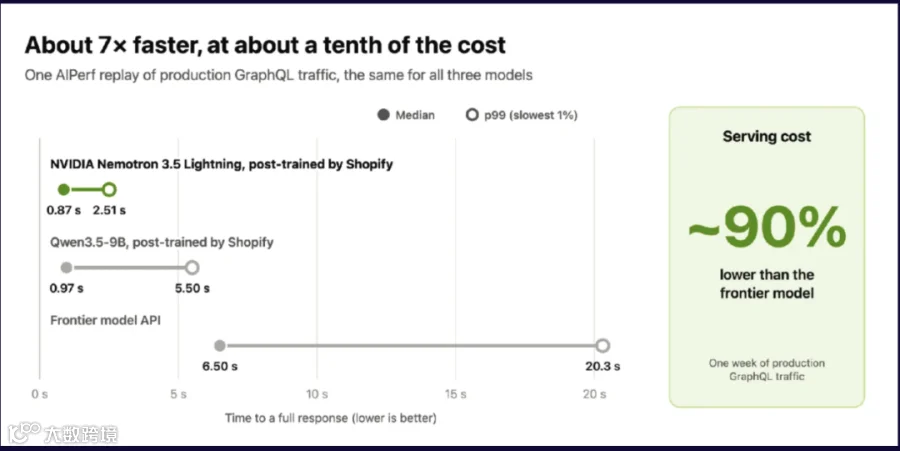
AIPerf 回放线上 GraphQL 流量压测结果:中位数、P99 响应耗时,以及相对前沿模型的部署成本。 后训练模型速度优势显著:回放真实流量时,Nemotron 中位数响应耗时 0.87s,前沿大模型接口为 6.50s;最慢 1% 请求(P99)的完成速度快 8 倍。同时它优于另一款同量级后训练开源模型 —— 后者中位数耗时接近,但 P99 延迟高出两倍以上。
该流量场景下,部署成本相比前沿模型降低约 90%。Shopify 所有自研后训练模型,自托管方案相比商用前沿模型接口,部署成本普遍下降 90%–98%。
前沿大模型做决策,专家模型提效率
前沿大模型保留它最擅长的工作:和商家交互、规划并决定调用哪些工具。高 Token 开销的专项任务交给我们自主可控的开源专家模型。飞轮每转一圈都形成复利:人工标注优化裁判模型、线上流量持续扩充训练集、新一代 NVIDIA 软硬件让每一轮迭代更快更便宜。
致谢 NVIDIA Megatron Bridge、AIPerf、TensorRT-LLM、Nemotron 团队,CentML(现已并入 NVIDIA)团队以及 Nebius。本文改编自 2026 柏林 GTC 大会 Shopify 分享。


作者:Andrew McNamara、Logan Vegna 发布时间:2026-10-21