


10 个关键问题问与答
-
EmbeddingGemma2 和初代最大差别是什么? 初代只支持文本;EmbeddingGemma2 原生支持图像、音频、视频、代码多模态嵌入,上下文扩大 4 倍,模块化可按需加载编码器。 -
许可证是什么?可以商用吗? Apache2.0 许可,允许商用,开放权重。 -
总参 740M,为什么纯文本只需要 270M? 模块化设计,视觉、音频编码器是独立可选模块,不使用音视频时不用加载这部分参数。 -
MRL 嵌套表征有什么实际好处? 向量可以降维,768 维降到 128 维,向量数据库存储、内存开销下降,检索速度提升,同时尽量保留语义信息。 -
8K 上下文能处理多少音视频? 最多 5.5 分钟音频、29 张图片或 58 帧视频,也支持图文音混合交错输入。 -
端侧内存占用大概多少? 量化后 Pixel11 Pro,纯文本约 191MB,完整多模态版本约 567MB。 -
适合哪些业务场景? 本地知识库 RAG、代码库语义检索、相册 / 媒体库跨模态搜索、视频片段定位、离线文件检索、多模态数据分类路由。 -
可以和 Gemma4 一起跑端侧 RAG 吗? 可以。两者共享 tokenizer 与音频编码器,联合部署内存开销更低,是官方主推组合。 -
有哪些推理框架支持? Ollama、vLLM、SGLang、transformers、sentence-transformers、MLX、GGUF,浏览器 WebGPU 也支持。 -
能微调吗? 支持微调,Unsloth 提供配套微调文档,可针对私有多模态数据做领域适配。
发布时间:2026-10-06 | 阅读时长:5 分钟 作者:Sahil Dua、Henrique Schechter Vera(Google DeepMind 研究工程师)
概述
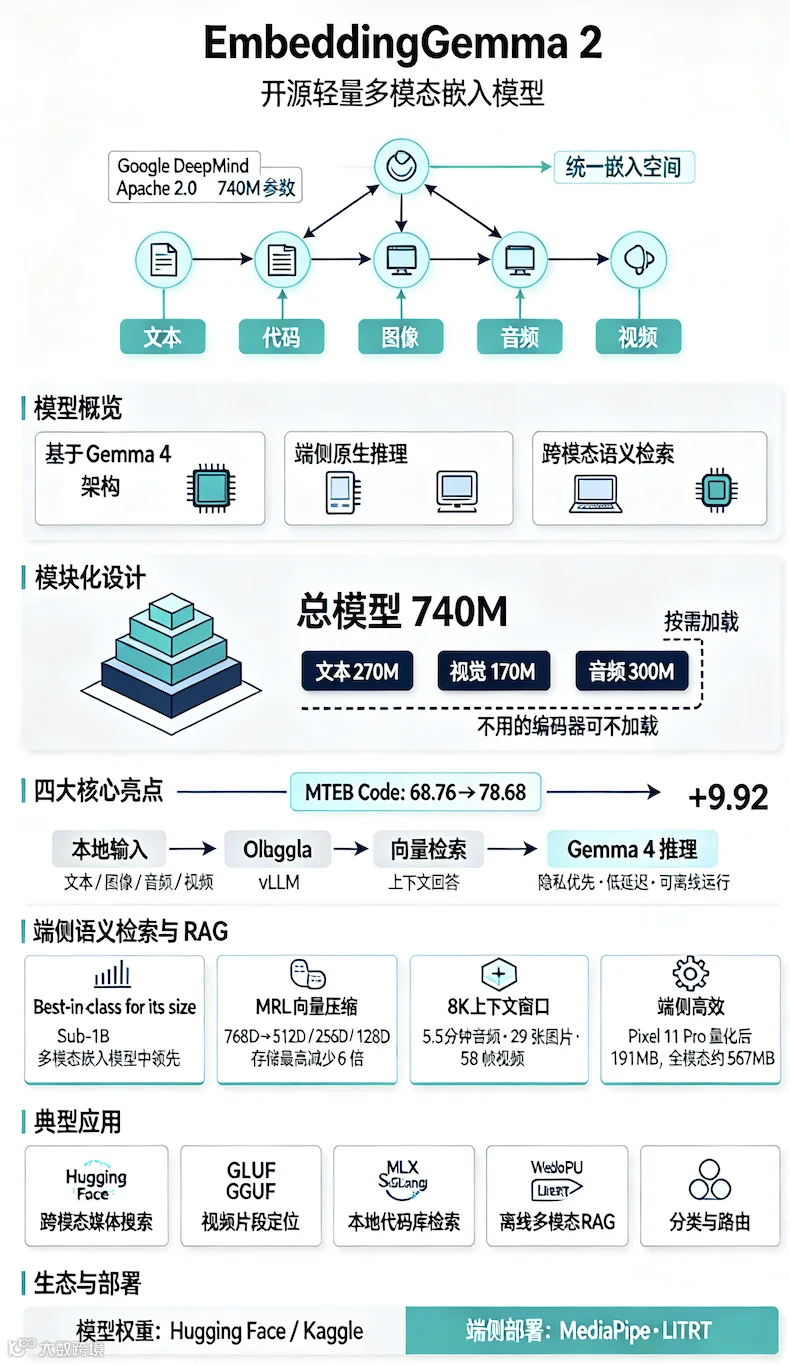
EmbeddingGemma 2 是端侧多模态嵌入领域能力最强的开源模型,原生支持文本、图像、音频、视频,把不同模态数据映射到同一个向量嵌入空间。 去年谷歌发布初代 EmbeddingGemma,主打轻量高质量文本嵌入,支持在消费端硬件上做信息检索、搜索。初代下载量超 2000 万,大量开发者用于端侧检索、隐私优先的 RAG 系统。
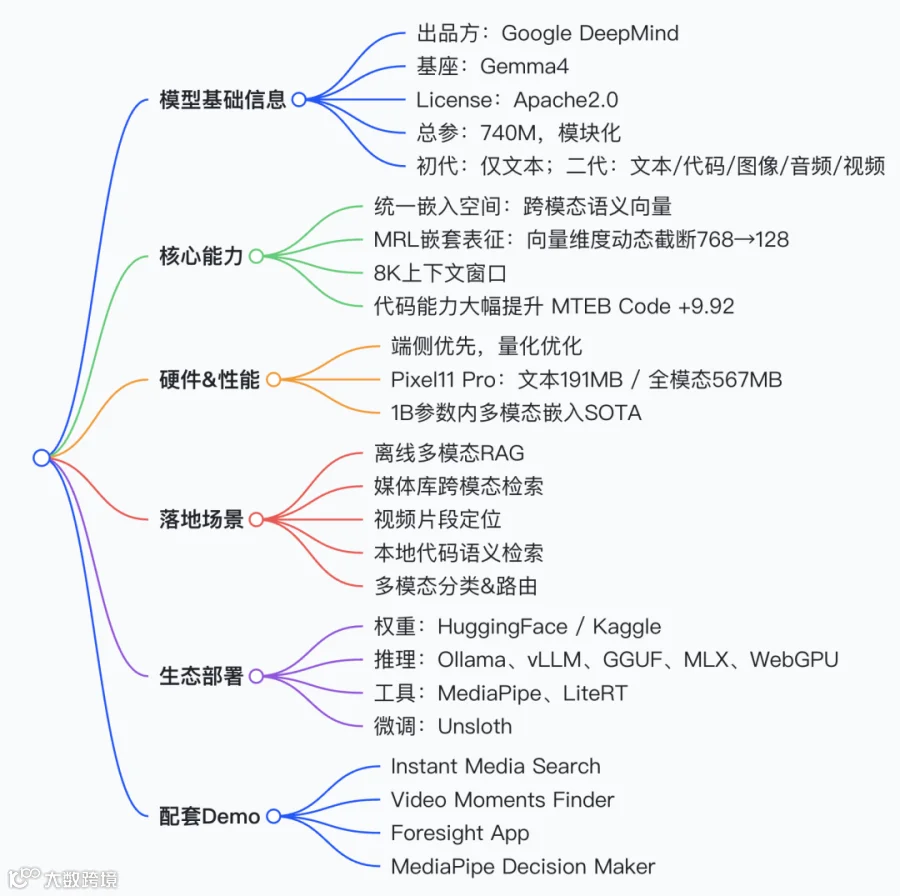
本次发布的 EmbeddingGemma 2 在 Gemma 4 架构基础上开发,采用商业友好的 Apache 2.0许可证,总参数量 7.4 亿,专为端侧推理优化。它可以实现:语音备忘录检索视频片段、用文本查询在大量录音里定位片段,单模型原生处理多模态。底层技术和 Gemini Embedding 同源。
特性
- 同尺寸下顶尖性能
在 10 亿参数以内的多模态嵌入模型中,MTEB Code、MAEB 等基准评测成绩领先;在文本、视觉、音频任务上,性能持平甚至超过很多更大规模模型。代码能力相比初代大幅提升:MTEB Code 分数从 68.76 提升至 78.68(+9.92 分),适合本地代码库索引、代码语义检索、代码智能体检索。 - 模块化架构
纯文本工作负载仅需 2.7 亿参数;视觉编码器可选(1.7 亿参数)、音频编码器可选(3 亿参数),按需启用,不必加载全部模块。 - Matryoshka 嵌套表征学习(MRL),存储高效
输出向量维度可动态截断:768 维 → 512 / 256 /128 维,本地向量库存储开销最多降低 6 倍,内存占用显著减少。 - 端侧硬件优化
量化后在 Google Pixel 11 Pro 上:纯文本权重活跃内存最低约 191MB;完整多模态模型约 567MB,资源受限设备也能高效运行。 - 更长上下文窗口:8K token
是初代 EmbeddingGemma 的 4 倍。本地硬件可一次性处理最长 5.5 分钟音频、29 张图片、58 帧视频,或是图文音视频交错混合输入。
在 10 亿参数以下模型中,图像、视频、文档、音频任务的每参性能创下新标杆,部分指标超越参数量两倍以上的专用单模态嵌入模型。完整评测指标可查阅 model_card 文档。
典型场景:完全离线端侧语义检索、路由与召回
向量在本地生成,保障数据隐私、降低延迟,可构建完全离线的跨模态检索。 搭配 Gemma 4 生成模型,搭建端侧 RAG,理解复杂多模态数据。由于两者基于 Gemma4、共享分词器与音频编码器,联合部署内存占用更低。
示例 Demo:
-
Instant Media Search:文本 / 图片检索媒体库,按语义相似度匹配 -
Video Moments Finder:文本 / 音频查询定位视频里的特定片段 -
Foresight App:EmbeddingGemma2 做本地文件检索 + Gemma4 做推理 -
MediaPipe Decision Maker:基于多模态上下文构建实时分类、路由、预测引擎
可基于 LiteRT 构建端侧检索与 RAG 系统。
上手部署与生态
模型下载
HuggingFace、Kaggle 可获取权重;Gemini Enterprise Agent Platform Model Garden 即将上线。 LiteRT 社区提供端侧专用优化版本。
端侧部署方案
-
MediaPipe:开箱即用的嵌入、检索、决策方案 -
LiteRT-LM:自定义模型集成 -
浏览器:transformers.js/ WebGPU 版本
开发工具生态
transformers、sentence-transformers、mlx-vlm、vLLM、GGUF、SGLang、Ollama、LMStudio;向量库推荐 Qdrant。 微调方案参考 Unsloth 文档。
文档资源
开发者指南、API 文档、sentence-transformers 推理 / 微调教程。