

概述:继上次在 H700 端侧设备(16GB 显存)上实测 JEV-9B 之后,我们又拿到了另一个决策模型 StartLux-Decision-v1.1-4B-AutoThink——体量只有 4B,却带着一套独特的"自信才秒答、不自信就思考"的门控机制。我们用完全相同的测试方案(相同的冒烟用例、相同的 B站/地图/携程三站点真实任务、相同的校验器)让它和 JEV-9B 打了一场对台赛。结果出乎意料:这个 4B 小模型不仅全部通关,单步决策还快了 10 倍。本文是全部实测数据、录屏与思考。
〇、先说结论
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
一、这个模型是什么:会"掂量"的决策模型
1.1 先回顾上次的背景
上一次我们实测了 JEV-9B:用 LoRA 适配器在 9B 骨干上外挂一个"快思考"决策头,看截图从候选动作里选一步,单次前向出概率。这套"System 1 + System 2"双系统设计的核心是——简单决策别写小作文。
StartLux-Decision 是同一个赛道、不同的技术路线。它问了一个更进一步的问题:模型什么时候该"想一想"?
1.2 AutoThink:自信就秒答,不自信才思考

机制如图。每次决策,模型先单次读出所有候选的概率分布,然后看最高概率过没过门限(默认 0.6):
-
过了:直接输出答案。一次前向,官方 H200 数据 30~100 毫秒; -
没过:同一份权重写一段不超过 4096 token 的思考,读完再答一次,最终答案 = 0.25 × 第一次 + 0.75 × 第二次。
也就是说,JEV 把"快慢"拆成两个模式(外挂 LoRA 切换),StartLux 把"快慢"压进一个模型的门控。前者按请求路由,后者按置信度自适应。
另外两个值得注意的设计:
-
none_probability(拒识):每个选择回答都附带一个"以上都不是"的概率。官方建议 0.2 以上就该告警——当所有候选都不对时,它选择说"我不知道该选什么",而不是硬选一个错的。这是 JEV 没有的能力,对真实智能体非常关键; -
家族齐全:0.8B / 2B / 4B / 9B / 27B,每档都有 Instant(永不思考)和 AutoThink 两个变体,还有 GGUF(llama.cpp)和 MLX(苹果芯片)格式。官方自报 Decision Index 68.21(4B AutoThink),自称在每个尺寸档领先同类决策模型 7.4~16.9 分——注意,是自报数据。
⚠️ 协议提醒:JEV-9B 是 Apache-2.0 可商用;StartLux 权重是 CC BY-NC 4.0,仅允许非商业用途(推理包是 Apache-2.0),商用需要向 StartLux Labs 单独授权。做技术验证没问题,拿去做产品要先谈协议。
1.3 测试方案:完全同赛道对台赛
为了让对比有说服力,我们用了和 JEV 测试一模一样的方案:
-
同一台设备:H700 端侧设备(16GB 显存,30GB 内存),同一个 vLLM 0.31; -
同一套冒烟用例:一个纯文字决策 + 一张带编号红框的故障对话框截图; -
同一个真实任务:B站搜"南京苏州旅游攻略" → 百度地图查南京→苏州驾车路线 → 携程搜苏州酒店比价; -
同一套校验:URL/DOM 确定性校验器,模型自己说"完成"不算数; -
同一个 agent 闭环:截图 → 编号标框 → 决策 → Playwright 执行 → 校验,全程录屏。
只换决策模型本身。此外我们额外记录两项 StartLux 特有的数据:每一步的 AutoThink 是否触发、每一步的 none_probability。
二、部署:这次轻松得不像话
上次部署 JEV-9B 的文章标题是"把 14GB 模型塞进 16GB 显存"——驱动升级、CPU offload、KV cache 量化,每一 GB 都要算计。
这次 4B 模型的部署轻松得不像话:
# 1. ModelScope 下载 9GB 权重# 2. pip install -e '.[vllm]'(官方推理包)# 3. 一条命令起服务startlux-decide serve --model StartLux-4B-AutoThink \--launch-vllm --gpus 0 --port 8090 \--max-model-len 8192 --gpu-memory-utilization 0.95
9GB BF16 权重装进 16GB 显存,不需要量化、不需要 CPU offload、不需要砍上下文到 4K。整个过程只踩了两个小坑:
-
模型原生上下文是 262,144 token,vLLM 按全量上下文预留 KV cache 需要 8.1GB,装不下——--max-model-len 8192解决(对我们的任务绰绰有余); -
混合架构的 Mamba cache 块数随显存预算走,默认预算下不够 256 个序列槽——--gpu-memory-utilization 0.95解决。
对比上次"驱动都要升"的经历,这次从下载到服务可用不到半小时(大部分时间还是在等 9GB 下载)。
三、实测:4B 对 9B 的对台赛
3.1 冒烟:快 10~15 倍,还更自信
两个和 JEV 测试完全相同的用例:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
两个用例 StartLux 都选了和 JEV 相同的正确答案,但延迟低一个数量级,概率高一截。两次 AutoThink 都没有触发(ended: skipped)——模型够自信,门控直接放行。拒识概率 none_p ≈ 0.005,表示"候选里确实有正确答案"。
3.2 真实三站点:开箱首跑,三站全绿
然后是正戏。上次 JEV-9B 跑通这个任务用了九轮迭代;这次 StartLux-4B 用同一套已经固化的 harness,第一次完整运行就三站全绿(以下为 2026-10-22 重跑的完整记录):
✅ bilibili | 3 步 | (系统校验: 目标已达成)✅ map | 10 步 | (系统校验: 目标已达成,浏览充分)✅ hotel | 5 步 | (系统校验: 目标已达成,浏览充分)
每步决策的实际日志(注意延迟和概率):
step 1 | 0.7s | p=0.96 | 点击元素2: 功能按钮 route-buttonstep 2 | 0.7s | p=0.70 | 点击元素1: 输入起点或在图区上选点step 3 | 0.8s | p=0.98 | 在元素1中输入「南京」step 4 | 0.8s | p=0.70 | 按回车键(选中第一项建议)step 5 | 0.9s | p=0.75 | 点击元素4: 输入终点step 6 | 0.5s | p=0.99 | 在元素4中输入「苏州」step 7 | 0.7s | p=0.83 | 按回车键step 10| 66.7s| p=0.69 | 点击元素6: passMod_dialog-close(思考后关闭验证弹窗)
拿到真实结果:南京→苏州驾车方案(215.3 公里/3 小时 3 分钟、224.2 公里/3 小时 7 分钟等——和上一次实测的 219.2 公里/2 小时 43 分不同,路线是实时路况感知的)、携程苏州酒店真实房价(苏州吴中希尔顿欢朋酒店 ¥398 起/4.8 分、星辰酒店拙政园平江路店 4.7 分、观前街韶华大床房 ¥399 起)。
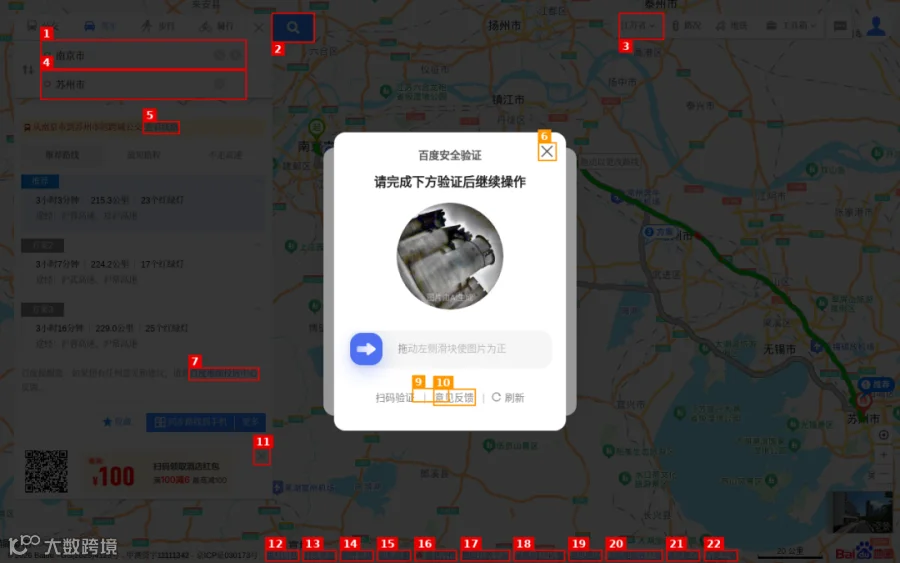
(百度又在最后弹了安全验证滑块——和上次一模一样的位置。模型点击 dialog-close 关掉它继续干完了活。)

3.3 AutoThink 实战表现:三分之一的决策在"认真想"
这次运行最有意思的数据,是 18 步决策的延迟分布——它直接暴露了 AutoThink 的触发模式:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
门限 0.6 之下,约三分之一的决策触发了思考。看触发位置非常合理:都是"当前阶段是否完成"、"弹窗怎么处理"、"还要不要再点一次搜索"这类需要权衡全局的判断;而"输入南京"、"点搜索"这种机械步骤全部秒答。
一个诚实的补充:长思考在端侧 4B 模型上非常耗时(最久一次 414 秒,因为思考 token 的生成速度远慢于单次读出)——AutoThink 省的是"不必要的思考",而不是"思考本身"。在高实时性场景,应该用 Instant 版本或者收紧 think_budget。
同一个模型,快的时候比 JEV 快 10 倍,难的时候肯花两分半钟想。这恰好是上次文章结尾那句话的另一个实现——"快的归快,慢的归慢",只不过这次快慢在同一个模型里。
3.4 拒识机制:这次没立功,但必须有
本次任务中 none_probability 全程低于 0.03(候选里基本都有正确动作),拒识没有真正触发。但从工程角度,这是 StartLux 相对 JEV 的一个重要增量:当页面因改版、加载失败、反爬而出现"候选全错"的局面时,JEV 只能从错误里挑一个概率相对高的,而 StartLux 有机会说出"这些都不对"——对无人值守的智能体,这是能不能放心放手的关键差异之一。
四、评测观点
4.1 两条技术路线,谁更好?
这次对台赛让我们看到了决策模型的两种实现哲学:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
我们的实测结论:在"端侧、16GB 显存、GUI 操作"这个具体场景里,4B 门控模型全面占优——更小的部署成本、更低的延迟、更高的置信度,而且真实任务一次通关。9B 双系统模型的优势在 System 2 的完整生成能力(写攻略、做规划),这部分 StartLux 的设计里是让位给外部编排的(或者用同家族更大的 AutoThink 型号)。
一个可能的工程答案是组合使用:StartLux 家族负责"决策"(0.8B~4B 足够快),另一个通用大模型负责"表达"——各司其职,而不是让一个模型包打天下。
4.2 上次的黑盒问题,这次好一点了吗?
上次我们指出 JEV System 1 的三层黑盒风险:无推理链不可解释、概率可被网页内容操纵、权限必须物理隔离。
StartLux 的 AutoThink 部分缓解了第一点:低置信度决策会留下思考文本,可审计。但后两点依然成立——门控本身也是模型的一部分,同样可能被精心构造的输入操纵(攻击者可以研究"什么样的页面能让门控放行");概率再高也只是建议,安全闸门仍然必须是模型之外的确定性规则。
还有一点新的提醒:AutoThink 的思考是采样生成的,官方也明确说"同一个问题思考两次可能得到不同答案"。对需要严格可复现的业务流程(比如审计回放),Instant 版本 + 外部校验反而可能是更稳的选择。
4.3 下一步
我们会继续把决策模型推进到真实业务场景:目前正在验证端侧智能体操控工业软件与物理设备的完整闭环
(自然语言 → 驱动真实桌面软件 → 操作物理设备 → 可审计报告)
JEV 和 StartLux 会作为两条候选路线继续同场对比,后续实测数据继续和大家分享。也提醒一句:JEV 是 Apache-2.0,StartLux 权重是非商用协议,选型时别忘了看一眼 License。
附录:模型与参考链接
本次主角
-
StartLux-Decision-v1.1-4B-AutoThink(ModelScope):https://modelscope.cn/models/StartLuxAI/StartLux-Decision-v1.1-4B-AutoThink -
推理包(Apache-2.0):https://github.com/StartLuxLabs/StartLux-Decision -
技术报告(arXiv):https://arxiv.org/abs/2610.17309 -
家族模型(0.8B~27B,Instant/AutoThink,GGUF/MLX):见模型卡 Family 列表
对照
-
JEV-9B(上一篇实测):https://huggingface.co/autotrust/JEV-9B | https://www.modelscope.cn/models/autotrust/JEV-9B -
上一篇实测文章:《让端侧 AI 自己上网干活:JEV-9B 双系统模型在 H700 上的全流程实测》
本次实测录取视频文件
评测环境:H700 端侧设备(GPU 16GB 显存)/ vLLM 0.31.0 / StartLux-Decision-v1.1-4B-AutoThink BF16 / Playwright + Chromium 无头浏览器。官方基准数据(Decision Index、H200 延迟)为官方自报数据;本文"实测"数据均为本机真实运行结果,附完整录屏与截图存证。StartLux 权重为 CC BY-NC 4.0 非商用协议。
注 芯动力AI,我们会继续分享 大模型、Agent 和具身智能等方面的相关信息。