

哈喽,大家好~
最近有同学提到:模型的 已经很高了,是不是就能直接用了?
今天聊一个大家很容易忽略的概念,叫残差分析。它不仅能判断模型拟合得好不好,还能发现非线性、异方差、异常点和强影响样本。
01残差
我们先从回归模型说起。
假设模型对第 个样本的预测值为 ,真实值为 ,那么残差就是:
这里, 表示模型在当前样本上的预测偏差。
比如某套房真实价格是300万,模型预测280万,那么残差就是20万;如果模型预测320万,残差就是-20万。
一句话概括:残差就是模型没有解释掉的部分。
一个状态良好的回归模型,残差通常具有下面几个特点:
-
围绕0随机波动,没有明显曲线或趋势; -
不会随着预测值增大而明显扩散; -
极端残差较少,没有少数样本控制整个模型; -
做置信区间和显著性检验时,残差应接近正态分布。
注意,残差小不等于模型一定可靠。模型也可以在训练集上残差很小,但在新数据上直接失效。
02从残差形状判断模型问题
残差图最重要的不是“点够不够密”,而是看它有没有规律。
如果残差呈现U形或波浪形,说明数据中还有非线性关系没有被模型学到。比如真实关系是二次曲线,我们却使用直线拟合,模型一定会在某些区域持续高估,在另一些区域持续低估。
如果残差像喇叭一样逐渐张开,说明存在异方差。也就是说,目标值越大,预测误差也越大。
为了让不同位置的残差可以比较,我们还会使用标准化残差:
其中, 是残差标准差, 是样本的杠杆值。杠杆值越高,说明这个样本在特征空间中越“偏”。
进一步判断样本对模型的影响,可以使用Cook距离:
这里 是模型参数个数。Cook距离同时考虑了残差和杠杆值,数值越大,样本对模型参数的影响越强。
03完整案例:残差会暴露哪些问题
下面构造一组带有非线性、异方差和异常点的数据~
我们分别训练线性回归和三次多项式回归,然后画出两组复合诊断图。代码可以直接运行。
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures

rng = np.random.default_rng(42)

# 1. 构造非线性、异方差数据
n = 1260
x = np.sort(rng.uniform(0, 10, n))
sigma = 0.45 + 0.16 * x

y_true = 3 + 2*x - 0.7*x**2 + 0.12*x**3
y = y_true + rng.normal(0, sigma)

# 加入3个异常点
outlier_idx = np.array([25, 115, 210])
y[outlier_idx] += np.array([6, -7, 8])

X = x.reshape(-1, 1)

# 2. 线性回归
linear_model = LinearRegression()
linear_model.fit(X, y)
pred_linear = linear_model.predict(X)

# 3. 三次多项式回归
poly = PolynomialFeatures(degree=3, include_bias=True)
Phi = poly.fit_transform(X)

poly_model = LinearRegression(fit_intercept=False)
poly_model.fit(Phi, y)
pred_poly = poly_model.predict(Phi)

# 分箱趋势线
def binned_trend(a, b, bins=12):
    edges = np.quantile(a, np.linspace(0, 1, bins + 1))
    group = np.digitize(a, edges[1:-1])
    return (
        np.array([a[group == i].mean() for i in range(bins)]),
        np.array([b[group == i].mean() for i in range(bins)])
    )

# 4. 图1:比较两个模型的残差结构
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

for ax, pred, title, color in [
    (axes[0], pred_linear, "Linear Regression", "#00E5FF"),
    (axes[1], pred_poly, "Cubic Polynomial Regression", "#FF4FD8")
]:
    residual = y - pred
    bx, by = binned_trend(pred, residual)

    ax.scatter(pred, residual, c=x, cmap="turbo",
               s=38, alpha=0.8, edgecolors="white", linewidths=0.3)
    ax.plot(bx, by, color="#FFE600", linewidth=3,
            marker="o", label="Binned residual trend")
    ax.axhline(0, color="white", linestyle="--")
    ax.axhline(2*residual.std(), color="#FF5252", linestyle=":")
    ax.axhline(-2*residual.std(), color="#FF5252", linestyle=":")
    ax.set_title(title, color=color, fontsize=14)
    ax.set_xlabel("Fitted value")
    ax.set_ylabel("Residual")
    ax.legend()

plt.suptitle("Figure 1: Residual Structure Comparison",
             fontsize=17, color="#7CFF6B")
plt.tight_layout()
plt.show()

# 5. 计算标准化残差、杠杆值和Cook距离
residual = y - pred_poly
p = Phi.shape[1]

hat_diag = np.einsum(
    "ij,jk,ik->i",
    Phi,
    np.linalg.pinv(Phi.T @ Phi),
    Phi
)

mse = np.sum(residual**2) / (n - p)
std_residual = residual / np.sqrt(mse * (1 - hat_diag))
cook = (std_residual**2 / p) * (hat_diag / (1 - hat_diag))

# 6. 图2:完整残差诊断
fig, axes = plt.subplots(1, 3, figsize=(18, 5))

# Q-Q图
osm, osr = stats.probplot(std_residual, dist="norm", fit=False)
axes[0].scatter(osm, osr, c=osr, cmap="cool",
                s=35, edgecolors="white")
low = min(np.min(osm), np.min(osr))
high = max(np.max(osm), np.max(osr))
axes[0].plot([low, high], [low, high], "--", color="#FFE600")
axes[0].set_title("Normal Q-Q")
axes[0].set_xlabel("Theoretical quantiles")
axes[0].set_ylabel("Standardized residual")

# Scale-Location图
scale_residual = np.sqrt(np.abs(std_residual))
bx, by = binned_trend(pred_poly, scale_residual)
axes[1].scatter(pred_poly, scale_residual, c=x,
                cmap="spring", s=38, alpha=0.8)
axes[1].plot(bx, by, color="#00FFFF", linewidth=3, marker="o")
axes[1].set_title("Scale-Location")
axes[1].set_xlabel("Fitted value")
axes[1].set_ylabel("Sqrt(|standardized residual|)")

# 杠杆值与影响力图
sizes = 40 + 1800 * np.clip(cook, 0, 0.25)
sc = axes[2].scatter(
    hat_diag, std_residual, s=sizes, c=cook,
    cmap="plasma", alpha=0.75, edgecolors="white"
)
axes[2].axhline(2, color="#00FF9D", linestyle="--")
axes[2].axhline(-2, color="#00FF9D", linestyle="--")
axes[2].axvline(2*p/n, color="#00E5FF", linestyle=":")
axes[2].set_title("Leverage and Cook's Distance")
axes[2].set_xlabel("Leverage")
axes[2].set_ylabel("Standardized residual")
plt.colorbar(sc, ax=axes[2], label="Cook's distance")

# 标注Cook距离最大的样本
for i in np.argsort(cook)[-3:]:
    axes[2].annotate(
        str(i),
        (hat_diag[i], std_residual[i]),
        color="white"
    )

plt.suptitle("Figure 2: Polynomial Model Diagnostic Dashboard",
             fontsize=17, color="#FF7A00")
plt.tight_layout()
plt.show()

print("Cook距离最大的样本:", np.argsort(cook)[-3:])
print("最大Cook距离:", cook.max())
第一张图用于比较模型结构~
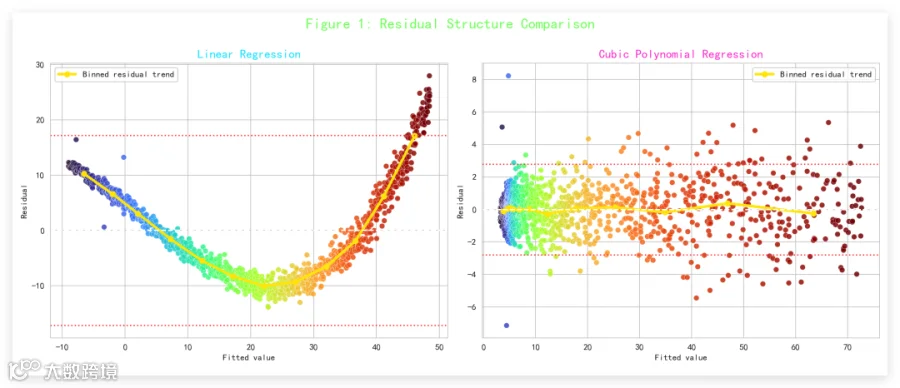
线性回归的残差趋势线会出现明显弯曲,说明直线没有学到真实的三次关系。换成多项式回归后,趋势线更接近0,非线性结构基本被模型解释掉了。
但多项式模型的残差仍会逐渐扩散。这不是增加多项式次数就能解决的问题,而是数据本身存在异方差。我们这里可以对目标值做对数变换,或者使用加权回归、稳健回归。
第二张图用于深入检查多项式模型

Q-Q图检查残差尾部是否偏离正态;Scale-Location图观察误差波动是否稳定;最后一张图同时结合标准化残差、杠杆值和Cook距离。气泡越大、颜色越亮,样本对模型的影响越强。
实际分析时,不要看到强影响点就直接删除。先检查它是录入错误、特殊业务样本,还是数据分布中的真实情况。
总结
残差分析不是为了证明模型“没有误差”,而是判断模型的错误有没有规律。残差出现曲线、喇叭口或极端影响点,都在提醒我们当前模型还有明确问题。
接下来大家可以把案例换成随机森林,比较树模型和线性模型的残差结构;也可以对目标值做对数变换,再观察异方差是否减弱。真正可靠的模型,不只是指标高,它的错误也应该经得起分析。