

小样本学习正成为破解标注数据稀缺瓶颈的核心钥匙,与传统机器学习深度融合后,在医学影像、工业质检、遥感解译等标注昂贵场景展现出极强落地价值。
本文从近年顶会顶刊中整理了10篇两者结合的最新前沿论文,正在做相关课题的伙伴可以直接下方领取论文及代码(部分包含),不管是快速搭baseline、找创新切口,还是跟最新技术趋势,都能省不少从零摸索的功夫。
长按识别下方二维码,回复【小样本机器】
无偿领全部论文合集及项目代码

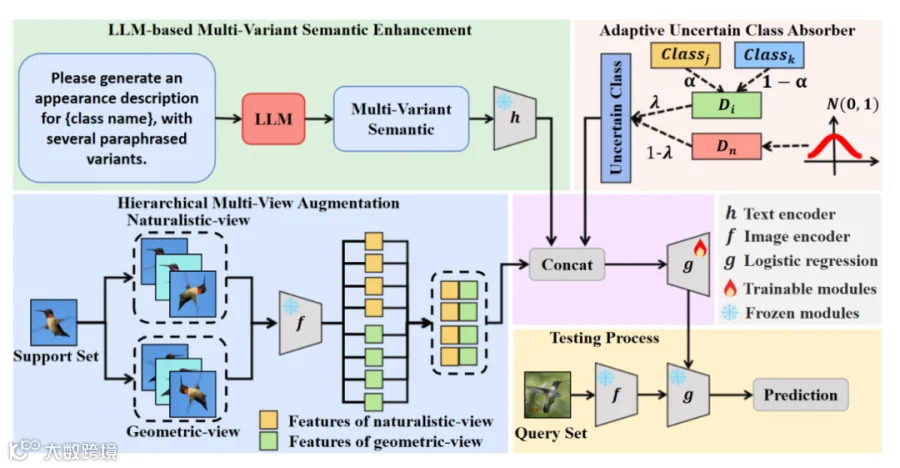
MPA: Multimodal Prototype Augmentation for Few-Shot Learning
面向少样本学习的多模态原型增强框架
文章内容
针对现有少样本原型方法仅依赖单模态视觉特征、易受少数扰动样本干扰的痛点,提出融合三大模块的MPA框架:用LLM生成多版本类别语义描述补充文本语义特征,降低对原始图像的依赖;结合自然真实视角与几何变换视角的分层多视角增强,丰富支持集特征多样性;通过自适应插值与高斯采样构建不确定类吸收样本,降低类间干扰。在4个单域、6个跨域少样本基准上,5-way 1-shot设置下分别比次优方法提升12.29%、24.56%,跨域泛化能力突出。
Leveraging Information Retrieval to Enhance Spoken Language Understanding Prompts in Few-Shot Learning
面向少样本场景下口语理解提示增强的信息检索方法
文章内容
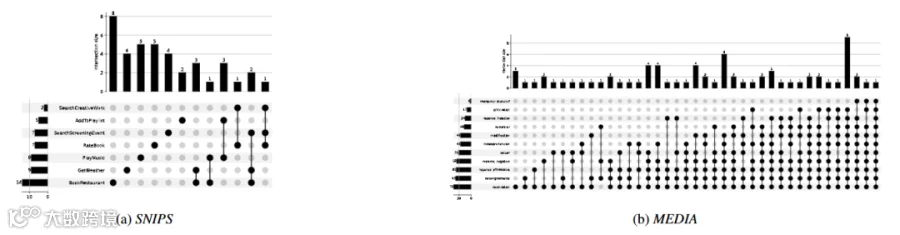
针对少样本口语理解任务中随机选择提示示例相关性弱、槽位标注准确率低的问题,提出将信息检索机制融入提示示例选择流程,对比经典BM25词法检索、ColBERT语义检索两类方法,结合意图过滤策略为每条待预测语音召回最相似的标注样本。在ATIS、SNIPS、SLURP、MEDIA四个主流口语理解基准上的少样本实验显示,BM25检索方案效果最优,相比随机选样基线平均F1值提升近30个点,验证了细粒度词法对齐信息对LLM槽位标注任务的显著增益。
Prompt Balance Matters: Understanding How Imbalanced Few-Shot Learning Affects Multilingual Sense Disambiguation in LLMs
提示平衡的关键性:理解样本分布失衡对大模型多语言词义消歧的影响
文章内容
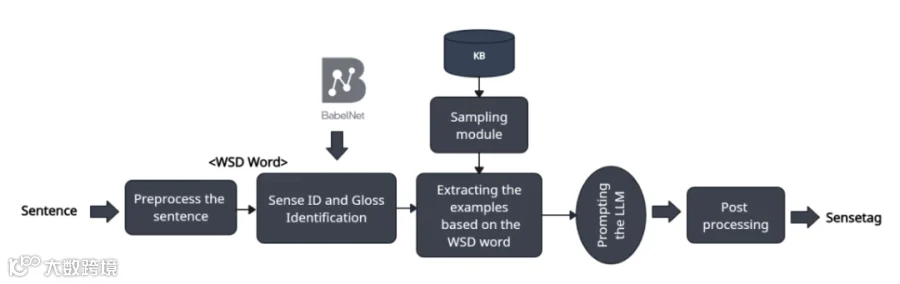
针对现有少样本提示研究多忽略样本分布偏差的问题,基于成熟的GLOSSGPT提示框架,系统测试最高频率共享、最低频率共享、平均频率共享三类采样策略在英、德、西、法、意5种语言上的词义消歧效果。结果显示,非英语低资源语言下,失衡的少样本示例会导致大模型偏向高频词义、消歧准确率显著下降,且该偏误在英文任务中几乎不出现,实验证明平衡代表性示例、匹配目标语言词义分布是提升多语言词义消歧性能的关键前提。
↓↓听说在下方一键三连的都Accept了🌝


