

QUOTE
Games have been a critical part of my entire career.
—— 德米斯·哈萨比斯,诺贝尔奖官网访谈,2024
10 月 21 日,《华尔街日报》刊出 Ben Cohen 对 Google DeepMind CEO 德米斯·哈萨比斯(Demis Hassabis)的访谈。按 Techmeme 与 AI Weekly 的转述,他把通用人工智能(AGI)的预期窗口,从今年早些时候说的「三到五年」,收到了「两到三年」,并再次强调 AI 对科学的推动,点到自家药物发现公司 Isomorphic Labs 的管线。
时间表会不会准,外人没法替他担保。但哈萨比斯这个名字,国内读者多半不陌生:AlphaGo、AlphaFold、2024 年诺贝尔化学奖。今天这篇不争论「两年还是五年」,只借这个由头,回看他怎么一路走来——从 4 岁学棋,到 17 岁参与做出卖超一千万份的游戏,再到用同一套「先在规则清楚的小局里验证,再搬到真实科学」的方法建 DeepMind。
人无完人。他的成绩单不能照搬,方法可以。
本文看点
01
今天这句时间表在说什么
02
从棋盘到游戏公司再到神经科学
03
四个能照搬的做法
01
HOOK
他把窗口收窄,押的是什么
两到三年
AGI 预期(WSJ 转述)
三到五年
今年早前口径
科学落地
Isomorphic 管线作近端证据
按公开转述,哈萨比斯收窄时间表时,并没有只甩一个口号。他强调的是:前沿能力在往科学问题上搬,药物发现是看得见的近端证明。换句话说,他敢把时间往前推,是因为手里已经有「不是演示、而是管线」的东西。
这和很多人用 AI 的方式正好相反。我们常先喊愿景,再找案例;他更像是:案例攒够了,才敢改口头时间表。这对普通人有用——你要对外说「我能做成 X」,最好先有一个已经跑通的小版本,而不是先把口号喊大。
当然,时间表本身有争议。历史上预测 AGI 日期的人很多,准的少。本文把它当成他如何做判断的样本,不当成投资或人生规划的保证。
02
BIO
从棋盘、游戏到大脑:四十多年的试验场

— 哈萨比斯肖像。摄影:Duncan.Hull,CC BY-SA 4.0,经 Wikimedia Commons
哈萨比斯自己说,对科学和 AI 的兴趣,是从游戏开始的。他 4 岁学国际象棋,后来认真到能带英格兰少年队。训练营里要用到棋电脑,他本来该练开局,却越来越着迷:一堆塑料怎么就能下棋?于是他想自己写程序——编程和 AI 的入口,是这么来的。公开报道还写过,他大约 13 岁达到国际象棋大师级水平。
17 岁那年,他在英国工作室 Bullfrog 参与《主题公园》(Theme Park)。按他本人 2023 年 CV 的写法,这款游戏后来全球卖出超一千万份。他负责的是 AI 与模拟相关的程序工作,和彼得·莫利纽克斯(Peter Molyneux)等人一起,把「经营一个乐园」做成可玩的系统。之后他进剑桥读计算机,一等荣誉毕业;又参与 Lionhead,在《黑与白》里做生物 AI——让一只虚拟生物根据玩家行为学习、适应。
1998 年,他创办 Elixir Studios,做带复杂 AI 的策略游戏,公司一度做到约 60 人规模。2005 年前后,IP 和技术权卖掉,他选择回学界。这一段常被略过,但它很重要:创业不是只会上扬的曲线。他没有死磕「游戏公司必须做到上市」,而是在觉得主线该回到 AI 研究时,换赛道。
接下来四年,他在伦敦大学学院(UCL)读认知神经科学博士,研究记忆、想象与海马体。相关工作曾被《Science》列入 2007 年十大科学突破之一。他自己后来说得很清楚:去研究大脑,是为了给新的 AI 算法找灵感。
2010 年,他和 Shane Legg、Mustafa Suleyman 创办 DeepMind。2014 年被谷歌收购。之后是大众更熟的段落:用游戏当试验场打磨深度强化学习,再到 AlphaGo,再到 AlphaFold 把蛋白质结构预测推到足以拿诺奖的程度。

— 四个节点:棋盘练判断 → 游戏写 AI → 神经科学找原理 → DeepMind 做通用方法
串起来看,他几乎每一步都在做同一件事:先找一个规则清楚、结果可复盘的小环境,把方法练熟,再换更大的题。
读到这里,如果你也想把人物稿里的「可学之处」抄成自己的行动清单,可以回复【成长四步】领取「成长四步笔记」——四格:经历节点、可迁移做法、客观边界、本周只选一步。
03
LEARN
四个可以照搬的做法
第一,用「小局里的输赢」训练判断,而不是只刷信息。他把国际象棋、心智运动、商业游戏都当成思维训练。普通人不必去赢奥赛,但可以给自己设一个每周可复盘的小局:写一篇能发出的短文、做一个能演示的小工具、跑通一条能交付的客户流程。输了就改规则,赢了就加大难度。关键是有结果、能复盘,不是一直在收藏夹里囤教程。
第二,卡住时,去学一层更底层的机制。游戏公司做到一定阶段,他没有继续堆功能,而是去读大脑如何形成记忆与想象。今天做 AI 应用也一样:提示词调不通,就去搞清楚模型在什么任务上会胡编;转化率上不去,就去拆用户决策链路。换赛道不是逃跑,是给原问题换一把更深的铲子。
第三,先在封闭规则里证明,再碰开放世界。DeepMind 早期大量工作发生在 Atari、围棋这类「分数清楚、规则固定」的环境里。等算法真能从像素学会通关,再推向科学与产业。你做产品也可以:先在一个边界清楚的场景里做到稳定交付,再扩品类。很多人反过来——一上来就承诺「全能助手」,结果哪个场景都不稳。
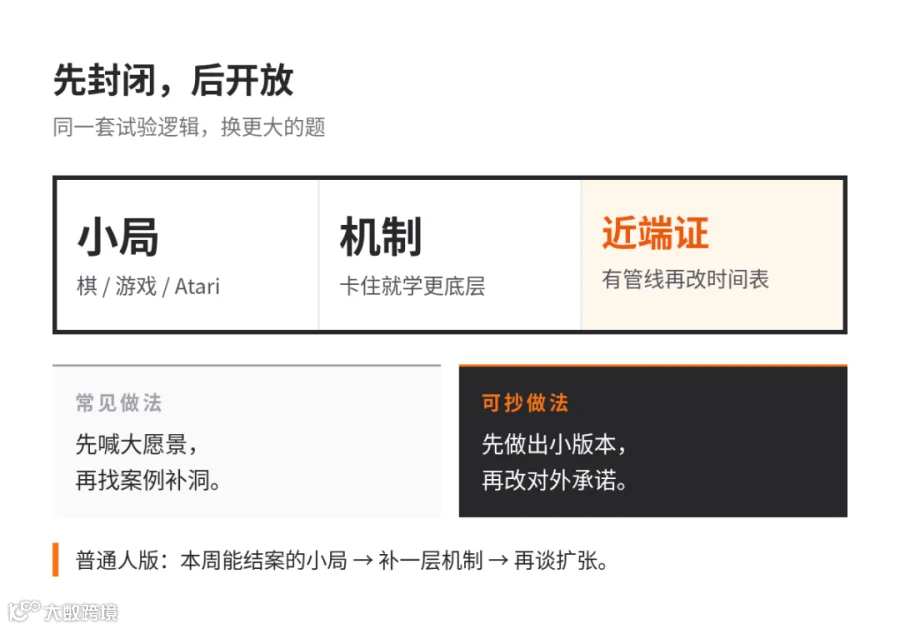
— 先封闭后开放:小环境验证 → 近端科学证据 → 才敢改时间表
第四,有近端证据,才改对外承诺。这次他把 AGI 窗口往前收,公开口径里绑的是科学落地与管线,而不是情绪。普通人对外报价、对内排期,也可以学这一条:没有「已经跑通的小版本」,就别先把大话写进合同和朋友圈。
四件事其实是一件:把人生当成一连串可设计的试验,而不是一串要一次做对的押注。
04
EDGE
客观看:他也有拐弯和争议
Elixir 后来卖掉 IP 收场,说明「做过爆款游戏」也不等于下一盘一定成。DeepMind 并入谷歌之后,独立性、资源分配、研究方向一直有外界讨论——这些是组织问题,不是个人神话能消掉的。AGI 时间表本身也充满争议:同一行业里,有人更乐观,有人更谨慎;历史预测打脸的次数并不少。
诺奖与 AlphaFold 的成果,是大团队与多年投入的结果。哈萨比斯本人在访谈里也反复强调游戏、合作者和科学问题本身。把他写成「一个人改写了 AI」,既不准确,也学不到东西。
所以,抄他的方法可以,抄他的光环没用。你没有 DeepMind 的算力与人才密度,就更该把他的路径缩成你能负担的版本:更小的局、更短的反馈、更老实的对外承诺。
05
HOW
这周就能做的事
你多半不会去训练下一个 AlphaGo,但可以把他的做法拆小:
选一个本周能结案的小局。写清成功标准(发出、成交、跑通、复盘文档),周五对照结果改规则。
给卡住的问题补一层「机制课」。只学能直接解释失败的那一层,学完立刻改一版方案。
先做封闭场景的稳定交付。选一个客户类型或一个功能边界,做到可重复,再谈扩张。
对外承诺前,先摆出近端证据。截图、案例、一周试用数据,缺一样就先别放大话。
用「成长四步」记一笔。回复关键词领笔记,把本篇人物填进四格,并勾选本周只做哪一步。
∞
THE END
最后说两句
从 4 岁的棋盘,到 17 岁那款卖超千万份的游戏,再到今天敢把 AGI 窗口往前收,哈萨比斯这条线并不神秘:一直在可复盘的环境里练方法,卡住就去更深的一层找原理,有了近端证据才改口头时间表。
他也会关公司、也会被质疑时间表、也站在巨大的团队与平台之上。成绩单不能复制,「小局验证 → 机制升级 → 再扩大承诺」可以。
□ 定 1 个本周能结案的小局,写清成功标准
□ 给当前卡点补 1 层机制课,并改 1 版方案
□ 选 1 个封闭场景,做到可重复交付
□ 下次对外承诺前,先备齐近端证据
□ 回复【成长四步】领取笔记,填完四格并勾选本周一步
这几步里你最想先学哪一步?评论区直接回序号也行。
出处:Techmeme / AI Weekly 对《华尔街日报》Ben Cohen 2026-10-21 访谈的转述;诺贝尔奖官网 Demis Hassabis 访谈实录(2024);Hassabis 本人 CV(2023);The Guardian《15 facts》(2014);BBC 诺奖报道;Wikipedia「Theme Park (video game)」条目(全平台销量另有约 1500 万说法,正文销量采用本人 CV「超一千万」口径)。
往期 · 继续读
刚融15亿美元的芯片老将凯勒:同事平均读过0本管理书,他读了20本
堡垒之夜老板斯威尼:写虚幻引擎那几年,70%时间只是在打字
奥特曼:从「一夜颠覆」改口到「冲击更慢」,可学的是认错速度
会用 AI 工具,却不知道怎么把「方法」卖成别人愿意付钱的交付,是很多人的卡点。哈萨比斯的启示是:先做出可复盘的小版本,再谈更大的承诺。「AI商业实战」新人邀请礼遇 ¥25,进来先领可勾选的成长笔记和交付短卡,把你会的写成别人能直接买的东西,每天还有风向和可复现教程。回复【成长四步】领取「成长四步笔记」。
新人邀请礼遇:点文末「阅读原文」开启 AI 实战交流
END
我是「AI科技明星」,每天借热点回看一位 AI 圈人物的成长节点,和普通人能带走的做法。
觉得有用的话,欢迎点赞、收藏、评论。