
10 月 20 日,PyTorch 大会北美站。同一天,两家云厂商各自官宣了一件事。
Google 开源了 TorchTPU,让 PyTorch 原生跑在 TPU 上。AWS 开源了 TorchNeuron,让 PyTorch 原生跑在 Trainium 上。
原生这个词是重点。不是适配层,不是转译,是把 TPU 和 Trainium 注册成 PyTorch 的标准设备,和 cuda 平起平坐。
迁移要改多少代码。一边是把 .to("cuda") 改成 .to("tpu"),另一边是改成 .to("neuron")。
就这么多。
TorchTPU 官方发布图(图源 PyTorch 官方博客,下同)
一、85% 的人,只有一个答案
先说一个数字。今天 85% 的 AI 研究者和开发者用 PyTorch 写代码。但这些代码能跑在哪,过去基本只有一个答案,NVIDIA。
想换块芯片试试性价比。对不起,重写,重新验证,几个月没了。
AWS 的比喻很形象。你花几年调教好一辆车,发动机、悬挂,每个零件都磨合到位。这时来了一台更便宜更有劲的新发动机,但换上它的代价是把车拆散,一个零件一个零件重装。
CUDA 的护城河从来不止是芯片快,是「代码只能跑在我这」。
而这一次,两家做的事情是把这道墙从框架内部拆掉了。
二、TorchTPU,Google 和 Meta 联手的诚意
这不是 Google 第一次尝试。2020 年的 PyTorch/XLA 基于 Lazy Tensor,要侵入式改代码,编译延迟感人,还不支持 PyTorch 最魂的 eager 模式。后来的 TorchAX,也是把 PyTorch 硬塞进 JAX 的行事方式里。社区一直不太买账。
这次不一样。TorchTPU 是 2025 年中 Google 和 Meta 的 PyTorch 团队一起开的项目,白纸黑字立了原则。第一条叫 PyTorch 公民身份,运行时里没有 JAX 依赖,eager 是一等公民,torch.compile 走 TorchDynamo,分布式用 PyTorch 自己的 DDP、FSDP、DTensor。
成果已经摆在那。Hugging Face 下载量最高的 5000 个模型开箱即跑,Qwen、DeepSeek、Gemma、Llama、Whisper、CLIP、BERT 都在名单里。vLLM、SGLang、TorchTitan、Ray 全部打通,Google Cloud 最大的几个客户已经在生产环境用它做训练和推理。
有个技术细节挺有意思。他们做了一个 DeferAndFuse 模式,把一串 eager 操作攒起来,融合编译后再执行,比逐条执行快 50% 以上,还顺便降了峰值显存。eager 的灵活和编译的速度,两头都想要。
三、TorchNeuron,AWS 的「换发动机」
AWS 的 TorchNeuron 走的是同一条路。通过 PrivateUse1,PyTorch 官方给自定义硬件留的扩展点,把 Trainium 注册成标准设备。torch.nn、torch.distributed、torch.profiler,原样可用。
.to("neuron") 是唯一改动。按 torch.accelerator 这套设备无关 API 写的现代代码,一行不用动。

TorchNeuron 架构。PrivateUse1 后端接进 PyTorch Dispatcher,torch.compile 走 Dynamo 后端进 Neuron 编译器
编译链路也值得一看。TorchDynamo 抓图,AOTAutograd 提前追好反向,经 Torch-MLIR 降到 StableHLO,Neuron 编译器产出 NEFF 文件上硬件。想写自定义 kernel,有 NKI,官方还开源了 NKI-lib,FlashAttention 和 MoE 的 Trainium 优化 kernel 都在里面。
分布式全家桶都在,DDP、FSDP2、张量并行、流水并行、ZeRO,集合通信走 Trainium 自己的 collective cores 和 EFA 网络。支持 Trainium2 和 Trainium3,Apache 2.0 协议,每次构建拿几十万个模型做回归测试。
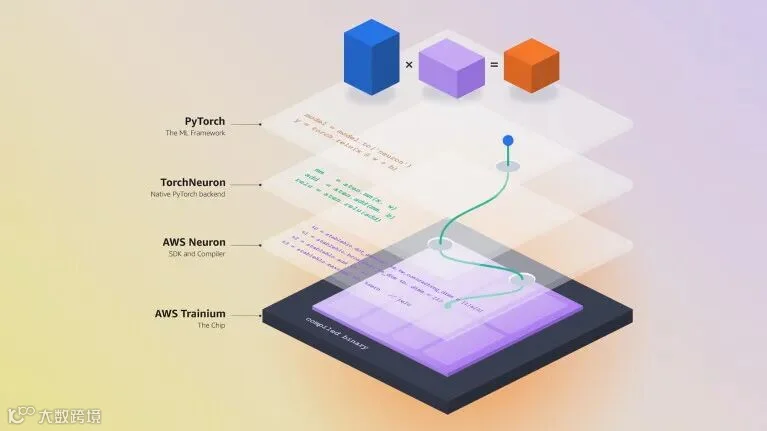
从 PyTorch 到 Trainium 的分层栈(图源 Amazon 官方博客)
谁已经在用。语音 AI 公司 Cartesia,标准推理管线几乎没改就跑了。Lieber 脑发育研究所,拿它做药物靶点发现。还有机器人、视频生成、世界模型、自动驾驶的一票公司。
AWS 还表了个态,我觉得格局不小。他们在往上游 PyTorch 贡献代码,专门拆掉框架里绑定特定芯片的部分,目标是让 PyTorch 对整个社区都更硬件无关,不只是 Trainium 用户受益。
四、为什么这是大事
注意一个殊途同归的细节。TPU 的编译栈入口是 StableHLO,Trainium 的 torch.compile 最后也降到 StableHLO。两块不同的芯片,把 PyTorch 汇到了同一个中间层。
这才是框架真正的价值。硬件差异被框架吞掉,开发者的代码第一次接近了那句老话,一次编写,处处运行。
放在行业坐标里看。过去想挑战 NVIDIA,得先说服开发者改代码,这是个死循环,没人改代码就没有生态,没有生态就没人敢换芯片。现在 PyTorch 官方把扩展点标准化了,新芯片只要注册成一个后端,就能直接接住 85% 开发者的存量代码。
芯片竞争的胜负手,从「谁的生态锁定深」,回到了「谁的性价比好」。
对 NVIDIA 这不是末日,它依然是最强的那个。但「只能跑 NVIDIA」的时代,在这一天之后,正式结束了。
开发者手里的筹码,变多了。
原文 Introducing TorchTPU(PyTorch 博客)、Introducing TorchNeuron(PyTorch 博客)、Amazon 官方新闻稿,2026 年 10 月 20 日前后发布。两个项目均已开源,仓库分别在 github.com/google-pytorch/torch_tpu 和 github.com/aws-neuron/torch-neuronx。
1.20K-40K!深圳扬奇医芯招双目结构光算法工程师
2.AI教父Hinton诺奖演讲首登顶刊!拒绝公式,让全场秒懂「玻尔兹曼机」
3.GitHub没了?CEO辞职,微软接管,开发者天塌了
4.AI颠覆数学研究!菲尔兹奖得主、华裔数学家领衔11篇顶刊论文|陶哲轩转赞
5.AI OS,下一个二十年的超级平台
6.全球首个IMO金牌AI诞生!谷歌Gemini碾碎奥数神话,拿下35分震惊裁判