

论文:《SRCRec: Staged Reverse Curriculum Learning for Conversion-Oriented Generative Recommendation》
作者:Yulei Huang , Hao Deng
 , Jinxin Hu
 , Yu Zhang, Xiaoyi Zeng
生成式推荐(Generative Recommendation,GR)通过自回归生成商品语义ID,统一建模用户的多行为交互。在以购买等转化行为为核心目标的场景中,模型需要从长序列、多兴趣的历史行为中识别转化意图,而可用的转化监督高度稀疏。如何降低稀疏转化任务的优化难度,并兼顾线上服务效率,是生成式推荐落地中的重要问题。
针对这一问题,我们提出SRCRec(Staged Reverse Curriculum Learning),一个面向稀疏转化建模的多阶段逆课程学习框架,相关论文已被CIKM 2026接收。SRCRec围绕转化目标构建难度递增的多阶段课程:先学习与目标紧密相关的低难度课程,再逐步学习由更早历史行为构成的高难度课程,最终回归不引入辅助课程的原始转化任务。通过课程构造与优化调度,我们将稀疏转化学习组织为渐进的训练过程,同时保持标准GR的线上推理流程。
实验表明,SRCRec在Tmall公开数据集和工业数据集的全部评估指标上均优于对比方法。在Lazada推荐广告平台在线A/B实验中,相对TIGER基线,SRCRec带来订单量提升3.52%、GMV提升2.98%;在服务效率评测中,SRCRec的推理时延与TIGER相当。
1. 背景:稀疏转化监督下的优化难题
标准GR基于完整用户历史编码,从BOS开始自回归生成目标商品的语义token。在转化导向任务中,监督主要集中于稀疏的最终转化目标,模型需要直接学习从长历史、多行为噪声到转化商品的复杂映射。这一过程既依赖有效的行为表征,也受到稀疏监督下优化难度的制约。
现有多行为GR方法通过行为类型区分、行为感知编码等方式增强用户表征,但主要仍在原始的完整历史预测目标下直接优化。RCLRec等方法进一步利用与转化相关的中间行为,将其作为一次性Decoder前缀,为目标预测提供额外条件。然而,单组前缀条件下仍需要直接学习复杂的转化映射,缺少从目标近邻状态逐步过渡到较早、较弱行为状态的难度分解,稀疏转化的学习难度依然较高。同时,在线前缀构造与更长的Decoder输入也会增加服务开销。
我们希望显式定义历史行为的课程难度,构建由易到难的训练任务序列,并通过优化调度将课程收益迁移到与线上推理一致的原始任务。

图1:三种生成式推荐模式的对比。(a)标准GR根据用户历史直接预测目标;(b)一次性前缀GR利用一组中间行为作为解码条件;(c)SRCRec通过多阶段逆课程学习逐步优化不同难度的课程任务,并最终回归无课程任务。
2. SRCRec:多阶段逆课程构造与优化调度
CRec沿用Encoder-Decoder骨干。对于用户 ,将按时间排列的多行为历史记为 ,其中 为历史长度, 和 分别表示第 次交互的行为类型与商品。Encoder输出上下文表示 ,其中 为历史位置 的 维表示。Decoder预测下一次转化商品 的语义token序列 , 为商品语义token序列长度。 我们构造 个辅助课程 ,其中上标 表示课程阶段, 是该阶段选中历史商品的语义token序列;另设无课程任务 ,即课程上下文为空。 对应目标近邻的低难度课程,后续课程逐步向更早、更高难度的历史行为展开, 直接对应线上推理任务。
各阶段共享模型参数,Encoder始终编码完整用户历史;阶段差异体现在Decoder侧的课程上下文,以及各阶段预测损失的优化权重。

图2:SRCRec整体框架。模型根据目标相关性、时间距离和行为强度构造多阶段逆课程,将课程token注入Decoder,并通过阶段权重调度逐步回归标准GR目标,在线采用无课程前缀推理。
2.1 目标条件化的课程难度建模
对每个转化训练样本,我们以目标商品为锚点,将可学习的用户嵌入与目标商品语义token的平均嵌入拼接,经多层感知机(MLP)得到 维查询向量 。随后,通过缩放点积计算查询与历史上下文表示的相关性:
其中, 为历史位置 与当前转化目标的相关性分数, 表示向量转置;Min-Max在当前样本的完整历史序列内进行归一化,得到 ,数值越大表示目标相关性越高。
在此基础上,我们引入归一化时间距离 和行为强度 ,定义历史位置 的课程难度:
其中, 为历史位置 的课程难度, 为该交互与目标时刻 之间的归一化时间距离, 为行为类型的强度权重,加购、购买等较强行为对应更大的权重; 、 和 是控制三类因素贡献的超参数。目标相关性更高、时间距离更近、行为强度更大的交互具有更低的难度。目标相关性使课程能够适应具体转化样本,时间距离和行为强度则补充用户决策过程中的时序与行为先验。
2.2 时间有序、难度递增的多阶段课程构造
将第 阶段选择的历史行为数记为 ,对应的位置索引集合记为 。第一阶段从完整历史中选择难度最低的 个行为,得到 。对于后续阶段,我们同时施加时间约束和难度约束:候选行为必须早于上一阶段最早选中的行为,且难度超过上一阶段平均难度与指定间隔之和。第 阶段的候选集合 为:
其中, 为上一阶段最早选中行为的位置, 为上一阶段已选行为的平均难度, 为阶段间的难度间隔。这两个约束使课程逐步向更早的历史展开,并显式提高课程难度。
在候选集合内,我们进一步结合目标相关性与相邻课程的语义连续性进行排序。将上一阶段已选行为的上下文向量取平均,得到课程聚合表示 ,定义候选行为的阶段排序分数:
其中, 越大,表示该行为越适合进入当前课程; 为目标相关性项的权重, 为当前阶段与上一阶段课程关联项的权重, 使用归一化前的相关性分数。我们按 从高到低选择 个行为,得到 ,在增加难度的同时保持与目标的一致性及阶段间的语义连续性。
每个阶段的课程上下文仅由本阶段选中的历史商品组成:先按原始时间顺序排列,再映射并拼接为课程语义token序列 。逆课程沿时间向更早的历史扩展,阶段内部保持原始行为顺序。 由此,模型可以从目标近邻的容易状态开始优化,逐步学习较早、较弱行为条件下的转化预测。
2.3 Decoder侧课程注入与目标监督
在第 阶段,Decoder训练输入为 ,分号表示序列拼接。BOS为序列起始标记,使用目标行为嵌入 进行控制,其中 表示目标行为类型,例如购买。课程token通过teacher forcing直接作为已知上下文输入,且在损失计算中被mask;预测损失仅作用于最终转化商品的语义token:
其中, 为第 阶段的平均负对数似然损失, 为模型参数, 为模型给出的条件生成概率; 为目标token的位置, 为该位置的真实token, 为它之前的真实目标token序列, 用于按目标序列长度归一化。多阶段课程为同一转化样本提供不同难度的条件化训练任务,监督目标始终保持为真实转化商品,模型无需额外学习从BOS到人工构造课程的生成转移。
目标商品信息仅用于训练阶段的课程组织。无课程任务取 ,其输入与标准GR一致,线上无需执行目标条件化的课程检索或选择。
2.4 课程权重调度与训练推理对齐
我们使用随训练进度变化的阶段权重,联合优化各课程任务及无课程任务。设当前训练步数为 、总训练步数为 ,归一化进度为 。每个辅助课程设置一个进度中心 ,按照由易到难的顺序安排其优化重心;无课程任务的中心设在训练末期 。各任务的未归一化权重为:
其中, 表示任务 在进度 处的未归一化权重; 和 分别控制辅助课程与无课程任务的权重曲线宽度,宽度越大,高权重覆盖的训练区间越长。将各任务权重归一化后,得到联合优化目标:
其中,分母遍历编号 的全部任务, 为归一化后的阶段权重,满足 ; 为总训练损失。低难度课程在训练前期获得较高权重,优化重点随后向高难度课程迁移,最后集中到无课程任务。不同任务的权重曲线可以重叠,使各阶段损失的贡献随训练进度连续变化。
这一调度使课程学习与标准任务之间形成平滑的优化过渡,缓解模型对辅助课程条件的依赖。推理时,Decoder从行为控制的BOS直接生成目标商品语义ID,不进行课程构造,也不引入额外课程前缀,保持标准GR的服务流程。
3. 实验:离线效果、服务效率与线上收益
3.1 离线效果
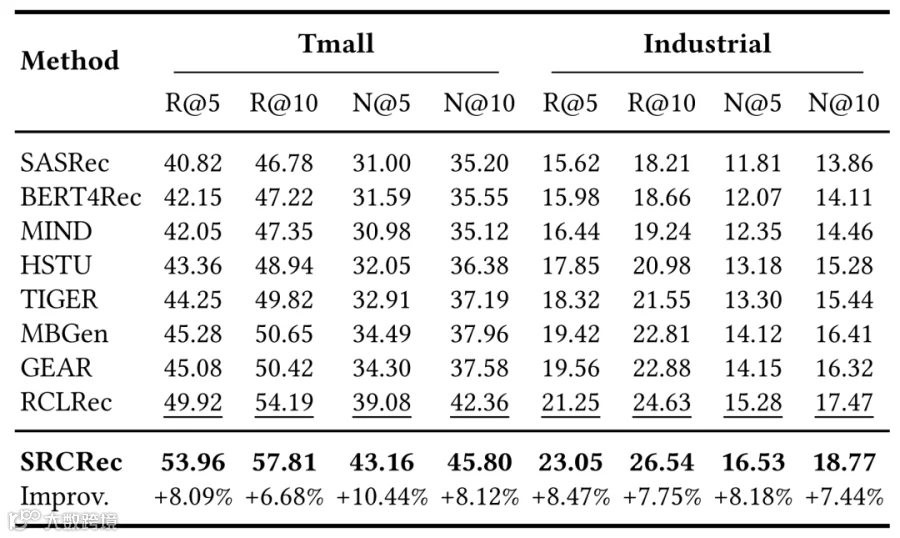
表1:Tmall与工业数据集上的离线结果。R和N分别表示Recall与NDCG,指标数值以百分数展示;加粗和下划线分别表示最优与次优结果,Improv.为相对最强基线的提升。
SRCRec在两个数据集的四项指标上均取得最优结果。相对最强基线RCLRec,Tmall上的提升为6.68%—10.44%,工业数据上的提升为7.44%—8.47%,表明多阶段课程构造与优化调度进一步改善了转化商品的召回和排序效果。
3.2 服务效率与训练开销
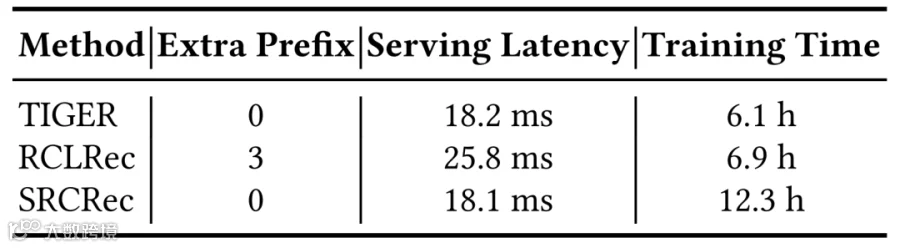
表2:额外推理前缀长度、服务时延与训练耗时对比。
SRCRec采用无课程前缀推理,服务时延为18.1 ms,与TIGER的18.2 ms相当。多阶段课程的额外计算主要发生在离线训练侧,训练耗时为12.3小时,线上保持标准GR的推理流程。
3.3 Lazada推荐广告平台在线实验
我们于2026年5月12日至19日在Lazada推荐广告平台开展在线A/B实验,使用随机抽样的20%流量,以TIGER为基线。SRCRec带来订单量提升3.52%、GMV提升2.98%,验证了多阶段逆课程学习在实际推荐广告业务中的转化收益。
通过目标条件化的课程难度建模、时间有序的多阶段课程构造,以及面向原始任务的优化调度,我们将稀疏转化预测组织为由易到难的学习过程。SRCRec在不增加线上课程构造与解码前缀开销的前提下,取得了离线指标和线上业务收益的共同提升。
4. 关于我们
我们是阿里国际-智能技术-Lazada推荐广告算法团队,我们致力于融合前沿深度学习、生成式推荐、用户超长序列建模、多场景建模、大模型算法等技术构建工业级推荐大模型,通过更深刻地洞察用户个性化偏好与决策逻辑持续助力商家投放效益与平台收益的快速增长。近年来,我们在前沿算法领域持续深耕,已经在WWW、SIGIR、CIKM、WSDM等顶级学术会议发表了多篇高质量论文。也欢迎感兴趣的同学加入我们,共同开创AI推荐的新篇章。
点击上方名片,关注我们吧~