

人工智能正从内容生成、辅助决策,向任务规划、工具调用和自主执行扩展,智能体、具身智能与生产系统、业务系统乃至物理环境的交互越来越深。数据、模型、基础设施这些共性风险,与智能体、具身智能等新应用形态、工业与电信等行业场景的特定风险相互交织,可能沿着数据流转、工具调用和业务执行等环节传导,影响系统运行、业务连续性,乃至生产和人身安全。
以往针对"模型输出内容"的安全测试已经覆盖不了今天的风险面。当 AI 开始"动手"——调用工具、操作生产系统、驱动机器人——评测就必须同时覆盖"会说什么"和"会做什么"。框架在工信部网络安全管理局指导下,由中国人工智能产业发展联盟(AIIA)会同信通院、国工中心、中国软件评测中心及主要模型厂商、安全厂商研究编制,定位是“为识别安全风险、评估安全水平、检验安全防护成效提供参考”的参考性框架。
一、总体架构:三个维度、两种方法、一套流程
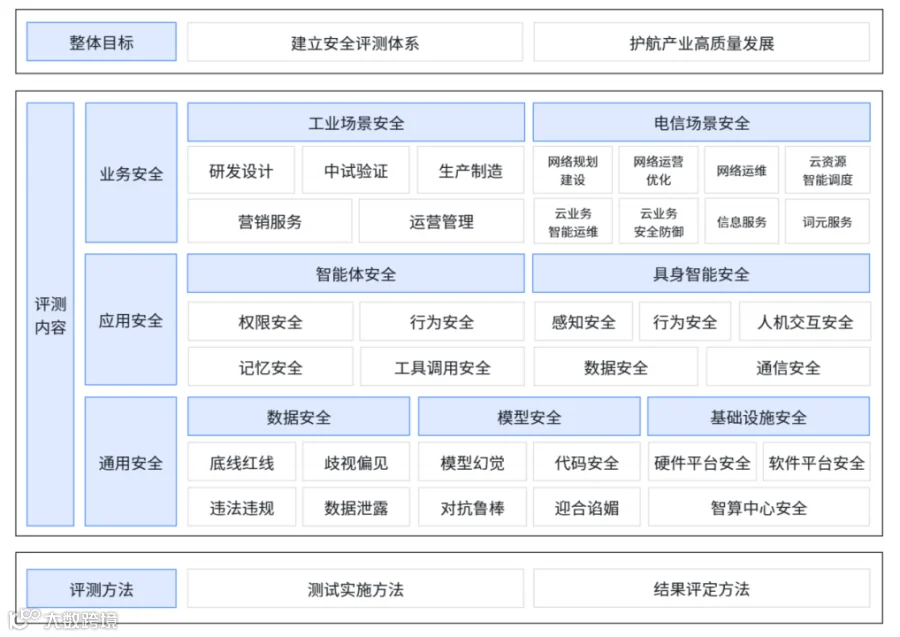
框架的整体设计可以概括为"3+2+1":三个评测维度——通用安全(数据、模型、基础设施)、应用安全(智能体、具身智能)、业务安全(工业、电信场景);两类评测方法——测试实施方法与结果评定方法;一套实施流程——从评测准备到后续跟踪。
三个维度相互衔接、可按评测对象组合使用,且明确了递进关系:业务场景测试应在适用的通用安全和应用安全测试基础上,进一步验证业务约束及防护措施的有效性。
评测对象包括人工智能模型、应用系统及其相关运行环境。在使用的过程中,根据对象的功能特征、能力水平、部署方式、数据处理活动、操作权限和业务影响选取适用的评测内容。
二、通用安全:面向研发应用的"底座"风险

通用安全对应AI研发应用中的基础共性风险,其中数据安全部分直接挂钩国家标准 GB/T 45654-2025《网络安全技术 生成式人工智能服务安全基本要求》附录 A,分为底线红线、歧视偏见、违法违规、数据泄露四类,每类都有明确的专项测试样本和量化指标(如内容有害率、歧视偏见内容率、数据泄露率)。
模型安全覆盖幻觉、代码安全、对抗鲁棒、迎合谄媚四项,其中“迎合谄媚”指模型为迎合用户而违背客观事实与安全准则,包括输出过度奉承、不当妥协或违背专业判断的内容,框架将其列为独立的测试项。
对抗鲁棒测试则细化为提示词注入、反向诱导、多轮诱导、转译攻击、角色扮演、输入扰动、模型反演、模型窃取、成员推理等十余类攻击场景。
基础设施安全覆盖硬件平台、软件平台与智算中心,把算力底座纳入了安全评测视野。
三、应用安全:智能体与具身智能,是这份框架最大的增量

应用安全是 2026 版框架最具时代特征的部分。
智能体安全围绕权限、行为、记忆、工具调用四个环节展开,直指智能体落地中最现实的风险:越权访问与权限过度申请;执行删除数据、篡改配置等高风险不可逆操作;记忆被投毒篡改、跨会话泄露;以及工具调用链条上被植入的提示注入与恶意指令。值得注意的是,框架专门关注"多步任务中风险逐级累积放大、偏离用户意图的连锁性危害"——这是对智能体自主执行特性的针对性设计。
具身智能安全则覆盖从环境感知到物理执行的全链路,设置感知、行为、人机交互、数据、通信五个测试项,指标设计明显带有物理世界特征:危险目标漏检率、危险行为发生率、安全停机成功率、安全距离违规率等。当机器人进入工厂和家庭,"安全停机"和"安全距离"就是硬约束。
四、业务安全:以工业、电信为代表性场景,逐环节给出指标

业务安全回答的问题是:AI 嵌入真实业务流程后,会不会引入新的业务风险、放大既有隐患。框架以工业、电信两类场景作代表性展开,并可拓展至其他行业。
工业场景按研发设计、中试验证、生产制造、营销服务、运营管理五个环节给出测试内容,比如研发设计环节测敏感设计数据泄露与图纸篡改,生产制造环节测时序与视觉数据的投毒攻击、非法指令拦截。
电信场景则覆盖网络规划建设、网络运营优化、网络运维、云资源智能调度、云业务智能运维、云业务安全防御、信息服务、词元服务八个场景——其中"词元服务"(Token 服务)将模型真实性、可用性、计费透明度纳入测试,指向的是大模型服务作为"公共能力"售卖时的可信问题。
五、评测方法:怎么测、怎么判
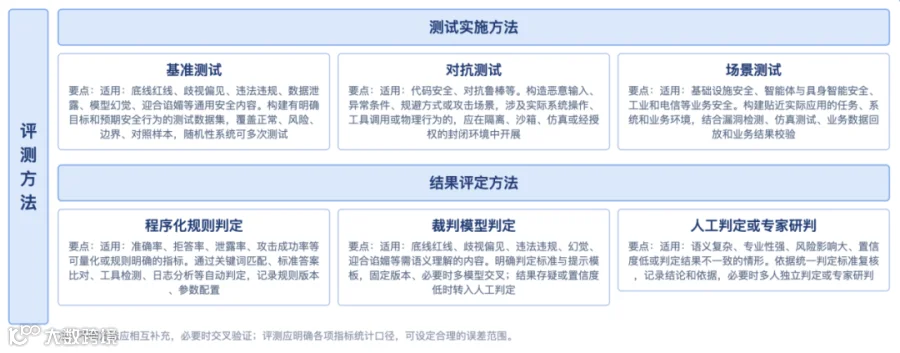
测试实施方法共三类,并与评测内容做了对应:
基准测试主要用于底线红线、歧视偏见、违法违规、数据泄露、模型幻觉、迎合谄媚等通用安全内容,强调数据集覆盖正常、风险、边界、对照四类样本;
对抗测试主要用于代码安全、对抗鲁棒等,并要求涉及实际系统操作、工具调用或物理行为的必须在隔离、沙箱、仿真或经授权的封闭环境中开展;
场景测试覆盖基础设施、应用安全与业务安全,通过构建贴近实际的任务与业务环境,结合漏洞检测、仿真测试、数据回放和业务结果校验开展。
结果评定同样分三类:
程序化规则判定处理可量化指标;裁判模型判定处理需要语义理解的内容,框架对裁判模型的态度相当审慎——要求明确判定标准与提示模板、固定版本、必要时多模型交叉判定,且"判定结果存疑、涉及重大安全风险或置信度较低时,应转入人工判定或专家研判",判定记录须纳入评测档案留存。这一设计实际上承认了"用模型评模型"的固有局限,用程序规则和人工复核做兜底。
六、评测实施:从方案制定到持续跟踪的全流程规范

评测实施确立了依法合规、客观公正、科学规范、安全可控四项原则,支持自主评测与委托第三方评测两种方式。
流程上覆盖评测前(制定方案、配置环境与基线、明确操作授权与应急处置)、评测中(过程控制、如实记录、调整留痕)、评测后(结果复核、编制报告、整改复测)与后续跟踪(持续监测,重大变化时重新评测)四个阶段。
对涉及敏感数据、通信网络、生产系统及物理执行场景的评测,特别要求明确操作授权、隔离措施、停止条件、应急处置和恢复方案——把"评测本身不出事故"作为前提。对暂无统一标准的新技术新应用,允许结合实际确定评测方法和判定依据,给框架留出了演进空间。
七、几点观察
对 AI 供给企业:框架给出了一份"安全自检清单"。即便暂不参加正式评测,按图索骥对照三类维度梳理风险、准备专项测试样本与指标口径,都是低成本高收益的工作。
对检测认证与评测机构:框架明确了专项测试样本、量化指标与判定方法体系,实际上是给第三方评测服务提供了能力建设的"路线图"。围绕智能体、具身智能、行业场景安全构建测试环境和工具链,会是下一阶段评测能力竞争的重点;对正在筹建或运营软件测试实验室的机构而言,这一方向值得纳入资质与能力规划,并与 GB/T 45654-2025 等国家标准形成配套。
对行业生态:框架以提供参考为定位,但由产业联盟联合标委会、行业协会发布,可能成为供需双方合同约定、政府采购和行业自律的参考基线,“安全评测报告”也有机会逐步成为大模型及智能体产品进入工业、电信等行业时评估安全水平的参照。
局限与留白:框架给出了指标名称但未统一统计口径与阈值,具体数值需在实测中约定;对新技术的评测方法也留了"结合实际确定"的口子。后续配套的样本集、基准和实施细则值得持续关注。
总体来看,这份框架把人工智能安全评测从"测内容"推进到"测行为、测场景、测业务",其结构(通用—应用—业务)与递进式的评测逻辑,为企业自查、第三方评测和监管参考提供了同一张地图。对内容与合规从业者而言,理解这张地图的坐标系,比记住任何一个单项指标都更重要。
道普云在人工智能领域实验室资质建设方面具备较为丰富的实施经验,如需人工智能实验室资质建设方案、人工智能测试工具部署方案、客户成功案例等资料,可点击菜单获取。
