

医疗模型做错一道题,问题可能只出在某一步:影像已经看对了一部分,临床线索也找到了,却在鉴别诊断时走偏。MedEvo 关注的是,如何保留这些有效判断,让模型从出错的位置继续推理,并把修复后的过程用于训练。
论文报告,经过三轮数据更新与监督微调,9B 模型在七项医学多模态基准上的平均准确率从 65.57% 提升到 69.12%。理解这项工作,可以从医疗模型如何学习、如何利用错题说起。
论文题目:MedEvo: Medical Reasoning Evolution through Knowledge Navigation
论文链接:https://arxiv.org/abs/2610.17690
项目主页:https://pork-pay.github.io/MedEvo/
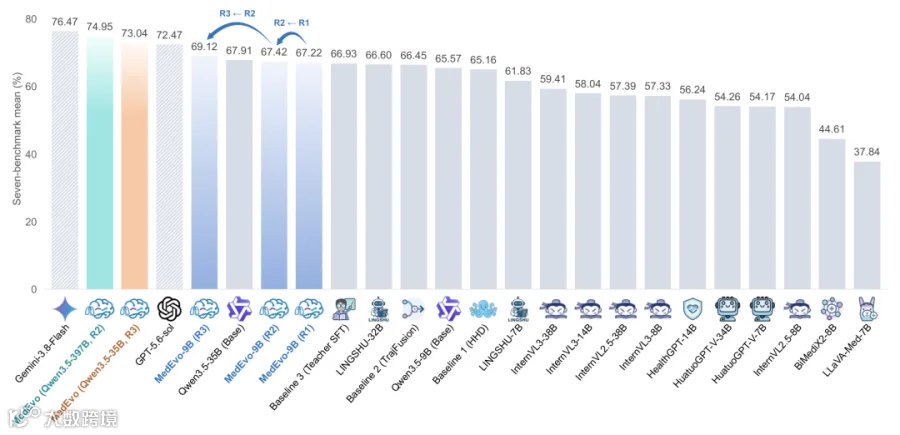
图1|不同模型在七项医学多模态基准上的平均准确率及 MedEvo 的多轮表现。
现有研究的研究路线与待解问题
围绕医疗模型如何学习与改进,学界和业界已经探索出几条相互关联的路线。这里可以归纳为三个方向:
医学多模态推理与监督质量:已有研究通过医学图文指令微调、知识融合与教师蒸馏增强模型能力,并进一步关注推理过程的质量:视觉识别是否准确、知识应用是否恰当、证据是否支持结论,以及训练材料是否适合学生模型。难点在于,答案正确并不一定意味着推理有充分依据,更强教师的解析也未必适合学生学习。
从失败中学习与局部修复:LEMA(Learning from Mistakes)利用错误与修正配对,TrajFusion 融合错误和正确推理轨迹,HHD(Hindsight Hint Distillation)用简短提示引导恢复;回退与选择性重生成则研究从哪里重新开始,让失败过程也能成为训练材料。难点在于,既要找到关键错误,也要保留有依据的步骤,并检查修复后的推理是否真正可供学习。
数据演化与递归自我改进:STaR(Self-Taught Reasoner)和 ReSTEM(Reinforced Self-Training with Expectation–Maximization)筛选模型生成的推理,形成后续训练数据;MediSkill-Evo 等医学研究则更新外部知识库而不修改模型参数。这些工作关注如何让反馈持续改善模型或其外部知识。难点在于,训练题上表现更好,不一定能转化为新题上的提升,下一轮的数据选择仍需对准模型的能力缺口。
沿着这些研究,MedEvo 关注两个相连的问题:一条失败推理应该从哪里修,修复之后下一轮又该优先练什么。
MedEvo 用“知识导航”(Knowledge Navigation)连接这两个问题:医学标签提供题目的知识背景,错误诊断定位需要修正的推理环节,独立反馈再指向下一轮的训练重点。知识导航由此贯穿“在哪里介入、如何恢复、下一步学什么”,将单条推理的修复与多轮训练的数据更新连接起来。
知识导航的第一步 定位推理偏差
保留有效步骤 从关键错误处修复:一条推理轨迹是模型从观察图像、理解问题到给出答案的过程。MedEvo 先定位关键错误,保留错误之前有依据的推理,即“有效前缀”,再让同一个学生模型生成后续内容。

图2|局部修复示意。保留已有的有效推理,在简短提示后继续生成。
提示的作用是指出需要重新检查的方向。例如,模型若误读了视觉线索,就应回到图像证据;若在鉴别诊断时走偏,则需要重新比较候选解释。修复结果经过筛选后,才成为后续监督微调的材料。
知识导航的下一步 找准训练方向
知识导航通过推理生成、局部修复、数据筛选和反馈选题形成循环。医学标签描述题目的模态、解剖、疾病与难度;错误类型区分视觉误读、推理错误、鉴别诊断错误和知识缺口。前者帮助组织题目,后者帮助确定修复方向。
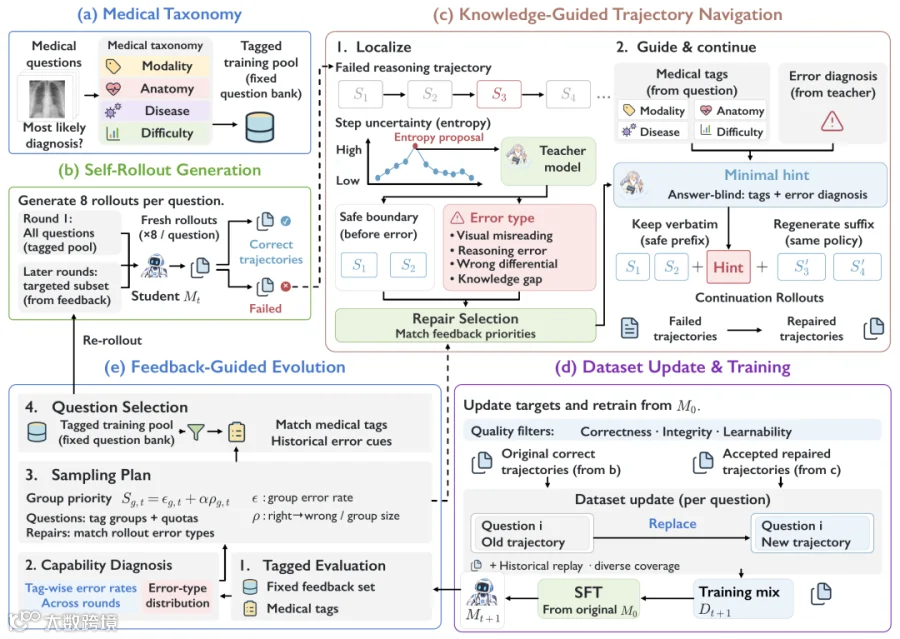
图4|MedEvo 总体框架。每轮根据修复结果与独立反馈更新训练数据。
定位并给出提示:不确定性信号提出候选检查区域,审核模型结合题目、图像和推理定位关键错误。按论文设计,审核模型不接触标准答案、参考解析或答案衍生标签,提示不应包含答案选项或完整正确解析。
续写并筛选:学生保留有效前缀,重新生成后缀。候选结果通过答案正确性、修复边界、内容完整性和可学习性检查后进入训练集。最终评测不提供纠错提示。
根据反馈安排下一轮:方法在独立的固定反馈集上观察错误率与退步情况,从训练题池集中优先选择相关问题。每轮微调都从同一初始模型开始,跨轮积累的是更新后的训练数据。
实验结果
评测覆盖 PMC-VQA、VQA-RAD、SLAKE、PathVQA、OmniMedVQA、MedXpertQA-MM 和 MMMU-Med,报告准确率及七项等权平均。下表同时展示同骨干训练方法和不同模型的表现。
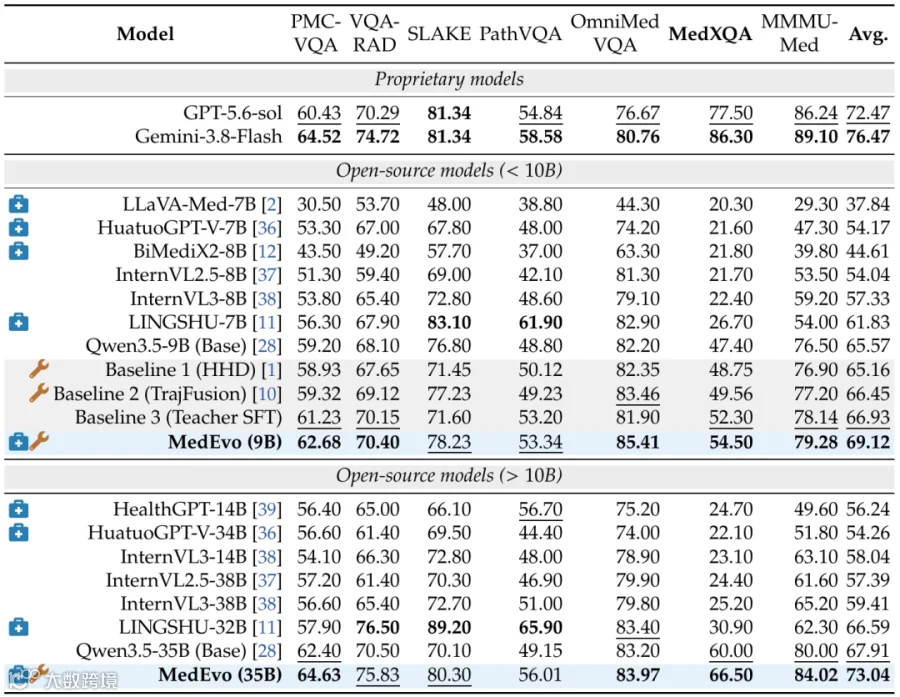
表2|七项医学多模态基准的主结果。Avg. 为七项等权平均,MedXQA指 MedXpertQA-MM,Base 为训练前模型。
三个基线中,HHD 用提示引导纠错并形成训练材料,TrajFusion 融合错误与正确推理轨迹,Teacher SFT 使用 Qwen-3.8-Max 生成的解析训练学生模型。
在相同 9B 骨干上,MedEvo 的平均准确率为 69.12%,分别高于 HHD、TrajFusion 和 Teacher SFT 3.96、2.67 和 2.19 个百分点;七项基准均高于初始模型,MedXpertQA-MM 的增幅最大,为 7.10 个百分点。
多轮训练与更大模型
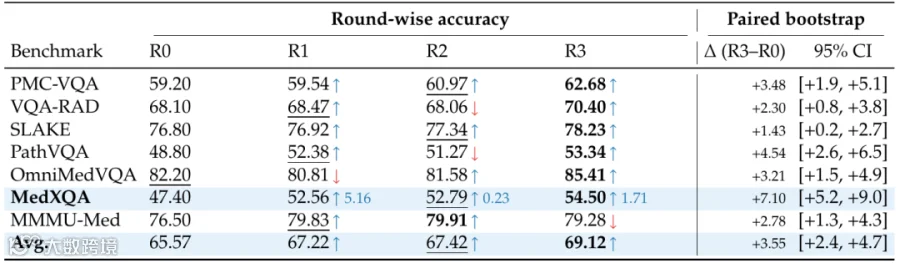
表3|9B 模型逐轮表现及提升的 95% 置信区间。R0 为初始模型,R1—R3 为各轮结果。
9B 模型的平均准确率依次为 65.57%、67.22%、67.42% 和69.12%。平均提升的 95% 置信区间为 +2.4 至 +4.7 个百分点,七项基准的提升区间均未跨过零。
平均表现上升的同时,单项任务仍有波动:例如 MMMU-Med 从第二轮的 79.91% 降至第三轮的 79.28%。论文另报告,三次独立训练的第三轮平均准确率为 69.09%,样本标准差为 0.24 个百分点。

表6|35B 与 397B 模型在各轮训练后的表现。
35B 模型经过三轮训练,平均准确率从 67.91% 提升到 73.04%;397B 模型经过两轮训练,从 71.83% 提升到 74.95%。两种规模均获得平均收益,最优轮次仍可能因任务而异。
论文表 1 还显示,9B 模型各轮送修问题数从27,233 减少至 23,620,平均尝试次数从 3.37 降至 2.12。这反映问题级修复工作量减少,知识导航的修复是有效的。
哪些设计带来了收益
消融实验分别考察局部修复方式与跨轮反馈。前一组比较第一轮训练结果,后一组从共同的第一轮模型与历史数据出发,继续训练两轮。
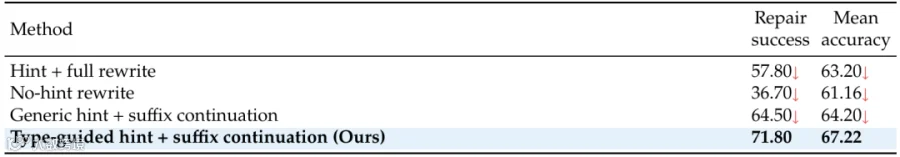
表4|第一轮修复设计消融。左列为修复方式,右侧为修复成功率和下游平均准确率。
“错误类型提示加后缀续写”获得 71.80% 的修复成功率和 67.22% 的平均准确率,均高于该组其他设置。提示加整段重写的平均准确率为 63.20%,通用提示加后缀续写为 64.20%,说明修复范围和提示内容都会影响后续学习。

表5|跨轮反馈消融。比较不使用反馈、去掉医学标签、去掉错误类型反馈以及完整方法。
完整方法在第三轮达到 69.12%,比不使用反馈高 2.45 个百分点。去掉医学标签和错误类型反馈后,第三轮分别为 67.53% 和 66.21%。这组结果支持在选题时同时考虑医学类别与错误诊断。
错题改对了 就一定学会了吗
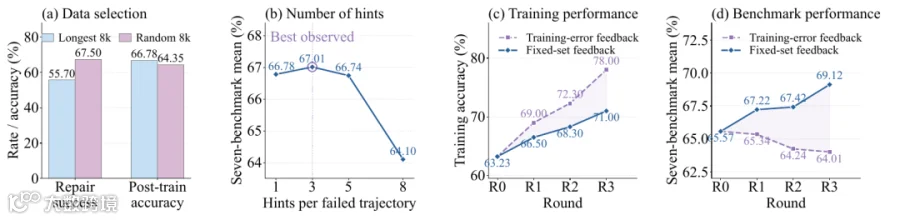
图5|数据选择、提示数量与反馈来源的联合分析。
容易修好的题 未必带来更大收益:最长失败推理的 8,000 题子集,修复成功率低于随机子集(55.70% 对 67.50%),训练后平均准确率却更高(66.78% 对 64.35%)。这一比较尚未单独隔离题目难度,但说明修复成功率不能直接代替学习收益。
增加提示并非持续有效:在同一最长推理子集上,1、3、5、8 条提示对应平均准确率为 66.78%、67.01%、66.74%、64.10%。3 条提示的观测结果最高,继续增加后下降。
独立反馈更能反映基准表现:使用训练集错误反馈时,第三轮训练准确率达到78.00%,基准平均准确率却降至 64.01%;独立固定反馈集对应的两项数值为 71.00% 和 69.12%。训练表现与基准表现需要分别观察。
反馈驱动会不会变成拟合测试集?
关键在于反馈来自哪里。MedEvo 用单独划分的固定反馈集诊断弱项、指导训练题选择和阈值校准,反馈题不进入训练目标;七项测试基准单独用于评测,测试结果不参与训练数据构建,阈值在最终评测前冻结。
因此,反馈集承担开发与验证用途,学习收益由独立测试检验。反复使用反馈集仍可能带来对它的适应,但这与利用测试结果调整训练不同,不能把反馈集上的进步直接当作泛化提升。
整体来看,MedEvo 的实验支持知识导航的两个相连环节:在单条推理中保留有效步骤并针对性修复,在多轮训练中依据独立反馈调整学习重点。证据目前主要来自医学问答基准,临床应用仍需验证;人工审核中,修复答案正确与图像证据支持的通过率分别为 88.3% 和 78.5%,表明答案与证据使用也需要分别检查。
结语
从错误中学习,不只是把答案改对,还要知道推理在哪里走偏,以及下一轮该补什么。MedEvo用“知识导航”把这两件事连接起来:在单条推理中保留有效步骤、修复关键错误,在多轮训练中根据反馈调整学习重点。
多医学多模态基准上的结果表明,这种训练方式能够带来平均性能提升。同时,实验也提醒我们:容易修好的题,不一定最值得学;训练题上的进步,也需要在新题上检验。
MedEvo所探索的,是让医疗模型既能从错误中恢复,也能从错误中找到下一步学习的方向。


扫描二维码获取
更多精彩
AI in Graph
本公众号主要介绍应用于图、知识图谱的人工智能算法和研究进展,及其在生物信息、医学健康领域的应用。欢迎关注本公众号获取领域最新文献解读。

点个在看+赞支持一下