

10 月 21 日,Recursive 放出第一款模型 Flint。联合创始人 Richard Socher 在 X 上发帖,到 22 日早上工具侧显示大约 125 万次展示、四千多个赞;同日 TechCrunch 跟进,Hugging Face 上挂了 BF16 全量和几档量化仓,Ollama 也上了约 23GB 的 flint:40b。
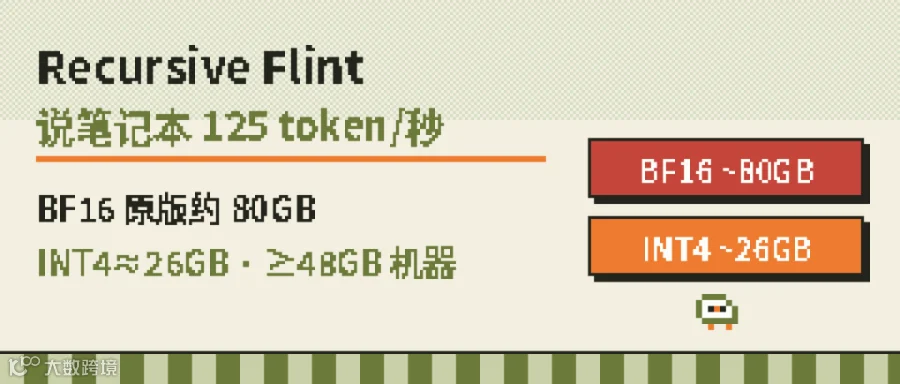
官方博客里最刺眼的是这句:在自家优化过的推理引擎上,M4 Pro 的 MacBook Pro 短上下文能跑到超过 125 token/秒,64GB 的 NVIDIA RTX Spark 超过 150。可你点开主仓 Files,BF16 权重合计大约 79.6GB,模型卡写明单卡要用 B300 或 H200 配 SGLang。
两句话都没错,对的不是同一条路径。我先把结论撂这:宣传里的「笔记本速度」对的是 INT4 / NVFP4 加上官方引擎 rec 或对应运行时,机器统一内存或显存官方建议至少 48GB;手里只有 24GB、32GB 卡的人,别被「笔记本」三个字带进去直接下 80GB 原版。分数目前全是官方自报,第三方复测还没气候。
01
PART
它是什么
WHAT IT IS
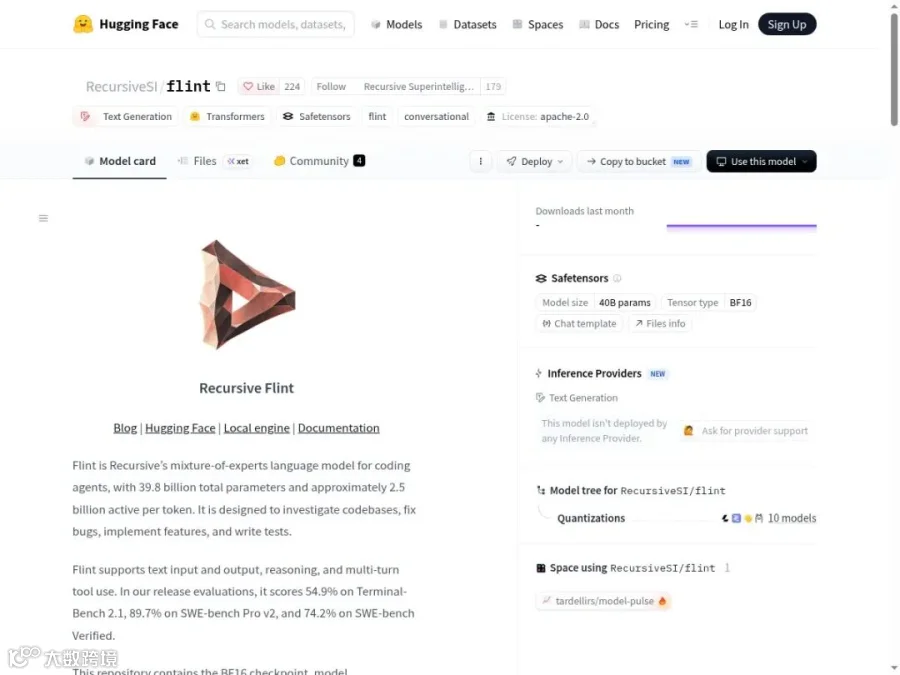
Flint 定位写得很直白:给编码代理用的本地模型,查仓库、修 bug、写功能、补测试。Recursive 说团队加上一批 agent,从零训出这套,用了不到四个月;中间大量实验靠他们叫 Eureka Machine 的自动研究系统。许可是 Apache 2.0,权重可下、可改、可商用,托管 API 的条款另算。
硬规格来自 Hugging Face 模型卡:总参数 39.8B,每个 token 大约激活 2.5B(含输出头;仅 body 约 2.2B);49 层(2 层稠密 + 47 层 MoE);每层 MoE 256 个专家,每次选 6 个,再加一个始终在线的共享专家;文档里的上下文配置是 262,144 token。官方博客另写「最高可到 512k,编码任务建议压在 256k 以内」——两处口径不完全一样,落地时以你用的运行时和模型卡为准。Ollama 页当前标的是 256K 上下文。
知识截止日期模型卡写的是 2026 年 6 月。接口走 OpenAI 兼容,支持多轮工具调用;官方示例接 pi、OpenCode。Transformers 建模代码模型卡写明「尚未包含」,BF16 主路径目前是仓内的 SGLang 套件。
官方博客把 Eureka Machine 的贡献写得很具体。架构搜索从「35B 总参 / 3B 激活」的基线出发,试了不同专家宽度和配置,最后落到现在的 40B / 2.5B。量化阶段,系统搜到的配方里有一条和常见做法相反:把输出层 lm_head 也压到 4bit。为了把精度找回来,他们加了一段离线蒸馏:量化模型在自采样的 coreset 上、以 16bit 为老师训练,官方说这比原来的量化感知训练基线少了将近一半步数。内核侧,在 M4 / M5 上做出了把整个 decode 前向熔在一起的 Metal megakernel。读到这你大概能明白:宣传里的速度,很大一块来自「模型结构 + 量化 + 专用核」绑在一起,而不是只换一份通用 GGUF。
02
PART
能不能本地跑:先看文件大小
WILL IT FIT
我把官方几个仓的文件列表过了一遍(Hugging Face,10 月 22 日早上):
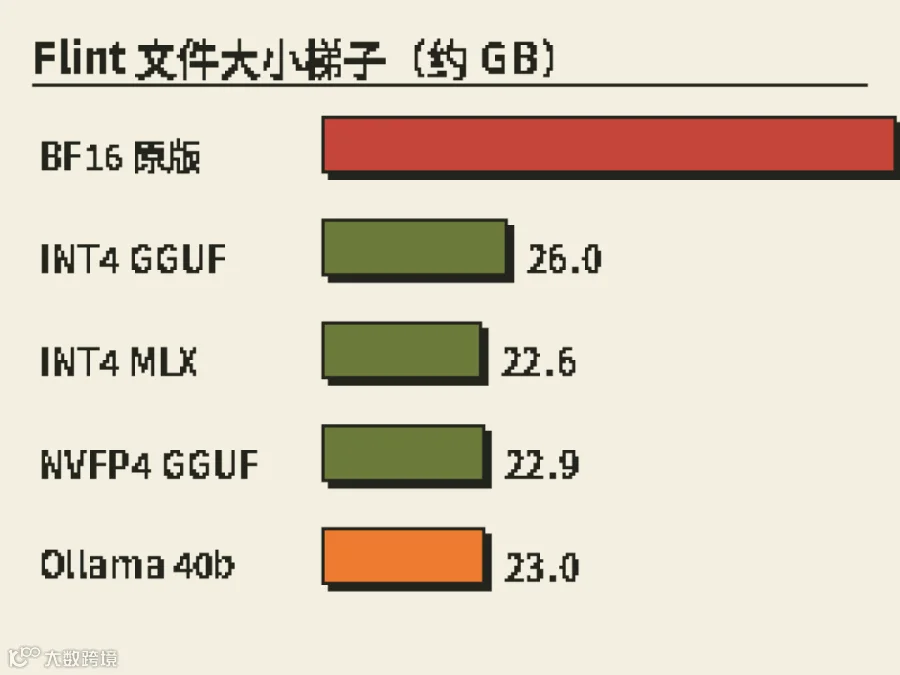
BF16 原版约 79.6GB(RecursiveSI/flint),单卡 B300 / H200 + SGLang;INT4 MLX约 22.6GB(flint-int4),给 rec / Apple Silicon;INT4 GGUF Q4_1约 26.0GB(flint-int4-gguf),Apple Silicon 统一内存 ≥48GB;NVFP4 GGUF约 22.9GB(flint-nvfp4-gguf),NVIDIA 显存/统一内存 ≥48GB;Ollama flint:40b约 23GB。
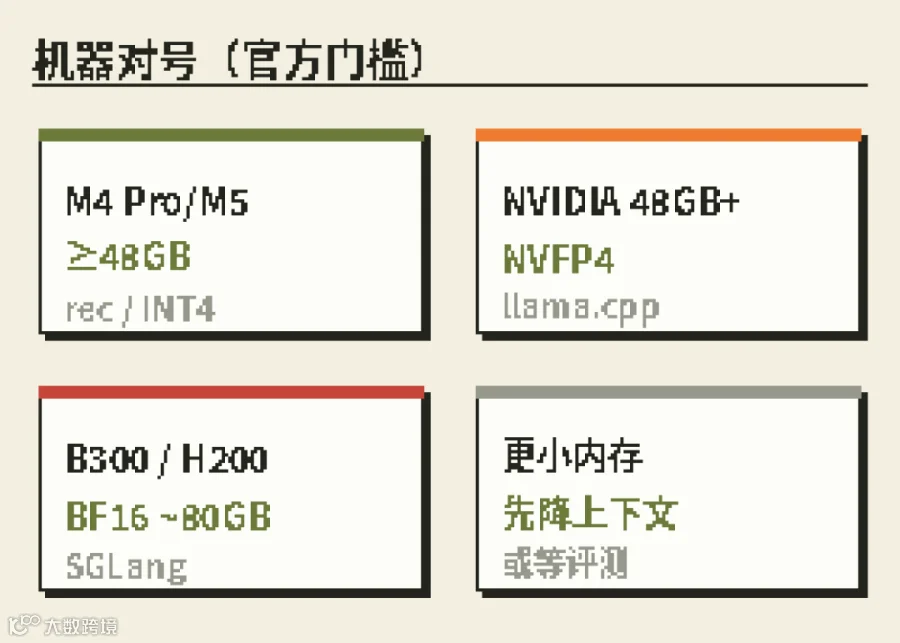
「笔记本 125 token/秒」对得上的,是 INT4 这一路,再配官方引擎 rec:要求 M4 Pro / M5 Pro / M5 Max,统一内存至少 48GB,磁盘大约再留 30GB。rec 仓库自己写,同机同 4bit 权重上,比 llama.cpp 吞吐高约 1.4–2.6 倍(M4 Pro 48GB,官方图)。没有这档芯片或内存不够,rec 会直接拒绝下载。
NVIDIA 侧官方给的是 NVFP4 GGUF,测过 B300、RTX PRO 6000 Blackwell、RTX Spark、DGX Spark,建议至少 48GB。数据中心想跑满精度,走 BF16 + 仓内 docker / SGLang,下载注释写着 about 80 GB。
社区也很快跟了:Unsloth、LM Studio Community 都有 GGUF 分档。社区量化方便试,质量以你自己的任务为准;官方博客另有一句:Eureka 搜出来的 NVFP4 配方,在他们自己的榜上和 16bit 差不超过 0.7 分——这是厂商自测,不是第三方榜。
拿昨天的 Ornith-1.5-122B 对照一下:Ornith 的钩子是「单卡 80GB」对上原版 250GB,真正塞进单卡的是 4bit;Flint 的钩子是「笔记本速度」对上 BF16 约 80GB,真正对得上宣传速度的是 INT4 / NVFP4 加专用引擎。两条线都在回答同一件事——开源权重要先看文件形态,再看你的机器。
文件大小只是权重。跑起来还要给 KV 缓存和运行时留空间。官方 INT4 GGUF 说明也提醒:示例命令开满 262K 时,内存不够就先把 -c 降下来。
03
PART
四条上手路径
HOW TO TRY
最省事:Ollama。库页目前标 flint:40b / latest,大约 23GB。装好之后一行拉取即可;机器内存要明显高于 23GB 才从容,长上下文再多留。
苹果且内存够:优先 rec。官方安装脚本装到 ~/.local/bin,rec doctor 过硬件,再在项目目录 rec launch pi(官方更推荐 pi)或 rec launch opencode。第一次会下模型和配套 harness;用完 rec stop。要接自己的客户端,就 rec serve,基址 http://127.0.0.1:11500/v1,模型名 flint,密钥用 rec auth token。
苹果但想用通用栈:llama.cpp + INT4 GGUF。官方给了 llama-server 示例,-ngl all,采样温度 1.0、top-p 0.95、top-k 20,并强调加 --jinja、多轮时保留 reasoning_content。仓里还带了 pi / OpenCode 的配置文件。
有 B300 / H200:按模型卡 SGLang 套件。hf download RecursiveSI/flint(约 80GB),docker 起 serve_b300.sh 或 serve_h200.sh。硬题官方建议输出预算至少 32768(含推理过程)。
命令摘自官方文档与模型卡(10 月 22 日)
# A. Ollama
ollama run flint:40b
# B. rec(M4 Pro / M5 Pro|Max,≥48GB)
curl -fsSL https://raw.githubusercontent.com/recursive-oss/rec/main/install.sh | bash
rec doctor && rec launch pi
# C. llama.cpp + 官方 INT4 GGUF(≥48GB 统一内存)
hf download RecursiveSI/flint-int4-gguf flint-int4-q4_1.gguf --local-dir ./flint-int4-gguf
llama-server -m ./flint-int4-gguf/flint-int4-q4_1.gguf --alias flint -ngl all -c 65536 --jinja --temp 1 --top-p 0.95 --top-k 20
# D. BF16 + SGLang(B300/H200)
hf download RecursiveSI/flint --local-dir flint # about 80 GB
04
PART
分数怎么读,冷水在哪
COLD WATER
官方模型卡自报(温度 1.0、top-p 0.95、top-k 20;agent 分数为至少五次平均 pass@1):Terminal-Bench 2.1 为 54.9%,SWE-bench Pro v2 为 89.7%,SWE-bench Verified 为 74.2%。Terminal-Bench 用 Terminus 2,且「靠网页检索拿到的解」算失败;SWE 用 mini-swe-agent。博客还写,在总参数不到 50B 的 MoE 里,这三项他们自称领先。
这些数字全部是 Recursive 自己的评测设置。博客里还有一张「多项均值 + 速度」对照图,速度口径写的是:一次 128k token 会话全程的平均 token/秒,不含 prefill。到 22 日早上,我还没看到成体系的第三方榜把 Flint 嵌进去复测。引用时请写「官方自报」,别写成「业界实测第一」。
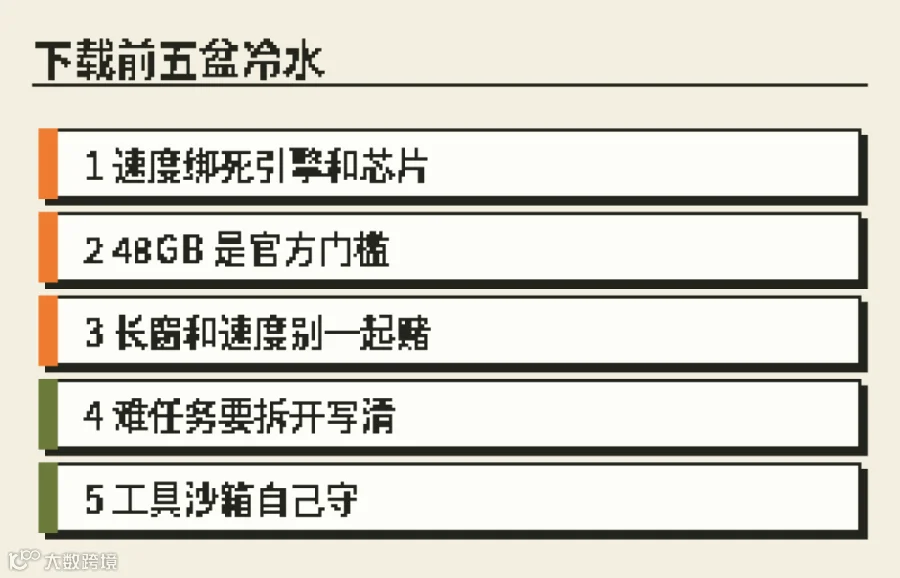
下面几盆冷水,下载之前过一遍:
第一,笔记本速度绑死引擎和芯片。125 / 150 token/秒来自官方博客,条件是短上下文 + 他们的优化栈;换成通用 llama.cpp,同机官方自己也承认会慢一截。
第二,48GB 是官方门槛,不是「能开机」的最低想象。INT4 GGUF 写明至少 48GB 统一内存;更小内存的 Mac 也许能靠更狠的社区量化挤进去,那是另一条未经官方背书的路。
第三,长窗和速度不要一起赌。模型卡上下文 262K,博客提到最高 512k、建议 256k;开满长窗时 KV 缓存会吃掉你为「文件刚好塞进内存」省下的余量。
第四,复杂任务要拆。官方自己说,难任务请拆成小步并写清指令,它可能比你习惯的大闭源编码模型更需要引导。
第五,安全边界要你自己守。模型卡写明:仍可能产出错误或有害代码、不当工具调用;工具权限和执行沙箱必须由应用层加。
05
PART
谁该现在试,谁可以等
WHO SHOULD TRY
现在值得试:代码不能出内网、又有 48GB 以上 Apple Silicon 或同级 NVIDIA 机器的人;已经在用 pi / OpenCode,想把日常编码代理挪到本地的人;有 B300 / H200、想评一份 Apache 2.0 编码 MoE 的团队。
可以先等等:只有 24GB、32GB 显卡或统一内存的人——官方路径对不上;主要靠云端 API、也不在乎代码出网的人,没必要为了首日热度拉几十 GB,等第三方复测和更多真实仓库案例再定。
对做应用的人,这意味着三件具体的事。一是合规叙事好讲:Apache 2.0 本地部署,代码和日志可以不出网。二是成本账能算:没有按 token 账单,代价变成电费、机器折旧和你维护运行时的时间;若你一天只偶发问几句,云端 API 可能更便宜。三是产品形态清晰:官方已经把 pi、OpenCode 接到本地 OpenAI 兼容口,最小闭环可以是「本机模型服务 + 现有 agent 壳 + 20 个仓库回归集」。
我的态度:Flint 值得记一笔,是因为它把「本地编码代理」从口号落成了可下载的 Apache 2.0 权重,并且把 Mac / NVIDIA / 数据中心三条路拆开了。但「笔记本 125 token/秒」省掉了芯片代际、内存门槛和专用引擎;89.7% 的 SWE-bench Pro v2 也还只是厂商数字。先拿你自己的 20 个真实仓库任务并排跑,比任何一张官方图都管用。
CHECKLIST
对机器 → 挑一档文件 → 只下单个文件 → 用 20 个真实任务回归 → 再决定是否换掉现在的 API
照着做:① 先对机器:M4 Pro/M5 且 ≥48GB → rec 或 INT4 GGUF;NVIDIA ≥48GB → NVFP4 GGUF;B300/H200 → BF16+SGLang;更小内存先看 Ollama 能否在降上下文后稳住。② 用 hf download 只拉需要的单个文件。③ 采样先用官方默认温度 1.0 / top-p 0.95 / top-k 20;多轮保留 reasoning 字段。④ 上下文先开 32K 或 64K,稳了再加。⑤ 拿 20 个真实任务和现在的 API 模型并排,记成功率、耗时、失败样例。⑥ 文中分数均为官方自报。⑦ 若走 rec,先跑 rec doctor;NVIDIA Spark 的 rec 支持官方写的是路线图,现状优先 NVFP4 + llama.cpp。⑧ 工具调用务必加沙箱。
很多人卡在第 ⑤ 步:模型跑起来了,却不知道怎么写成一份能报价的交付——比如给团队搭不出内网的编码助手,过关标准怎么写、维护谁来做。
你会等更完整的社区量化评测,还是机器够了就直接上 rec / Ollama?评论区聊聊。
出处:Recursive 官方博客 Introducing Flint(2026-10-21)、Hugging Face RecursiveSI/flint 及 flint-int4 / flint-int4-gguf / flint-nvfp4-gguf 模型卡与文件列表(10月22日查看)、GitHub recursive-oss/rec、Ollama 库页 flint、X @RichardSocher(10月21日)、TechCrunch 同日报道。
往期 · 接着看
Ornith开源122B说单卡能跑:原版250GB,真正塞进80GB的是4bit版
MiniMax揭晓Space Bunny:M3.1 Flash官方自报200T+,权重要到10-23
Blockway发Volundr 32B v1:SWE循环36/50变0,16GB自称开262K
「AI商业实战」新人邀请礼遇 ¥25,进圈可领两张短卡:「交付定义卡」把买家、交付文件、过关标准、改稿轮次一次写清;「一周试跑清单」按天跑通一个最小交付闭环。不保证接单,帮你少走弯路。
工具会用了,下一步是把它变成能交付的活。「AI商业实战」里有人在做本地模型部署和编码代理的实单,欢迎来交流。
点文末「阅读原文」开启 AI 实战交流
觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING