

新智元报道

AI正式进军物理世界,语言模型在具身智能领域谁能称王?通用大模型是否会碾压机器人专用策略?近日,GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5及Gemini 4 Argon等全球顶尖多模态大模型齐聚常态化具身智能仿真评测平台RoboColiseum(机器人角斗场),展开实测对决。本次测试不仅揭示了当前顶尖模型的具身能力现状,更暴露了其在物理控制层面的关键短板。
四款顶尖模型实测:Claude夺冠,通用操作仍是短板
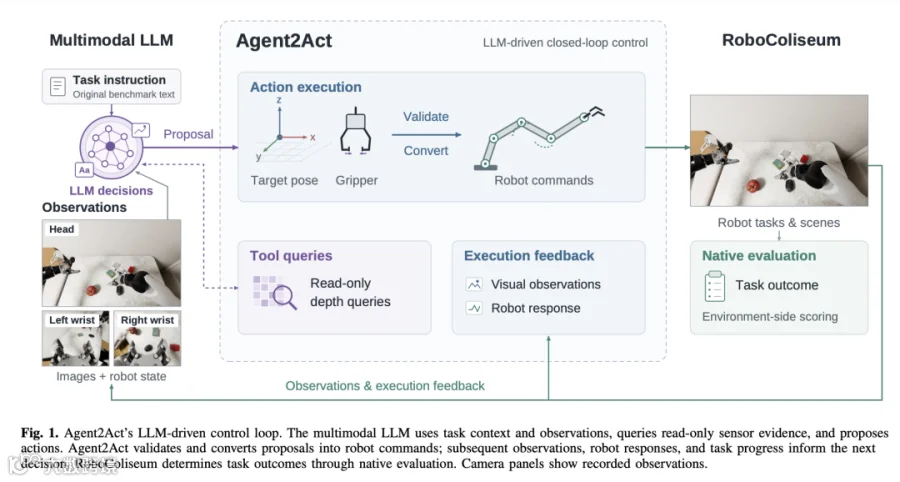
本次测试所有模型均接入统一控制框架Agent2Act,在相同任务与指令下进行标准化评估。
Claude综合领跑,呈现“高智商、低动手”特征
综合榜单显示,Claude Opus 5.5以76.28%的总分位居第一,GPT-6 Astra以75.99%紧随其后。在指令跟随和空间理解等认知类任务中,大模型得分显著优于传统机器人专用策略模型。

然而在开门、倾倒、上货等复杂连贯动作的“通用操作”环节,四大顶尖模型表现均不及专用Policy模型Paimon。这表明当前大模型普遍存在“眼高手低”现象:认知与规划能力强,但物理执行能力仍有欠缺。

各模型优势分化,图像质量成共同痛点
除综合实力外,各模型在不同维度表现出差异化优势:
- Claude Opus 5.5:全能型选手,空间理解与通用操作能力领先;
- GPT-6 Astra:指令跟随与抗扰动能力最强;
- GPT-6.1 Sol:性价比突出,Token消耗与性能平衡最佳;
- Gemini 4 Argon:长程任务(如包裹分拣)表现惊艳,抗扰动能力优于Sol。
图像鲁棒性不足是共性缺陷。在引入噪点、遮挡等图像扰动后,所有模型性能均下降,其中Sol降幅最大(-0.77分),Astra次之(-0.32分)。这为真机部署中的视觉稳定性敲响了警钟。

缺乏物理常识与历史记忆,精细操作仍存瓶颈
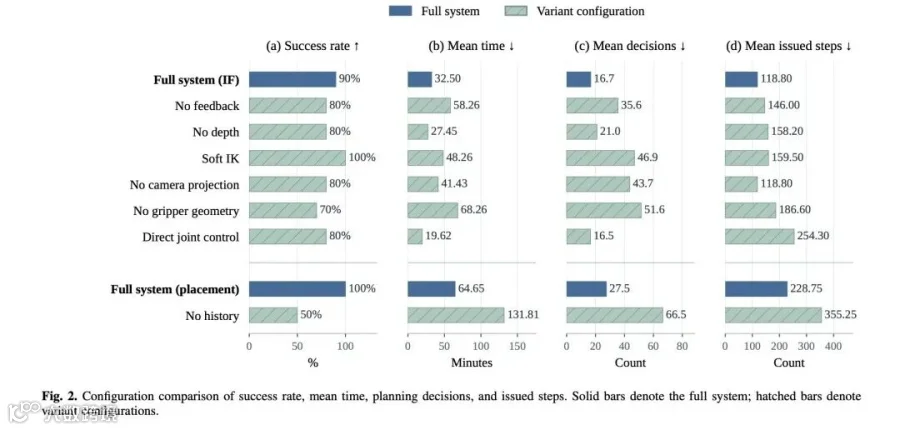
测试发现,大模型虽能识别物体,却缺乏三维物理常识。例如端锅任务中,模型无法自主采用正确抓握方式,需明确提示“抓住锅柄”才能成功。此外,移除历史记录会导致任务失败率激增:在积木入盒测试中,无历史记忆的Astra在放置阶段反复尝试相同错误动作,成功率从100%降至50%。
尽管GPT-6 Astra已实现跨本体全身协同控制(如移动取物、垃圾投放),但在灵巧手精细操作(叠碗、插网线、取书)上仍频繁失败。即使补充几何信息,也无法完成对准插入等高精度任务。这划定了当前大模型的能力边界:宏观协同可行,微观操控待突破。

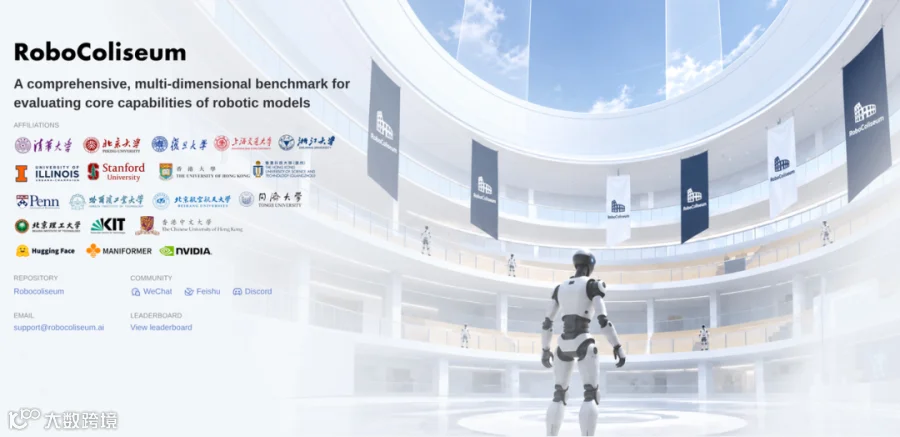
RoboColiseum:高保真仿真评测平台破解Sim2Real难题
RoboColiseum作为常态化具身智能仿真评测平台,有效解决了Sim2Real Gap问题。其高保真环境渲染与物理交互逼近真实世界,仿真与实机表现相关性达89.5%,差异小于10%,可作为真机部署前的可靠验证前哨。
多维能力拆解与快速归因分析
平台设有四大能力子榜及78个高保真任务,涵盖:
1. 指令跟随:语义理解与逻辑推理能力;
2. 空间理解:方位感知与精准对齐能力;
3. 扰动适应:光照、背景、镜头干扰下的鲁棒性;
4. 通用操作:多步骤组合动作执行能力。
评测结果不仅提供成功率,还可定位失败环节与动作卡点,实现精准归因。
高效接入与隐私保护机制
开发者最快5分钟完成注册提交,无需上传模型权重,仅需本地部署推理服务并接入标准接口。30分钟内即可获取分项成绩、步骤解析及推演视频。平台已集成主流顶尖模型基准数据,便于横向对比定位自身水平。
构建公平可信的具身智能评测标尺
RoboColiseum旨在打造公开、中立、可复现的具身智能评测体系,为行业提供绝对公平的竞争标尺。通过将OpenAI、Anthropic、谷歌等巨头模型纳入统一测试框架,使开发者能在同等条件下验证自身模型实力,推动具身智能技术从参数竞赛走向实效验证。

编辑:大卫 Aeneas

