大数跨境

DeepSeek 又一开源重器!深挖 DeepInfer 究竟藏着多少技术狠活?

DeepSeek 又一开源重器!深挖 DeepInfer 究竟藏着多少技术狠活? AI科技评论
2026-10-21
5
导读:单集群日处理约 155 万亿 Token,推理优化争夺毫秒。
单集群日处理约 155 万亿 Token,推理优化争夺毫秒。

    作者丨郑佳美

    编辑丨岑   峰


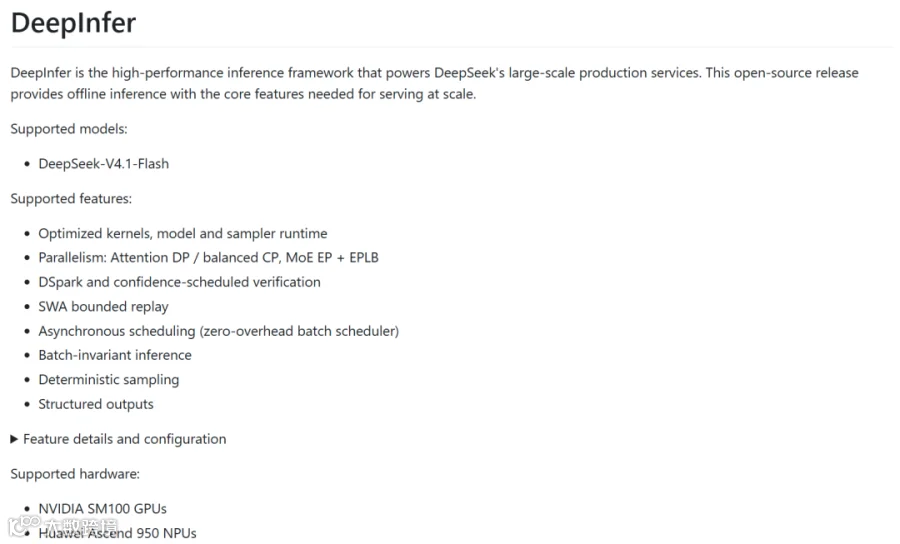
昨日,DeepSeek 在 GitHub 开源了大型推理引擎项目 DeepInfer。此次发布的并非新模型,而是支撑 DeepSeek-V4.1-Flash 的核心推理引擎,涵盖 MoE 专家并行、异步 Batch 调度、定制 Kernel 及推测解码等关键技术。
据 DeepSeek 披露,其单个集群日均处理 Token 量高达约 155 万亿。在如此庞大的流量下,GPU 计算资源的微小浪费累积效应显著。目前 DeepInfer 主要开放离线推理能力,线上 KV Cache 存储和跨副本负载均衡等组件暂未完全公开,但现有代码已充分展示了其在大规模推理中如何协调计算、通信与请求调度。
核心亮点之一是名为 Zero-Overhead Batch Scheduler 的异步调度机制。该机制旨在解决 GPU 计算完成后等待 CPU 处理上一轮结果、更新状态并安排下一轮工作的“空档期”问题。对于长文本生成任务,这种等待会反复发生,严重影响 GPU 利用率。DeepInfer 通过让 CPU 提前安排下一轮计算,将串行执行的调度与模型前向传播重叠,从而提升效率。
然而,提前排程带来了跨轮次状态管理的挑战:下一轮计算启动时,上一轮的 Token 可能尚未完成 CPU 后处理,导致序列长度、KV Cache 状态和请求生命周期出现时间差。DeepInfer 的技术难点与创新点正在于此。

重新安排 Decode 时序

传统推理引擎遵循固定顺序:CPU 选择请求并组织 Batch 及 KV Cache 元数据,GPU 执行 Forward 与 Sampling,随后 CPU 读取结果、更新状态并启动下一轮。随着 DeepGEMM、FlashMLA 等底层 Kernel 的不断优化,GPU 单轮计算时间大幅缩短,CPU 调度与结果处理的耗时占比日益凸显。尤其在 Decode 阶段,频繁的 CPU-GPU 切换导致大量时间浪费在等待上。
Zero-Overhead Batch Scheduler 重构了这一流程。当 GPU 处理第 N 轮 Forward 和 Sampling 时,CPU 已开始准备第 N+1 轮 Batch,并利用设备计算间隙处理更早一轮的采样结果。部分工作可提前提交至 GPU 执行队列,依赖关系由 CUDA Stream 和 Event 维护。
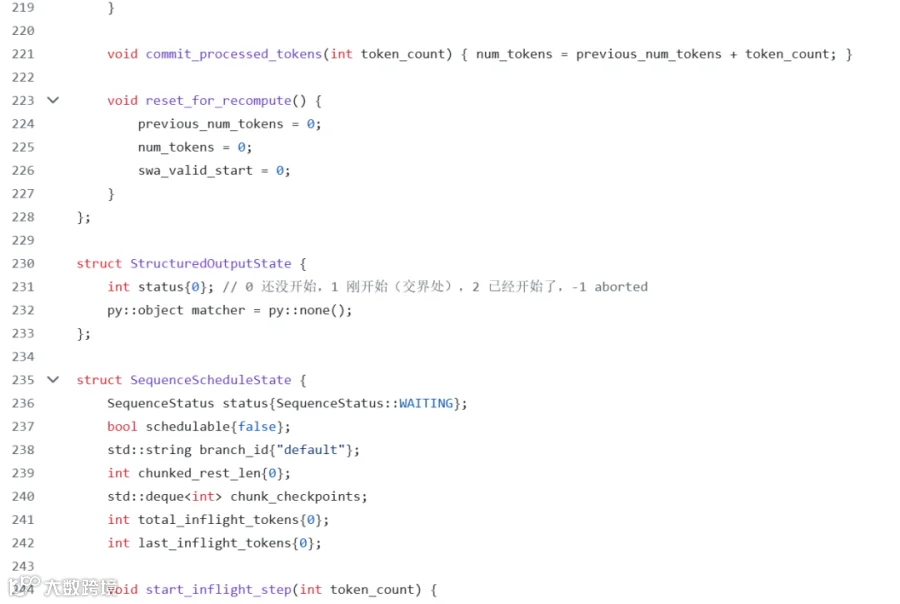
实现上,WorkerStepState 用于保存跨轮次执行状态,包括 SequenceMetadata、SchedulerOutputs、SamplerOutput 以及对应的 CUDA Event。这使得 CPU 无需等待上一轮结果完全处理完毕即可推进后续调度。
LLMEngine 通过 Worker 回调衔接操作,将原本集中在相邻 Decode Step 间的 CPU 工作分散到 GPU 计算期间。流水线稳定后,CPU 与 GPU 分别处理不同轮次,显著减少设备等待。针对流水线启动和收尾的特殊情况,DeepInfer 引入 Flush 机制处理在途结果,确保请求状态正常收尾。
该方法的收益取决于 CPU 工作与 GPU 计算的重叠程度。若 CPU 处理时间超过 GPU 计算窗口,仍会出现等待,因此 Zero-Overhead 更接近一种理想的执行调度目标。

DeepInfer 如何修正状态错位

CPU 提前安排下一轮时,上一轮采样结果可能尚未确定。特别是在开启推测解码后,一条请求可能连续接受多个候选,导致不同序列的实际推进长度存在差异。若直接使用旧长度组织计算,Query Length、Key Length 和 RoPE 位置可能出现偏移。
为此,DeepInfer 维护 total_inflight_tokens 记录已下发但未完成结果提交的 Token。调度器在分配资源时,会将这部分在途计算纳入序列长度与 KV Cache 容量检查,并提前预留缓存空间,避免 GPU 执行时容量不足。
此外,还需解决连续两轮 Batch 中请求位置不一致的问题。由于请求可能结束、加入或被抢占,同一条序列在不同 Batch 中的排列位置可能改变。DeepInfer 通过 Remap 映射,将当前轮请求对应到上一轮保存的执行状态,新加入请求则使用特殊标记。
GPU 利用映射找到上一轮实际采样结果,再通过设备侧 Kernel 修正 Query Length、Key Length 等参数,确保当前轮注意力计算访问正确的上下文范围。对于变长推测验证,系统会根据实际接受结果更新需处理的 Token 数量。
鉴于 CUDA Graph 通常按提前捕获的规格运行,系统需区分计算图预留容量与实际有效序列长度。设备侧状态修正减少了 CPU 与 GPU 间频繁传输少量长度数据的需求,使动态请求能适配固定规格的执行图。
内存生命周期管理也是一大难点。异步流水线中,某条请求虽已完成 CPU 后处理,GPU 上可能仍有未结束的操作引用其内存。DeepInfer 使用 DeferredRelease 延迟回收 SequenceMetadata、RequestOutput 及相关缓存块的固定引用,待释放资源先进入队列,在后续 pre_sampler_sync 阶段统一处理。涉及 GPU 状态复制的资源,则利用 CUDA Event 确认操作完成后再解除引用。
请求抢占也遵循相同的状态边界,防止已离开运行集合的序列因返回计算结果而错误更新状态,影响重新排程。

保证多卡执行步调一致

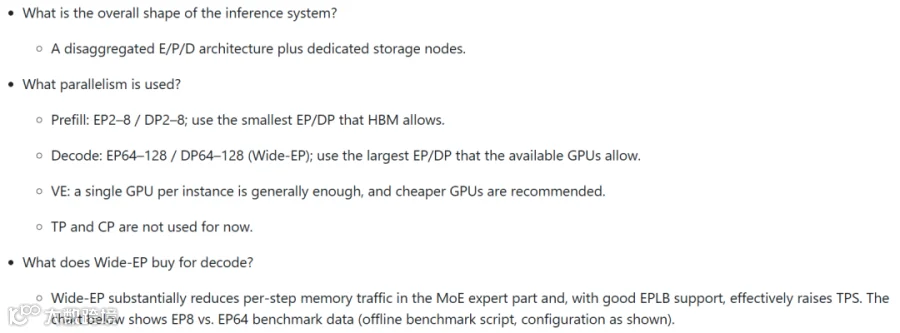
DeepSeek-V4.1-Flash 部署规模庞大,Prefill 通常采用 EP2 至 EP8,Decode 则使用 EP64 至 EP128 的宽专家并行。扩大专家并行规模虽能分散 MoE 权重读取压力,但要求参与同一通信域的 GPU保持执行步型一致。若部分 Rank 进入 Prefil 而其他 Rank 继续 Decode,将导致集合通信不匹配。
DeepInfer 在 Scheduler 中加入组内投票机制协调不同 Rank 的执行模式。ALL 模式要求相关 Rank 均满足 Prefill 条件,减少无任务设备陪跑;ANY 模式允许部分 Rank 的待处理请求触发组级 Prefill,避免小规模请求长时间排队。两种模式均受触发间隔控制,以减少频繁切换开销。
值得注意的是,等待队列存在请求不代表能成功排出 Prefill。某 Rank 可能因 KV Cache 容量不足或序列槽位受限而无任务可执行。为此,DeepInfer 在初步决定切换 Prefill 后执行第二轮确认:各 Rank 完成实际排程后检查组内是否存在有效 Prefill。若无,则返回 Decode;若部分 Rank 成功排出任务,其他 Rank 执行空 Prefill Step 以维持通信顺序一致。
启用 Zero-Overhead Scheduling 时,部分组内调度协调可通过 CPU 侧 Data Parallel 通信组执行,减少控制通信对 GPU 计算的干扰。
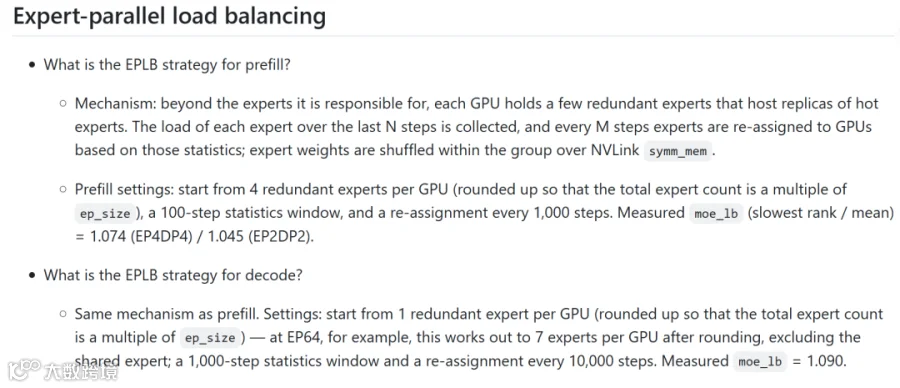
此外,MoE 专家负载不均也会影响整轮执行时间。Router 可能将较多 Token 分配给少数热点专家,导致对应 GPU 工作量过高。DeepInfer 通过 Expert-Parallel Load Balancing 分散负载,在 GPU 上保留部分冗余专家副本,并根据运行统计重新安排专家分布。官方 Decode 配置使用 1000 步统计窗口,每 10000 步调整一次专家分配,测得慢速 Rank 与平均负载之比约为 1.090。
组内步型协调负责处理跨设备执行一致性,专家负载均衡缓解部分设备拖慢整体计算的问题。两者配合异步调度,使 DeepInfer 能在大规模 MoE 部署中维持较连续的 Decode 执行。

推理优化开始深入执行时序

DeepInfer 的 Zero-Overhead Batch Scheduler 借鉴了 SGLang、NanoFlow 等已有实践,其工程特点集中在跨轮次状态修正、在途 Token 记账、KV Cache 生命周期管理及与宽专家并行的协同实现。
目前官方尚未单独公布该调度机制相对同步方案的完整端到端加速数据,DeepInfer 的整体性能还包含底层 Kernel、模型并行和其他优化的共同作用。当前公开版本主要面向 DeepSeek-V4.1-Flash,完整线上服务所需的部分基础设施仍未开放。
随着 Coding Agent 和长链路推理任务增加,Decode 轮次持续增长。DeepInfer 展示了一条明确的工程路线:通过跨轮次执行重叠减少调度空档,利用状态修正与资源生命周期管理维护正确性,让更多 GPU 时间用于实际模型计算。
参考链接:https://github.com/deepseek-ai/DeepInfer/blob/main/README.md


上车,带你看遍全球 AI 顶会精华

可独家畅览:

专家演讲PPT

大会报告全文

热门论文解读

学术新星访谈
//

推荐阅读

GLM-5.5 要来了?唐杰最新论文,曝出智谱神秘模型


Git 被换掉,LLM 被替代:AI 编码开始反噬传统工具链?

未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!

公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。

【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 9007
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读286.0k
粉丝0
内容9.0k