大数跨境

具身记忆赛道持续升温,长记忆迎来新 SOTA

具身记忆赛道持续升温,长记忆迎来新 SOTA AI科技评论
2026-10-21
13
导读:IROS 2026 最佳论文启示录:没有长记忆的机器人,终将被淘汰。
IROS 2026 最佳论文启示录:没有长记忆的机器人,终将被淘汰。

    作者丨邓哲敏

    编辑丨齐铖湧


本月初在匹兹堡闭幕的 IROS 2026 将最佳论文奖颁给了 LT-Mem。该研究让机器人在重访同一空间时,能完整保留物体位置变迁史,而非仅记录最新状态。评委会从近两千篇论文中选中它,标志着具身长记忆(long-term embodied memory)已从工程补丁演变为机器人领域的核心科学问题。
通用机器人的规模化落地需要以小时、天甚至周为单位持续运行。缺乏长记忆,机器人仅是孤立的单次动作执行器;拥有长记忆,才能转化为可长期协作的智能同事。然而,解决长记忆并非简单扩大上下文窗口,需应对多模态数据海量存储与检索难、现实世界动态变化导致的新旧信息冲突、以及错误记忆放大等挑战。
早在今年五月,国内具身初创公司贝塔无限(Beta Infinity)联合创始人陶帅便指出,长效、多模态、时空记忆的缺失是首要突破方向。随后团队发布了 BetaMem 全时空多模态记忆架构、世界动作模型 BetaWAM 0.1 及首款机器人多米。10月20日,团队将 BetaMem 的系统方法与实验成果发布至 arXiv。
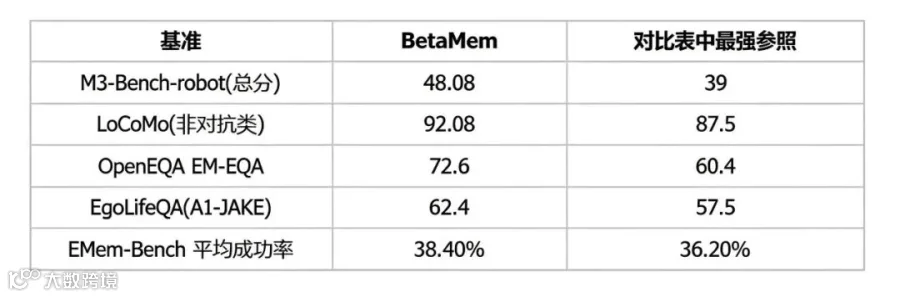
BetaMem 采用 9B 开源模型生成记忆,在 M3-Bench-robot、LoCoMo、OpenEQA 和 EgoLifeQA 四项代表性记忆基准评测中均取得 SOTA 成绩。尤其在串联多次观察线索、回忆长跨度事件及识别个人习惯等任务上优势明显。学术界通过 LT-Mem 攻坚单点问题,产业界通过 BetaMem 搭建完整记忆底座,两者交汇印证了长记忆是具身智能收敛的核心方向。


记忆这道题,学界做到哪一步

学界围绕机器人长期记忆主要有四类探索方向:
1. 空间侧记忆(“这里有什么”):如 Hydra、ConceptGraphs 构建三维场景图,Khronos 引入时间维度,DynaMem 更新动态环境。此类方法空间关系清晰,但主要记录当前世界状态。
2. 检测类记忆(“我见过什么”):如 ReMEmbR 建立可检索的时空记忆。但检索基于相似度,无法回答物体当前是否依然存在。
3. 变化侧记忆(“它变了没有”):如 IROS 2026 最佳论文 LT-Mem,解决“时间性失忆”问题,通过易变性分数决定新旧观测的处理方式。局限在于外观相似物体的身份关联仍困难。
4. 操作侧记忆(“我做到哪了”):如 MemoryVLA 和 MEM,补充时序上下文和工作记忆,提升长时程任务成功率。但设计不当的记忆可能放大虚假相关。
现有研究存在三大空白:空间与操作记忆割裂、记忆管理依赖人工设计、缺乏可追溯的证据链。贝塔无限的 BetaMem 方案针对这些空白提供了系统化解法。

把记忆做成一份有出处、有保质期的判断

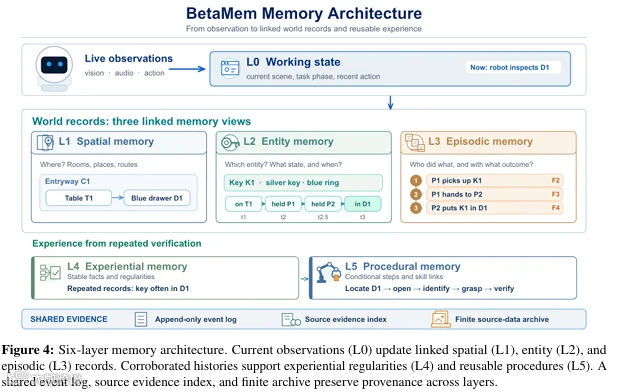
BetaMem 将记忆视为机器人对世界的判断,而非单纯日志。其核心架构包含三部分:
  • 时态状态图:记录当前对世界的认知状态。
  • 只追加事件日志:记录状态演变过程。
  • 源数据档案:有限容量留存原始图像与音频。
这种设计实现了证据与状态分离。如同法庭审判,证据(案卷)不可涂改,判决(状态)可随新证据修正。每条状态记录包含空间上下文、置信度、来源、版本号及状态标签(已观察、推断、冲突等),并区分事情有效时间、观察时间和写入时间。
记忆分为六层结构:L0 工作记忆、L1-L3 空间/实体/情景记忆、L4 经验记忆、L5 程序记忆。事件日志和源档案贯穿各层,确保记忆经过整合修订后仍可追溯出处。
在写入机制上,遵循“历史记录只是搜索线索,不是现状证明”的原则。机器人需通过最新观察确认当前状态,而非盲目信赖历史记忆。该系统借鉴了推荐系统中处理不确定性和偏好漂移的经验,具备成熟的不确定性治理思路。

让同一份状态进到手里

BetaMem 与世界动作模型 BetaWAM 同在 BetaBrain 内,实现模型、Agent 和动作三层读取同一份状态,避免规划、控制和预测各自缓存导致的数据偏差。
动作层需要两种记忆:
  • 短时动作与感知记忆:处理机械臂遮挡、多圈拧瓶盖等瞬时状态,消化小偏差,超过阈值才触发重试或上报。
  • 跨回合物理经验:将柜门开启技巧、物体触感等常识沉淀为可复用条目,打破回合边界。
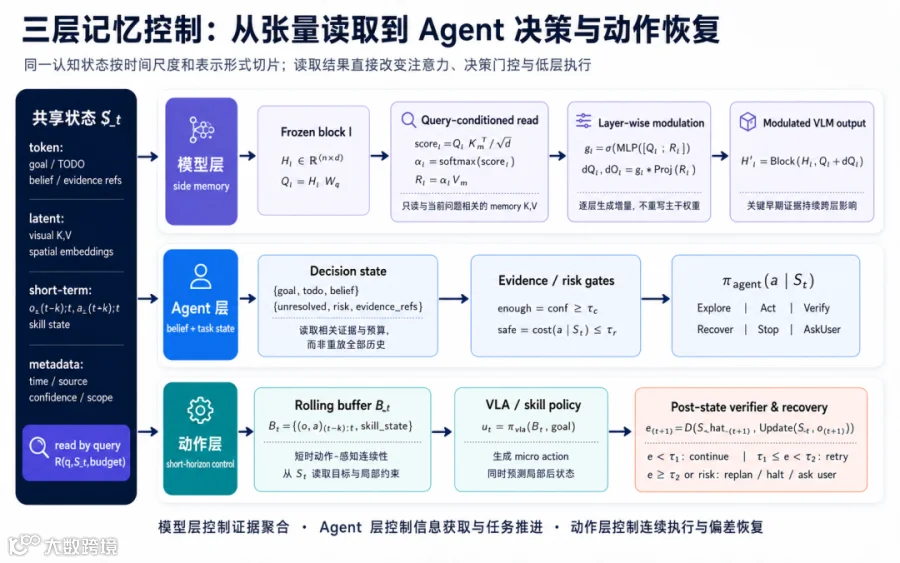
动作执行后,世界模型基于完整记忆预测结果,验证器对比真实反馈。误差处理不依赖固定阈值,而是从历史偏差中学习异常标准。

让记忆越用越好

贝塔无限将记忆策略和行为策略纳入同一反馈框架联合优化,奖励函数涵盖任务完成、证据覆盖、状态一致性、失败恢复等八个维度,使记忆成为持续进化的模块。
关键设计包括:
  • 小模型可靠记忆形成:通过监督微调与 GRPO 强化学习,惩罚编造和错误关联,提升记忆完整性与时序一致性。
  • 递归自我改进(RSI):基于失败反馈定位记忆管理问题,提出规则修复并经独立回放验证,实现安全迭代。
引入版本化、可回滚及灰度测试机制,规避自我进化失控风险。实验数据显示,使用 Qwen3.5-9B 模型生成的记忆在 M3-Bench-robot 多项指标上显著领先,消融实验证实了来源证据和写入学习的有效性。
该表由AI科技评论制作,数据来源于论文中表3-6

走进家庭,想象空间在哪里

BetaMem 的设计高度适配家庭场景的四大特征:
  • 多变化:物品位置动态改变,系统需记录变迁过程而非仅最终状态。
  • 多主体:区分不同家庭成员的习惯与行为,人物溯源能力是关键。
  • 长周期:需归纳长期习惯,且需多次印证才能固化规则,避免偶然事件干扰。
  • 信任:架构内置隐私保护,支持按来源检查权限、永久删除及端云协同,确保数据可控。

下一站,进入生活

长记忆问题同样存在于养老、零售等场景。正如论文副标题所言:Learning What Remains True as the World Changes。贝塔无限通过证据与状态分离、状态进入动作验证、记忆策略联合进化,同时解决了技术上的真伪分辨与用户层面的信任构建。
尽管在独立实证和真实家庭长期数据方面仍有待完善,但随着首款机器人多米的发布,这一方向的实际应用价值值得持续关注。

未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!

公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。

【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 9007
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读286.0k
粉丝0
内容9.0k