作者丨吴思梦
编辑丨岑 峰

![]()
一个在标准测试中拿到 96.9 分的物理智能体,只因桌上的盘子和小碟换了位置,成绩就跌到了 39.7 分。物体位置变化或指令微调导致任务失败,暴露出当前物理智能体虽能完成既定场景任务,却难以真正适应现实世界的复杂变化。
传统方案试图通过训练更强的动作模型(如 VLA/WAM)来解决,但往往过度关注“动作”本身,忽视了任务指令理解和图像理解的重要性。近日,小米 Darwin Agent 团队联合清华大学、南京大学、上海交通大学等机构提出 HarnessPAI,在不修改底层动作模型参数的前提下,通过外部可执行、可演化的代码系统,将任务理解、执行与验证有机组织,显著提升了模型的泛化能力。
在 LIBERO-PRO 基准的位置扰动和指令扰动测试中,单独使用 π₀.₅ 的成功率仅为 34.9%,引入 HarnessPAI 后提升至 96.5%。这一成果揭示了通过代码“ Harness ”激发模型潜力的新路径。
论文地址:https://arxiv.org/abs/2609.29166
项目主页:https://darwin-agent.github.io/HarnessPAI/
在标准 LIBERO 测试中,π₀.₅ 凭借 96.9% 的成功率证明了其优秀的操作能力。然而,当场景发生细微变化,如仅仅改变盘子的位置,或在指令中增加一个“not”,模型往往因无法重新理解图像空间关系或指令逻辑,而沿用训练时的错误动作路径,导致任务失败。
LIBERO-PRO 基准通过引入 Swap(物体位置交换)和 Task(指令改变)两类扰动专门测试此类问题。结果显示,π₀.₅ 在这两类扰动下的总体成功率降至 34.9%(Swap 为 39.7%,Task 为 30.1%)。这表明,完成任务需要将看清场景、理解指令、定位目标转化为动作等多个环节紧密衔接,任一环节的偏差都会导致最终失败。
面对这一问题,持续训练模型以覆盖更多场景并非唯一解,且成本高昂。HarnessPAI 选择从系统架构入手:不给动作模型增加负担,而是为其配备一套“ Harness ”程序,由程序负责任务流程组织、场景重新确认及步骤验证,动作模型仅负责具体操作执行。
HarnessPAI 的整体流程
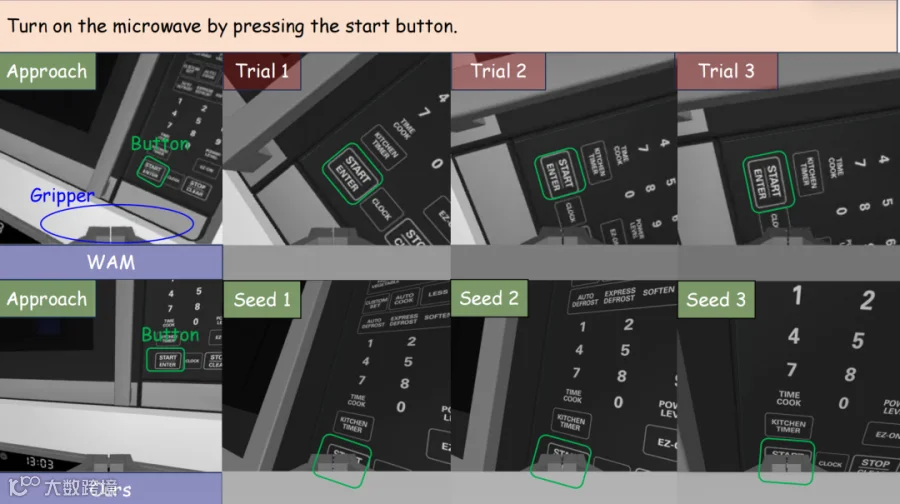
HarnessPAI 的核心是将代码作为连接感知、任务理解和动作执行的接口。程序调用感知工具识别物体,利用几何关系判断位置,再调动底层动作模型执行,并通过检查机制确认结果。代码承担任务层面的组织与校验,使感知、推理和行动解耦。
任务执行内:程序固定运行,无需每步调用大语言模型,只需检查目标定位、步骤完成情况及执行条件,确保过程稳定。
任务执行间:若执行失败,系统分析原因并修改程序,经测试验证有效的修正将被保留,成为可复用的技能。技能被挂载到任务流程的不同节点(如接近、抓取、搬运、放置),便于针对性检索和优化。
HarnessPAI 将每个技能挂载到其发生的图节点(接近、抓取、运输、放置)上,使得每种技能都可以根据其所属的任务阶段进行检索。
此外,系统设有严格的执行检查和候选程序验证机制,只有通过预设测试的修改才会被保留。这使得 HarnessPAI 不仅能生成程序,更能通过反馈循环让程序逐步可靠,实现了动作模型与代码程序的分工协作。
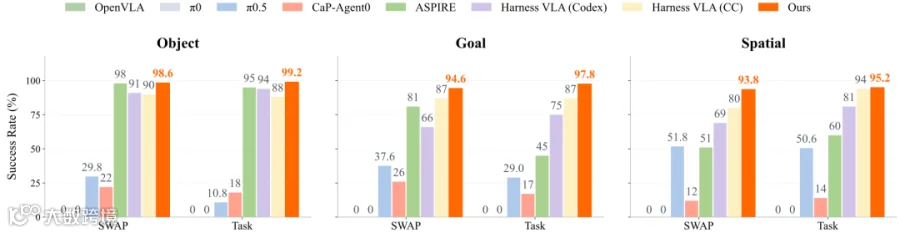
在 LIBERO-PRO 测试中,HarnessPAI 将冻结的 π₀.₅ 整体成功率从 34.9% 提升至 96.5%,其中 Swap 条件下达 95.7%,Task 条件下达 97.4%。这证明系统能通过调用感知模型(如 SAM、Molmo)补全动作模型在图像和指令理解上的不足。
LIBERO-PRO 上的测评结果
在 RoboCasa 原子任务中,HarnessPAI 将 WorldDreamer 成功率从 65.0% 提升至 92.2%;在 robosuite 七项操作中,平均成功率达 96.3%,其中高难度的 Insert 任务成功率为 83%,远超对照方法。在 BEHAVIOR-1K 移动底座人形智能体任务中,导航成功率达 100%,拾取成功率 84%,经演化后任务完成率达 100%。在 VacSim 吸尘测试中,清洁覆盖率也得到显著提升。
RoboCasa 的测评结果
robosuite 的测评结果
BEHAVIOR-1K 的测评结果
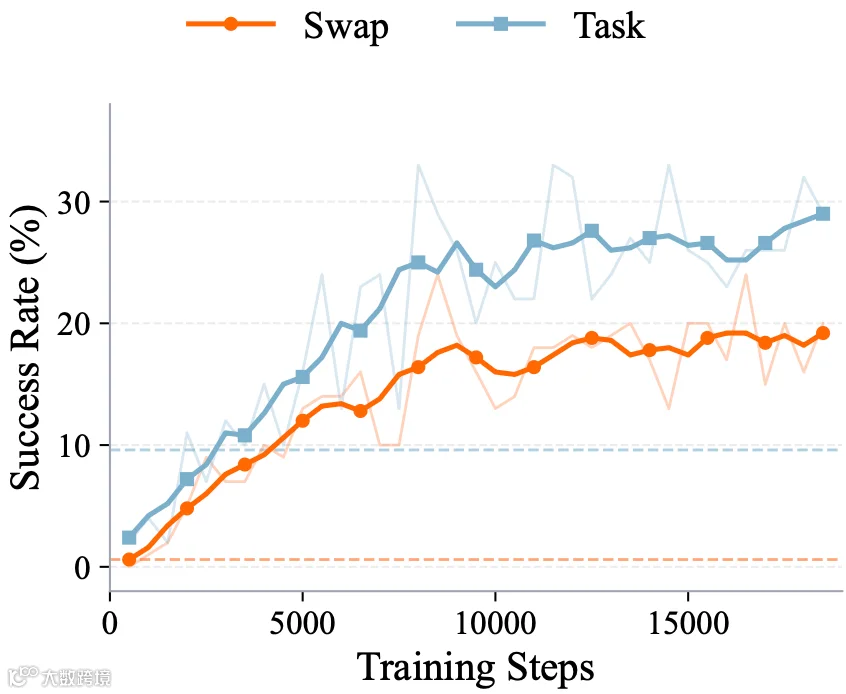
跨模型迁移实验显示,在 π₀.₅ 上演化的程序直接应用于 DreamZero,使其在 LIBERO-PRO 的 Swap 和 Task 成功率分别从 0.6% 和 9.6% 提升至 73.4% 和 84.4%。虽然略低于原生适配效果,但证明了任务组织逻辑的可迁移性。
在执行成本方面,由于无需持续调用高层大语言模型,HarnessPAI 显著降低了开销。在 LIBERO-Goal 测试中,串行执行速度提升约 18.4 至 23.1 倍,并行测试时提升约 117.8 至 147.4 倍。
HarnessPAI和HarnessVLA的时间和成本对比
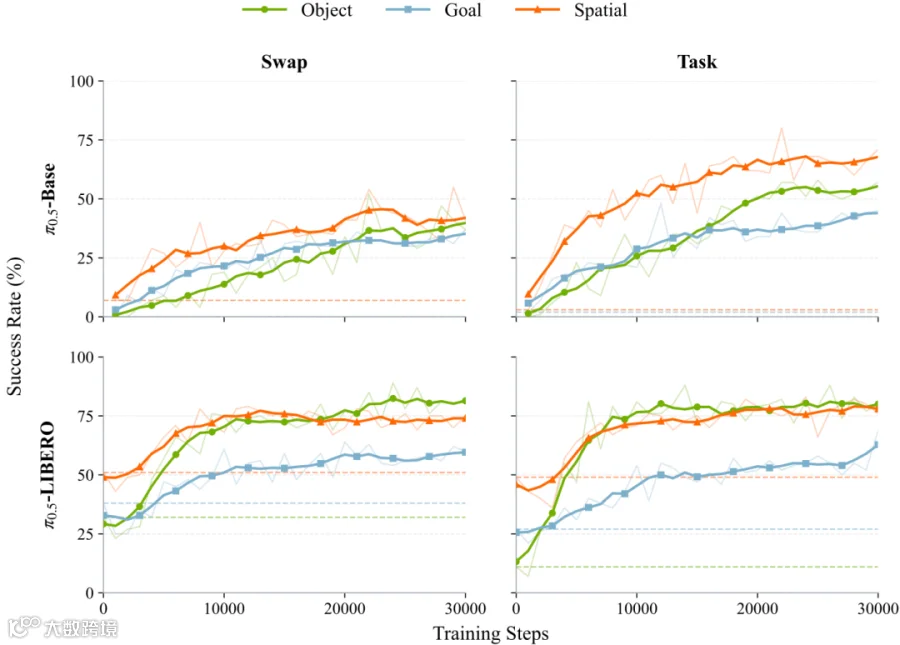
HarnessPAI 还可将成功执行的程序轨迹转化为训练数据。使用这些高质量轨迹微调 π₀.₅ 后,其在 LIBERO-PRO 上的成功率从 34.9% 提升至 73.7%;微调未受过 LIBERO 训练的 π₀.₅-Base,成功率也达到 53.3%。这为模型学习提供了新的数据源。
使用 HarnessPAI 的轨迹微调 pi05-Base 和 pi05-LIBERO
LIBERO-Object 上使用 HarnessPAI 的轨迹微调 DreamZero
HarnessPAI 表明,改进物理智能体不一定非要依赖底层模型的持续训练。通过可执行程序组织感知、推理与动作,能在特定任务下显著改善表现。当然,该方法无法创造底层模型缺失的基本能力,且程序演化需针对具体任务开发。
物理智能体的未来,不仅在于更强的动作模型,更在于构建能连接感知、理解、推理与执行的可执行系统。当动作模型与代码程序各司其职,提升智能体能力的路径将更加多元。