

论文标题:Reliable and Efficient Agentic Protein Design with Toolset Harnessing
作者团队:Jasper Butcher, Jie Chen, Andrew Hunt, Cyrus M. Haas, Wenzhao Dai, Shajesh Sharma, Raktim Mitra, Saman Salike, Jeremy Koob, Aiko Muraishi, Zhe Li, Harley Pyles, Michael D. Tyka, Magnus S. Bauer, Rafi I. Brent, Anant Mittal, Neil P. King, David Baker(华盛顿大学蛋白质设计研究所IPD等)
文章链接:https://doi.org/10.64898/2026.10.19.759896
近年来,随着深度学习的爆发,计算蛋白质设计领域迎来了前所未有的黄金时代。从早期的物理能量函数(如 Rosetta),到如今席卷学术界的 RFdiffusion3、ProteinMPNN、AlphaFold3 和 LigandMPNN,科学家们手中掌握了极其强大的生成与预测工具。然而,随着任务复杂度的不断攀升,一个新的痛点日益凸显:生态碎裂与工作流编排的噩梦。
一项前沿的蛋白质设计任务往往需要串联数十个独立开发的工具。这些工具缺乏统一的API,数据格式互不兼容,且严重依赖定制化的计算环境和脚本。对于研究人员而言,搭建并维护这些多步流水线是一项耗时耗力的“力气活”;而对于日益强大的大语言模型(LLMs)和AI Agent(智能体)来说,将宝贵的“推理算力”浪费在编写胶水代码、修复API报错以及轮询超算节点状态上,无疑是大材小用。
为了打破这一僵局,诺奖得主 David Baker 领衔的华盛顿大学蛋白质设计研究所(IPD)团队重磅推出了 Chaperone —— 一个轻量级、高度可定制的计算蛋白质设计框架。Chaperone 专为自动化与 AI Agent 时代打造,不仅为研究人员提供了一个优雅的 DataFrame 数据流转接口,更为前沿的 AI Agent 穿上了“外骨骼(Harness)”,使其能够真正像资深计算生物学家一样,自主构思、测试并大规模执行复杂的蛋白设计流水线。
核心解法:将所有设计工具“统一降维”
在传统的计算流程中,工具之间的数据传递往往是混乱的文件读写。Chaperone 提出了一个大道至简的解决方案:基于 DataFrame 的通用接口。
研究团队观察到,几乎所有的生物分子设计工具本质上只做两件事:要么基于现有结构生成新候选物(生成),要么对现有候选物进行指标评估(打分/预测)。因此,Chaperone 将每一个工具封装为一个 “Block(模块)”。无论是运行 RFdiffusion3 还是 AlphaFold3,Block 的输入永远是一个基于 Polars 构建的 DataFrame,输出则是一个拓展了新结构路径和新评分指标的 DataFrame。
通过这种方式,设计血统(Lineage)被完美保留,所有中间结果作为单一事实来源(Single Source of Truth)被存储在规整的列式数据库中。每个 Block 在执行时会自动完成“准备参数 -> 丢入黑盒执行 -> 编译结果合并”的三步走流程,完全屏蔽了底层软件的环境冲突问题。
更具革命性的是 Chaperone 为 AI Agent 打造的 Harness(脚手架)系统。它赋予了 Agent 编写和管理设计工作流的四层上下文:
-
1. 抽象脚本层:统一的 DataFrame API 模式。 -
2. 模块文档:标准化的 Schema 让 Agent 仅看代码就能预测工具输出。 -
3. 海量示例:涵盖分支、循环、模板化等复杂工作流的最佳实践。 -
4. 编排技能(Skills):赋能 Agent 自主监控超算集群作业、恢复崩溃任务、调试输入并进行可视化分析。
借助 Chaperone,Agent 可以采用“极速构建-测试”循环(Build-Test Loop):先在本地低算力模式下打通几十行代码的流水线测试,一旦验证无误,只需通过命令行参数即可将相同的脚本零修改扩展到数千个 GPU 节点上进行大规模生产。
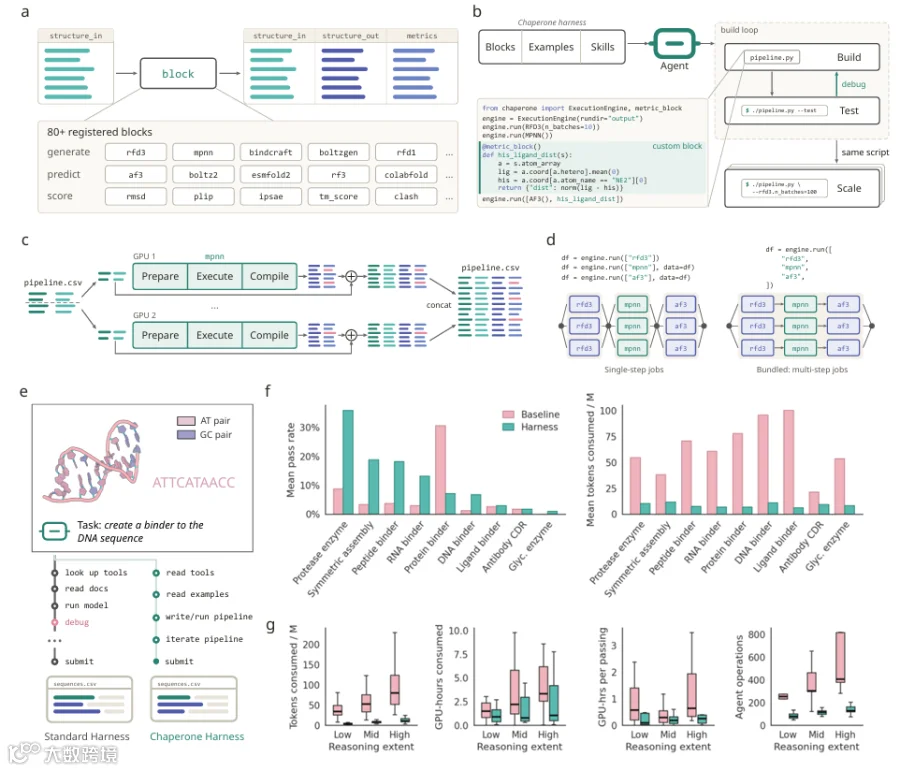
图1注:Chaperone框架概述及AI Agent自主评估表现
a: 模块化API设计,展示了所有Block统一使用DataFrame输入输出的标准化处理逻辑。
b: Chaperone Agent脚手架结构,为AI提供了涵盖模块、示例与技能的三层上下文,支持“构建-测试-扩展”循环。
c: 执行引擎的工作机制,展示了数据块如何被分发到不同GPU上完成“准备-执行-编译”流程并最终无缝拼接。
d: 灵活的流水线调度,支持传统单步执行,也支持将多个工具捆绑在单个计算节点内连续执行以减少排队开销。
e: 自动化评估平台设定,Agent需在无干预下完成96个序列提交并接受隐藏打分器的严苛检验。
f: 多任务性能基准对比,使用Chaperone的Agent在绝大多数任务(如蛋白酶、核酸结合等)中设计通过率大幅提升,同时Token消耗呈断崖式下降。
g: 算力与经济成本深度解析,证明在不同推理强度下,Chaperone极大地降低了GPU耗时与Agent的无效调试操作,打破了传统的算力瓶颈。
计算机模拟评估:打破 Agent 的“推理撞墙期”
为了验证 Chaperone 是否真的能提升 AI 的设计能力,研究团队构建了一个涵盖 9 大复杂任务的自动化基准测试(包括蛋白酶设计、对称组装、多肽结合蛋白、RNA/DNA结合蛋白、抗体CDR重设计等)。
他们给最先进的 GPT-5.6-sol Agent 分配了 12 个小时和 5 张 B4000 GPU 的权限,让其完全自主地开发策略、编写代码并提交最终的 96 个候选设计。结果极其惊人:
-
• 资源消耗骤降:使用 Chaperone 框架的 Agent 相比于在传统开源环境中自行摸索的基准 Agent,总 Token 消耗减少了 86%,GPU 计算时间降低了 64%。 -
• 成功率翻倍:在资源大幅节省的前提下,设计的整体计算通过率从 6% 跃升至 12%。
研究发现了一个有趣的现象:如果不提供 Chaperone,当强制提高 Agent 的“推理强度”时,基准 Agent 会疯狂消耗超 2500 万的 Token,但绝大多数算力都被浪费在了“修复依赖报错”、“检查作业是否跑完”等基础设施维护上。而佩戴了 Chaperone 护具的 Agent,即使在最高推理强度下,总 Token 消耗也极低。因为它可以跳过泥潭,直接进行纯粹的“科学假设构建与结构推理”。
实验级验证一:极速攻克低纳摩尔级“皮质醇”结合蛋白
为了证明 Chaperone 在真实湿实验中的杀伤力,研究人员挑战了极具难度的小分子结合蛋白设计(Small Molecule Binder Design)。皮质醇(Cortisol)因其独特的配体几何形状,一直缺乏通用的计算策略。过去的顶尖工作往往需要经过多轮计算设计外加繁琐的实验亲和力成熟(Affinity Maturation),才能达到 68 nM 的亲和力。
在 Chaperone 的协助下,Agent 和人类研究员展开了高效协同:
-
1. 策略扫描:利用 RFdiffusion3 探索了 20 种蛋白重心位置与 4 种长度组合,完成了 80 批次基础骨架生成。 -
2. 序列定制:挑选出 10 种具有潜力的骨架,利用 LigandMPNN 施加定制化的氨基酸偏好,强化配体周围的疏水堆积。 -
3. 多模型循环过滤:将候选物投入 AlphaFold3、ESMFold2 与 RoseTTAFold3 的预测矩阵中,进行 6 种维度的严苛筛选。
得益于极低的代码重构成本,Agent 轻松监控了 104 次小型探索运行。短短两周时间内,团队就锁定并生成了终极批次。在首轮实验测试的 27 个候选物中,15 个展现出了明确的结合信号。最优秀的结合蛋白达到了惊人的 1.32 nM 亲和力(KD)! 这完全是“零样本(Zero-Shot)”直接计算生成的成果,无需任何后续实验突变进化。
实验级验证二:从零构建复杂纳米颗粒自组装体
从头设计自组装蛋白纳米颗粒是一项极其繁杂的工作,往往需要调用诸多非主流的专门软件。团队将“构建一个由 C3 对称螺旋卷曲基序组成的十二亚基四面体(Td)纳米颗粒”的任务交给了 Agent。
通过 Chaperone,Agent 顺畅地将生成骨架的 RFdiffusion、负责刚体对接调参的 RPXdock(一款较难集成的专门软件)、负责序列设计的 ProteinMPNN 以及用于结构验证的 AlphaFold2 与 Rosetta 串联为一条完美的流水线。
Agent 自动生成了一个小型四面体纳米颗粒候选库,经过自动化过滤,团队选取了 15 个设计进行大肠杆菌表达与纯化。最终,有 1 个设计在负染电子显微镜(Negative Stain EM)下被证实完美组装成了预期大小的蛋白纳米颗粒,单次成功率达到 6.7%。这一结果强有力地证明了 Chaperone 在非标准、冷门软件集成上的普适性。
实验级验证三:为蛋白晶体打造“刚性铰链”
在蛋白质结晶学设计中,最核心的一步是如何用一条“刚性连接肽(Linker)”将两个具备不同对称性的基序(例如 C2 和 D3 对称复合物)死死锁在特定的几何相对位置上。连接肽的理想长度在设计前是未知的,这需要极高的穷举试错成本。
Agent 再次利用 Chaperone 展现了强大的工作流编排能力。它首先编写了一套针对 RFD3 的自定义过滤器,专门剔除那些会与对称链发生空间位阻的劣质骨架。随后,Agent 发起了一次包含约 100 个设计的“先导实验(Pilot)”,用于测试 10-35 个残基的不同 Linker 长度,并横向评估了普通 ProteinMPNN、可溶性 SolubleMPNN 和增强型 EnhancedMPNN 的设计表现。
在锁定最优参数后,执行引擎自动将任务规模放大了将近 10 倍,将设计扩散到约 4500 种刚体放置形态中。整个过程融合了 CaGE 循环退火策略与高精度的 AlphaFold3 六聚体打分。最终的湿实验结果令人振奋:团队成功获得了一种由 17 个残基组成的 Beta-发夹(β-hairpin)结构 Linker。该融合蛋白在洗脱缓冲液中成功自组装,并在明场显微镜下观察到了清晰规则的蛋白质晶体形态!
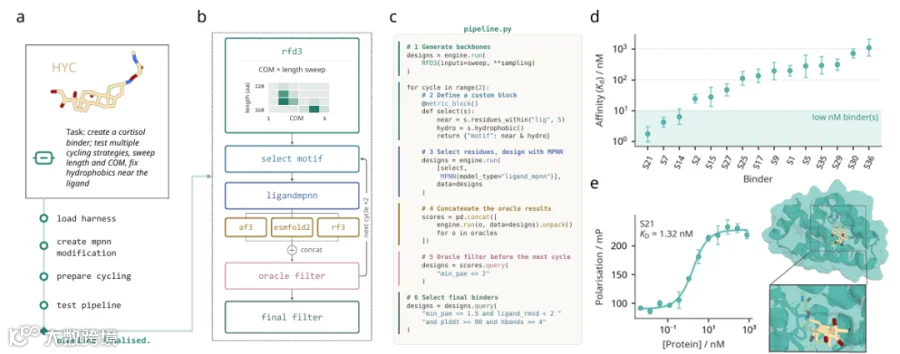
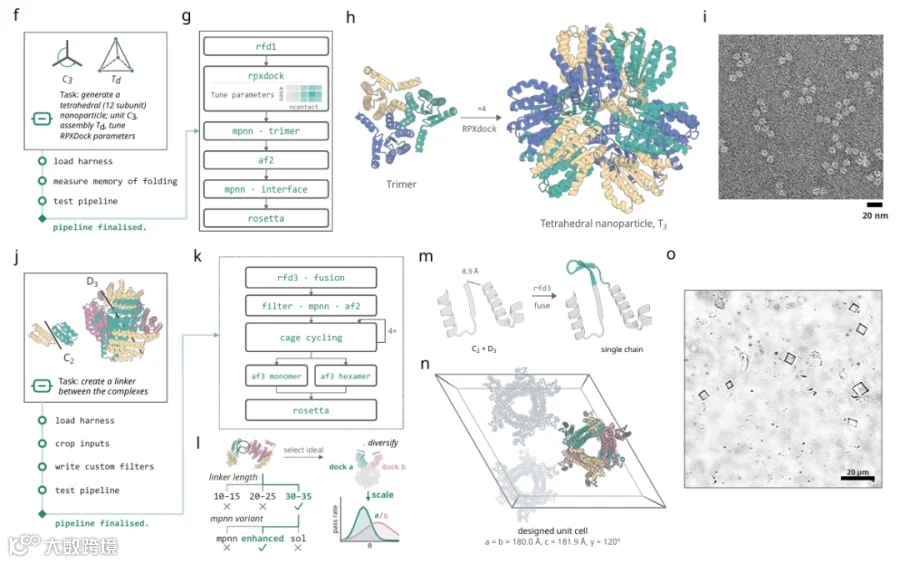
图2注:Chaperone驱动的多步设计真实湿实验验证
a: 皮质醇(Cortisol)小分子结合蛋白设计的目标设定与约束条件。
b: 精密编排的多步流水线,包含RFD3骨架扫描、定制化疏水基序选择及三大预测模型的联合过滤。
c: Agent自主编写的极简Python流水线源码,展示了如何用几行代码调用极其复杂的计算逻辑。
d: 湿实验测定的15种高质量候选蛋白的亲和力(KD)分布,大批设计成功进入纳摩尔级别。
e: 冠军结合蛋白(KD=1.32 nM)的荧光偏振滴定曲线及其与皮质醇结合位点的精细氢键网络三维模型。
f: 十二亚基四面体纳米颗粒的设计任务要求(从C3到Td对称性跳跃)。
g: 完美集成非常规对接工具RPXdock的纳米颗粒生成流水线。
h: 设计成功并被选中进入实验验证的十二链四面体纳米颗粒三维原子模型。
i: 负染电子显微镜图像,直接观测到了与设计尺寸完美吻合的纳米颗粒组装体(比例尺20 nm)。
j: 蛋白质刚性融合与连接肽(Linker)设计任务,旨在桥接D3与C2对称复合物。
k: 专为晶体连接打造的深层流水线,创新性引入了CaGE结构循环更新与AF3的单体/六聚体双重验证。
l: 智能化的先导扫参图表,Agent通过小规模测试精准锁定了最佳连接肽长度(区间)与最适用的MPNN变体模型。
m: H11设计方案的局部放大模型,清晰展示了由RFD3从零生成的17残基β-发夹连接肽结构。
n: 验证成功的H11晶体单元(Unit Cell)空间排布解析。
o: 通过明场显微镜直接拍摄到的宏观蛋白质晶体生长形态(比例尺20 μm)。
总结与展望
在过去,计算生物学家的日常往往是与 Bash 脚本、环境依赖和散落各地的 PDB 文件作斗争。如今,Chaperone 将这一混乱的生态彻底标准化。通过提供面向未来的 DataFrame 接口和极度契合大语言模型的 Agent Harness,它极大降低了复杂计算生物学任务的准入门槛。
David Baker 团队的这项研究雄辩地证明:提升 AI 在科学研究中表现的关键,不仅在于提升大模型本身的“智力”,更在于为其提供趁手的“兵器”。 当基础设施不再成为阻碍时,AI 能够以惊人的效率构思实验、分配算力并取得令人瞩目的湿实验突破(如 Zero-shot 的 1.32 nM 皮质醇结合蛋白)。
目前,Chaperone 框架已在 GitHub 上面向整个开源社区免费开放(https://github.com/RosettaCommons/chaperone)。随着 AI 预测与生成大模型的日新月异,像 Chaperone 这样能够灵活编排“超长程、多工具”任务的智能中枢,必将成为下一代自动化生物实验室(Self-Driving Labs)不可或缺的核心基石。