


摘要
#2026#
////
如今海量的查询迫使硬件制造商转型。
马修·S·史密斯
2026年9月15日
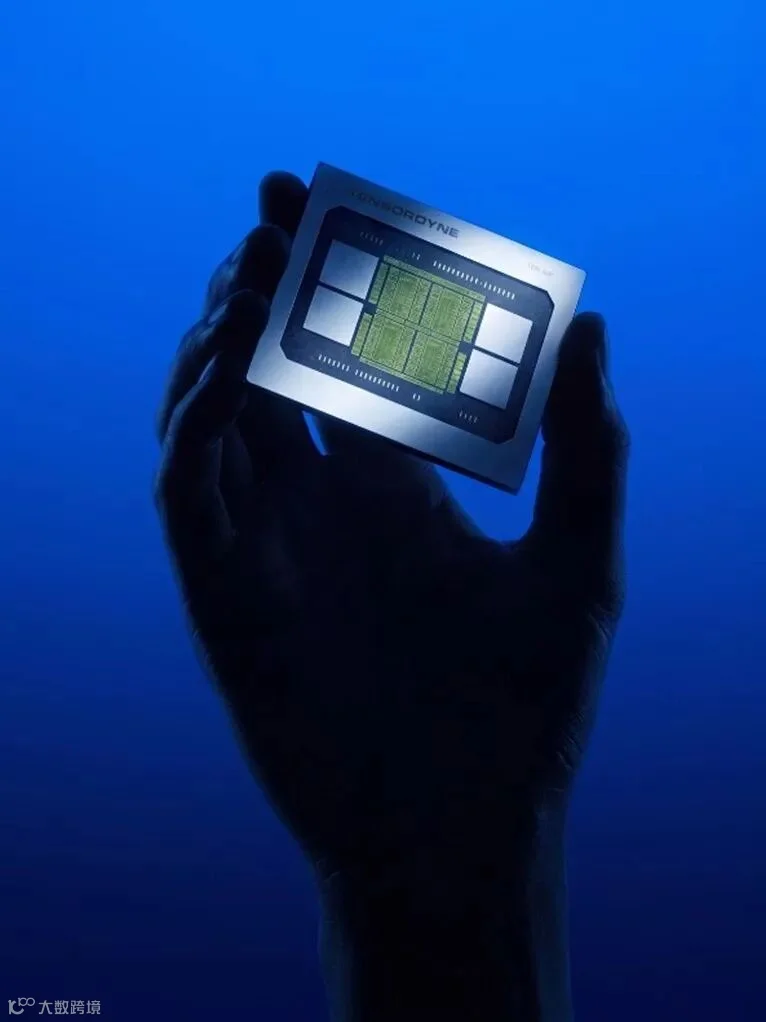
Tensordyne的Napier 芯片为加速 AI 推理而设计
自2020年左右以来,人工智能的发展主要集中在训练更大、更优秀的模型上。大型语言模型(LLM)的参数数量从数百万激增至数万亿。事实证明,这种做法卓有成效:OpenAI于2020年发布的GPT-3最大版本,在一项流行的知识推理基准测试中,正确率仅为43.9%。仅仅四年后,GPT-40在同一测试中就达到了88.7%的正确率,与人类专家的水平基本持平。
先进的人工智能实验室仍在训练规模越来越大的模型,但这种训练在人工智能的讨论中已逐渐退居次要地位。到2026年,推理—即利用训练好的模型生成代码、撰写文章,或者为我们自己生成精灵的图像—将成为关注的焦点。
“训练数据仿佛已经过时了,”Moor Insights & Strategy 的首席数据中心分析师 Matt Kimball 表示,“现在所有首席信息官都只想谈论推理。”英伟达首席执行官黄仁勋在公司 GTC 2026 大会上称这一变化是“推理的转折点”。
造成这种转变的部分原因很简单:大语言模型(LLM)变得越来越有用,因此人们开始使用它们。此外,目前市场上的许多模型都是推理模型。为了响应用户的查询,它们不仅会运行一次推理,而是会运行多次推理,通过一种称为“思维链”的过程不断自我提示。推理模型会生成更长的输出,而推理工作量大的模型生成的文本量可能是推理工作量小或没有推理工作量的模型的20倍。进一步加剧全球推理工作量的是,智能体人工智能的兴起使得推理不仅能够实时响应用户的查询,还能全天候自主运行,朝着用户设定的目标前进。

亚马逊的Trainium芯片最初是为人工智能训练而设计的。然而,亚马逊网络服务 (AWS) 选择将人工智能推理拆分为两部分, Trainium负责计算更复杂的部分,而 Cerebras 的晶圆级引擎则负责内存密集型部分
由此引发的推理需求爆炸式增长,导致科技巨头之间出现了意想不到的联盟。OpenAI 和亚马逊部署了由 Cerebras 设计的、餐盘大小的芯片,尽管亚马逊拥有自己的Trainium芯片。英伟达斥资 200 亿美元,从人工智能推理初创公司Groq收购了关键人才和知识产权,这笔交易引发了争议。而 Anthropic 公司每月向其 LLM 竞争对手SpaceXAI支付超过 10 亿美元,租用其闲置的计算资源。
尽管人工智能训练和人工智能推理看似相似,但它们的计算方式截然不同。科技巨头的这些重大举措表明,为了满足推理需求,我们需要与几年前专家们预期的截然不同的硬件组合。

一、人工智能推理与人工智能训练有何不同?
未经训练的LLM就像桌上一堆乱七八糟的拼字游戏字母牌。不过,这些字母牌上不是单个字母,而是单词的片段,称为词元。虽然几乎任何文字所需的元素都在这里,但却毫无意义。
训练模型的过程就是利用大规模的猜词游戏来整理这些杂乱无章的信息。模型会收到一段隐藏了下一个词元的真实文本,并被要求预测接下来的内容。每次猜测后,正确的词元会被揭示出来,然后与预测结果进行比较,两者的差异被用来计算模型的准确率。这个游戏并非针对单个句子,而是针对数十亿段文本进行。
虽然玩拼字游戏可以一边吃薯片、喝饮料一边进行,但人工智能训练却需要大量的计算资源。模型通过反向传播来更新参数,这个过程会反复计算模型数十亿甚至数万亿个参数中每个参数应该如何调整才能使下一次预测更加准确。正因如此,科技巨头们正在建设规模空前的数据中心。
最终,模型创建者认为继续训练成本过高,于是停止了反向传播。反向传播结束,参数被冻结,LLM 成为预训练模型。微调—即在规模较小、更专业的数据集上进行一次短期训练—进行最终调整,模型即可部署。

英伟达的Groq 3语言处理单元通过将片上SRAM内存和计算模块按芯片所需顺序排列,最大限度地减少了数据传输
接下来是推理。这是使用已部署模型的过程,该模型经过训练后,已经学会按合理的顺序输出拼字游戏字母块(词元)。
你可能会认为人工智能推理的计算量较小,因为它省去了用于更新参数的反向传播计算。但推理硬件公司d-Matrix的创始人兼首席技术官Sudeep Bhoja解释说,推理带来了新的挑战。
这些模型本质上是“自回归”的。也就是说,下一个输出取决于前一个输出。“所以,要生成下一个词元,你必须读取前一个词元的所有权重和所有上下文信息,”Bhoja解释道。上下文信息包括你所有的提示、 LLM的所有回复以及你上传的所有文件。这涉及大量数据和处理工作。
大语言模型(LLM)的响应分两个阶段生成:预填充和解码。预填充阶段是模型读取提示信息的过程。它会同时处理每个词元,计算每个词元与其他词元之间的关联。这种操作被称为注意力机制,它是现代LLM所基于的Transformer架构的一个显著特征。它使模型能够响应单词在其句子、段落乃至更大上下文中的位置,而不仅仅是单个单词。可以把它想象成在玩拼字游戏之前先排列字母。许多玩家会移动字母来想象它们之间的连接方式。自注意力机制的作用与之类似,只不过它不是移动实际的字母,而是每个词元向其他词元发送查询,并接收一个分数来表示该词元的相关性。
这些查询会生成两种类型的向量:键和值。它们通常存储在称为 KV 缓存的存储中。这并非绝对必要,因为模型也可以在生成每个新词元时重新计算这些向量。但几乎所有大语言模型 (LLM) 都使用 KV 缓存来减少计算量。KV 缓存存储在内存中,充当 LLM 理解对话的临时存储介质。虽然它最初很小,但最终可以扩展到数十 GB。
预填充问题很容易分解并并行处理。正因如此,随着大语言模型(LLM)的普及,GPU 成为了主流的 AI 加速器。图形光栅化(计算屏幕上每个像素的颜色)也具有高度并行性,因此 GPU 架构自然而然地成为了理想之选。

Cerebras 的晶圆级引擎芯片将所有组件(包括内存单元和计算单元)并排集成在餐盘大小的芯片上,从而最大限度地提高了内存带宽
接下来是解码阶段。在这个阶段,模型会逐个生成响应。每一步,它都会获取最新的一个词元,将其与键值缓存中的所有词元进行比对,利用这些信息预测下一个词元,并将新词元的键值添加到缓存中。然后,它会按顺序逐个词元地重复这个过程。
这就是模型自回归特性阻碍推理速度的原因所在。预测每个词元都需要从内存中读取整个模型,而该模型可能包含数十到数百GB的参数(代表模型在训练过程中学习到的知识)。关键在于,这还不包括存储键值缓存所需的内存。
因此,所有这些数据在内存中的传输通常需要比推理硬件可用带宽更大的带宽。所以,GPU 的部分计算组件会在等待数据时处于空闲状态。研究人员发现,运行开源 LLM 的 Nvidia H100 GPU 有 50% 到 80% 的时间处于空闲状态。
二、内存在推理中的作用
Meta公司前硅工程主管、人工智能初创公司Majestic Labs联合创始人Shahriar “Sha” Rabii表示,闲置的处理器正是许多致力于提升人工智能推理性能的公司将重心放在内存上的原因。“基于GPU的方法最终会导致计算资源过度配置,而内存资源严重不足。这正是大规模内存扩展的驱动力。”他说道。
Bhoja 的 d-Matrix 和 Rabii 的 Majestic Labs 都专注于解决这一内存瓶颈问题。然而,两家公司提出的解决方案却截然不同。
d-Matrix 的第二代 AI 加速器 Raptor 旨在通过最大限度地缩短计算和内存之间的距离来提升推理性能。目前大多数 AI 推理部署中的 GPU 都是通过在 GPU 周围放置高带宽内存 (HBM) 来实现这一点的。每个 HBM 都是由堆叠在一起的 DRAM 芯片组成,并通过超高速接口连接到 GPU。这对于训练来说非常有效,但对于推理而言,这种方式所能堆叠的内存容量和带宽却远不能满足需求。
d-Matrix 的堆叠芯片架构:

内存带宽—即数据从内存读取到逻辑电路的速度—是人工智能推理的一大瓶颈。初创公司d-Matrix通过将逻辑芯片直接堆叠在内存(在本例中为DRAM)之上,提高了这一带宽。这使得大量极短互连成为可能。—克里斯·菲尔波特
d-Matrix 的 Raptor 通过将 AI 加速器堆叠在 DRAM 芯片上,消除了这一瓶颈。d-Matrix 并非堆叠内存,而是将内存和计算能力同时堆叠。Bhoja 表示,这使得数据传输距离从“毫米级”缩短到“微米级”。就像建造摩天大楼一样,垂直堆叠使得在相同的物理空间内实现更多功能成为可能。
Majestic采取了截然相反的策略。该公司并没有试图缩短计算和内存之间的数据传输距离,而是专注于改进内存接口,以适应更长的线路,同时保持高带宽。更长的线路使得Majestic能够连接并非直接紧邻GPU的内存堆栈,从而突破了HBM的空间限制。
“内存接口的物理工作距离非常短。以HBM为例,只有2到3毫米。HBM只能放置在芯片外围的海岸线上,”Rabii说道。
Majestic 声称其内存接口的传输距离可达约一米。这得益于其专有的铜缆链路和用于协调数据的内存聚合芯片。“聚合芯片是高速接口的终端,也是将数据扇出到众多通用 DRAM 芯片的途径,”Rabii 解释道。正因如此,Majestic 能够在单个服务器机架中支持高达 128 TB 的 DRAM 内存—相比 Nvidia 的 GB300 NVL72 机架(约 20 TB HBM3E),这是一个显著的提升。
Majestic Labs 的内存聚合架构:

Majestic Labs计划通过其专有的互连技术和内存聚合芯片来满足人工智能的内存需求,从而允许单个机架访问高达128TB的廉价DRAM内存。—克里斯·菲尔波特
d-Matrix 和 Majestic 有一个共同点:它们都没有采用 HBM,而是使用了现成的 DRAM。DRAM 是目前世界上最常见的计算机内存类型,从智能手机到汽车,几乎无处不在。内存分析师 Jim Handy 表示,HBM 的成本是 DRAM 的两到三倍。d-Matrix 和 Majestic 选择 DRAM 的部分原因正是出于这种价格优势。然而,包括三星和 SK 海力士在内的 HBM 支持者们并没有坐视不理。
最新版本的HBM内存HBM4现已投入生产,并将用于英伟达的Vera Rubin GPU,该GPU预计将于2026年下半年出货。SK海力士内存系统研究主管金浩植表示,HBM4通过将HBM的最大内存带宽提高一倍并增加每个堆栈的HBM内存量,“将彻底打破目前制约AI推理的内存瓶颈”。
三、芯片组合可加快推理速度
两大巨头—英伟达和亚马逊—正采取“全芯片同时运行”的策略。英伟达的GPU和亚马逊的Trainium训练加速器在推理工作负载的预填充阶段(即计算所有上下文键值对的阶段)仍然表现出色。但为了加速解码阶段(即生成新词元的阶段),他们正寻求来自规模较小的厂商的、以内存为中心的新型架构。
以英伟达为例,规模较小的竞争对手是Groq (不要与SpaceXAI训练的大语言模型 Grok 混淆)。英伟达在 2025 年底收购了Groq的知识产权并招募了人才,仅仅三个月后,在英伟达 GTC 2026 大会上,黄仁勋发布了英伟达Groq 3 语言处理器 (LPU)。Groq的架构依赖于直接集成到芯片架构中的内存—在本例中是 SRAM。
除非你是芯片架构师或资深PC游戏玩家,否则你可能从未考虑过SRAM。SRAM的优势在于它与计算芯片的架构紧密集成—它与处理器位于同一块硅片上—缺点是密度低于DRAM且价格更高。大多数芯片仅包含几十兆字节的SRAM。然而,人工智能推理的出现重新激发了人们对SRAM的兴趣,因为它可以将存储在内存中的模型权重更接近计算资源。
英伟达超大规模和高性能计算副总裁兼总经理伊恩·巴克表示,LPU 的优先级与公司的 GPU 截然不同。LPU 的原始计算能力远不及标准 GPU,但它拥有 500 MB 的片上 SRAM,直接连接到其浮点运算单元。“优势在于内存带宽。LPU 的内存带宽是 GPU 的七倍,”他说道。
从理论上讲,Rubin GPU 和Groq LPU 可以同时加速预填充和解码,从而兼顾两者的优势。“我们所有的注意力机制计算和上下文处理都在 Vera Rubin GPU 机架上完成,” 巴克 解释道,“而所有需要进行专家计算的运算……比如矩阵乘法,则在 LPU 上完成。”该公司将 256 个 LPU 集成到Groq 3 LPX 系统中,该系统体积相当于一个数据中心机架。
英伟达的双芯片推理方案:

英伟达还计划将推理工作负载分配到两块芯片上。该公司最新的 Rubin GPU 将负责计算密集型的预填充阶段,而配备大量片上 SRAM 的Groq 3 语言处理单元 (LPU) 将负责内存密集型的解码阶段。—克里斯·菲尔波特
亚马逊网络服务(AWS)与Cerebras达成协议,将Trainium加速器与Cerebras的晶圆级引擎3(WSE-3)结合使用。Cerebras采用了与Groq类似的方法,但规模要大得多。WSE-3将整个硅晶圆加工成一个包含超过4万亿个晶体管的单芯片。该设计不连接外部存储器,而是在每个晶圆上蚀刻44GB的SRAM。“我们将模型权重存储在SRAM中,”曾任Cerebras产品营销总监、现已加入SpaceXAI的James Wang表示,“因此,我们可以在一个芯片上轻松支持400亿到800亿个参数。”
亚马逊计划使用 AWS Trainium芯片进行预填充,使用 Cerebras 芯片进行解码。但 Cerebras 的芯片也可以独立完成推理。OpenAI 部署了 WSE-3 芯片来驱动 GPT-5.3-Codex-Spark,这是该公司编码模式的一个变体,每秒输出超过 1000 个词元。相比之下,OpenAI 的标准 GPT-5.4 部署每秒输出 50 到 125 个词元。
亚马逊网络服务的双芯片推理策略:
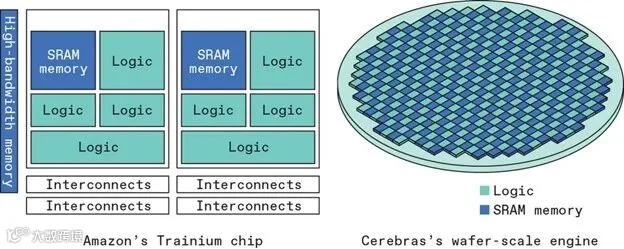
亚马逊网络服务(AWS)将其Trainium芯片与Cerebras公司餐盘大小的晶圆级引擎(WSE)相结合,以解决人工智能推理的不同环节。Trainium芯片负责计算密集型的预填充阶段,而WSE则利用交错式片上SRAM存储器,处理受内存带宽限制的解码阶段。—克里斯·菲尔波特
Cerebras 还能在不将工作负载转移到不同专用芯片的情况下处理预填充任务。为此,它将多个 WSE-3 芯片联网,形成一个单一的内存池。Cerebras 已证明其能够处理高达 1T 个参数的模型,例如 Moonshot AI 的 Kimi 2.6,不过 Wang表示“就参数数量而言,该架构本身没有限制”。
尽管在战略上存在分歧,英伟达和AWS似乎都认同,人工智能推理的未来将通过系统性方法来解决,即将不同类型的芯片整合在一起,以应对规模最大的大语言模型(LLM)。或者正如Ruck所说:“要进行现代人工智能推理,你需要所有类型的芯片。”
四、学习如何用更少的资源做更多的事情
英伟达之所以能成为全球市值最高的科技公司,是因为它设计出了全球最受欢迎的GPU。但并非所有的关注点都集中在改进人工智能推理硬件上。人工智能研究人员也在探索如何协同优化LLM软件和硬件,以最大限度地利用内存和计算组件。
大多数计算机以 32 位或 64 位格式存储数字。这些格式决定了可用于表示单个数字的位数。如果可用位数太少,则无法在不丢失信息的情况下存储该数字。更精确的数字格式有利于大语言模型 (LLM) 的质量,但这会给推理性能带来问题。更精确的数字并非没有代价。描述这些数字的位数会占用更多的内存空间,并且需要更多的硅片和能源来进行计算。
人工智能加速器公司Tensordyne的联合创始人Gilles Backhus表示,这造成了模型大小和数值精度之间的矛盾。“你会选择一个大小为x但以8位精度运行的模型,还是会选择一个大小是其两倍但以4位精度运行的模型?”两种模型在内存和计算方面的大小大致相同,“但4位方法可以提供两倍的突触数量。人们正在意识到(4位方法)是值得的。”
将大语言模型(LLM)从更精确的数值格式转换为精度较低的格式的过程称为量化,这项技术已经应用多年。然而,研究人员正在寻找新的方法,在量化模型的同时,尽可能保留模型的大部分质量。
英伟达最近为此创建了一种新的 4 位数字格式 NVFP4。而 AMD、英特尔和高通则转而支持另一种名为 MXFP4 的 4 位数字格式,英伟达也参与了该格式的开发。“这是人工智能的黑魔法,”英伟达的巴克说道。该公司表示,当英伟达将 DeepSeek-R1 从 FP8量化为 NVFP4 时,七项主要基准测试的得分下降不到 1%,而性能却提升了三倍。
量化可能只是冰山一角,因为人工智能研究人员和初创公司正在探索各种优化机会,其中一些机会可能会彻底改变人工智能推理硬件中的硅芯片。
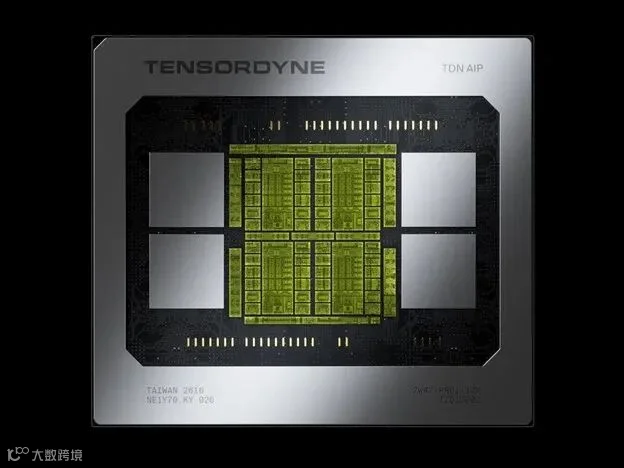
Tensordyne独特的AI推理方法将对数数字格式与公司Napier芯片中的定制硬件相结合
Tensordyne有望利用对数数制加速 AI 推理。该数制基于对数的一个特性:A 乘以 B 的对数等于 A 的对数加上 B 的对数。因此,将数字存储为它们的指数可以让芯片在原本需要乘法的地方进行加法运算。这在硅芯片领域至关重要,因为乘法电路比加法器消耗更多功率,占用更多芯片面积。Tensordyne表示,其机架级硬件 Napier 每秒可为每位用户生成高达 1300 个令牌,而功耗却不到同等 Nvidia 硬件的十分之一。
位于加州圣何塞的初创公司 Etched 正在设计人工智能加速器,将 LLM使用的 Transformer 架构直接移植到芯片上。该公司并没有构建通用 GPU,而是将高效 Transformer 计算所需的连接集成到芯片中,这使得芯片的灵活性大大降低,但对于当前 LLM 最常执行的任务而言,效率却更高。该公司表示,其首款人工智能加速器 Sohu 可以以惊人的每秒 50 万个词元的速度运行 Meta 的 Llama 70B 模型,但这种方法也意味着它无法运行那些偏离典型 Transformer 架构的 LLM。
这些想法能否最终成功还有待观察。Etched 刚刚在八月份交付了他们的首批机架。Tensordyne则认为他们的首款硬件产品将于 2027 年上市。即便如此,这些初创公司也表明,对推理性能的需求正在推动一些非传统的创新理念。
五、推理是人人都能参与的游戏
AI推理加速方法的种类繁多—将计算堆叠在内存上、将接口从毫米扩展到米、使用整个硅晶圆作为SRAM、将模型压缩到4位—这引发了一个问题:哪种方法会胜出,哪种方法会失败?
但专家表示,这可能并非正确的问题。目前市场对人工智能的需求依然旺盛,尽管业界对人工智能泡沫的担忧挥之不去,但这尚未阻碍其增长。
相反,Moor Insights & Strategy 的 Kimball 认为,从长远来看,推理功能可能会推动对人工智能硬件的强劲需求,因为这种需求何时才能停止尚不明朗。“你可以在你的组织中增加一百万个智能体,”他说。“这些机器一天 24 小时都在工作;它们不像我们一样晚上五点就下班回家。”
如果人工智能推理能力真如Kimball所预期的那样令人向往,那么它的发展轨迹很可能与CPU类似。CPU的进步并非局限于单一维度,而是多方面同步发展。随着晶体管尺寸缩小速度的放缓,各种芯片和系统架构的创新层出不穷。如今,个人计算设备无处不在,功能强大,而促成这一现象的创新之多,足以写成几十本书。
几十年后,人工智能推理创新史也将展现出类似的深度。
✦
•
✦
文章来源
✦
✦
✦
原文链接 :
https://spectrum.ieee.org/inference-hardware-revolution
能创科技致力于科技促进能源创新和提升能源效率及实现零碳排放,科技促进研发机器人智能装备,推动工业及智能制造转型升级。能创科技的发展目标是成为领先的科技公司。
