

在长视频生成任务中,大模型上下文长度已膨胀至百万级,注意力机制的计算和访存开销成为制约模型推理效率的重要瓶颈。量化和稀疏是加速注意力计算的两类关键技术。面向昇腾950系列硬件,MindIE SD(Mind Inference Engine Stable Diffusion)视图生成推理模型套件推出基于CANN BlockSparseAttention算子的量化-稀疏联合注意力机制Eagle Quant Block Sparse Attention(EagleQBSA),在精度达标的前提下,EagleQBSA实现整网注意力模块最高加速7.6倍。在5s视频生成任务中,Wan2.2模型端到端加速1.6倍,MiniMax-H3模型端到端加速1.52倍。
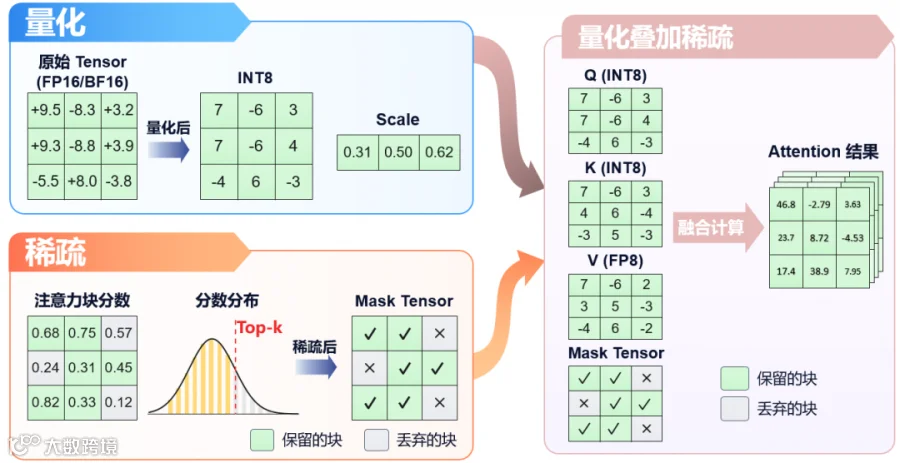
图1 量化稀疏注意力示意图
注意力的稀疏与量化是两类加速注意力计算的推理优化方法。如下图所示,稀疏注意力利用注意力权重通常集中在少数连接上的特点,只计算局部区域的重要连接,跳过一部分对KV向量的访问和计算;量化注意力则把QKV从高精度压缩到 FP8、INT8、FP4等低精度表示,利用低精度算力加速矩阵乘法计算,同时减少显存占用和访存带宽压力。
稀疏和量化管线天然正交,具备叠加优化的空间。然而,在算法层面,稀疏选择往往会改变数据分布,进一步放大量化误差,二者的直接组合容易影响视觉模型的生成质量。在实现层面,加速收益不仅取决于矩阵乘法的吞吐,还受限于Softmax的计算和更新。低比特矩阵乘提速后,Vector侧开销可能成为新瓶颈,需结合硬件能力优化计算链路。
对于稀疏注意力,MindIE SD套件已经集成了自适应的块稀疏注意力特性AdaBSA,在此基础上,本工作重点考虑注意力中QKPV矩阵的量化。EagleQBSA采用QK按块INT8量化、V按通道FP8量化,并以FP8完成PV计算。通过对视频生成任务中整网获取的QKV矩阵分析发现,由于时空局部性,尽管QK矩阵在整个序列上分布差异较大,但在同一块内部,局部QK序列的数据分布往往相对集中,因此适用于在序列维度按块量化。为了进一步确定QK量化的数值格式,对整网的QK分别进行FP8量化和INT8量化的注意力计算并比较相对BF16基线的误差。结果表明,QK FP8量化的单算子误差是INT8量化的3~4倍。因此QK矩阵采用INT8量化是更好的选择。
为了反量化步骤的效率,V矩阵通常采取按通道量化。一般来说,V矩阵的数据分布较为离散,动态范围超出INT8量化的适配能力,因此适合FP8量化,而P矩阵跟随V采用FP8量化。实测表明,P/V INT8量化相比P/V FP8的方案,单算子精度误差将增大2~3个数量级。
总的来说,EagleQBSA采用QK INT8/PV FP8的混合精度量化,并结合块稀疏注意力,实现量化联合稀疏注意力加速,具体流程如下图所示。
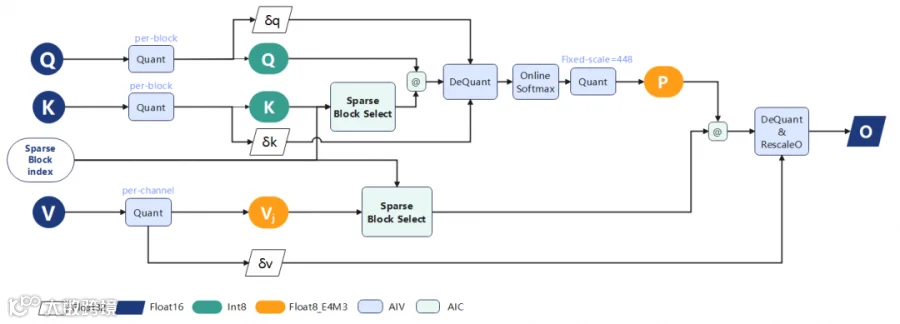
图2 EagleQBSA方案计算流程
低精度量化加速Cube计算,造成了Vector单元的访存和计算瓶颈。昇腾950系列支持在Cube与Vector之间直接搬运数据,并提供寄存器级(Regbase)Vector开发能力,为缓解Vector瓶颈,进一步提高算子整体性能提供了途径。
对于Softmax计算步骤,EagleQBSA算子在从Cube向Vector搬运矩阵乘结果的同时进行矩阵转置,如下图所示,Softmax计算中一行数据的归约操作(求最大值/求和)被转为多列数据的两两归约,从而提高数据并行程度,最大限度压榨Vector硬件算力。
对于P矩阵的量化步骤,EagleQBSA通过位运算实现FP16到FP8格式的近似转换,相比标准的FP16到FP8数值转换具有更低的开销,进一步缓解了Vector计算瓶颈。

图3 Vector归约优化
单算子测试覆盖8K至128K序列长度,其余输入shape配置为B=1、N=40、D=128。同等稀疏率下,EagleQBSA相对BF16块稀疏BSA算子加速约1.6倍;在64K序列、0.9稀疏率下,相对非稀疏的浮点注意力算子FaScore最高加速14.7倍。
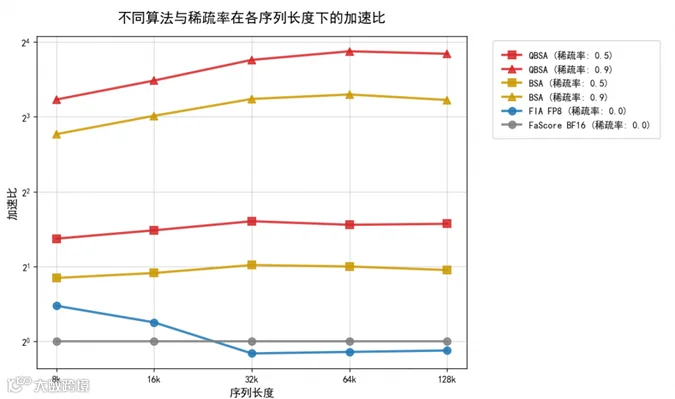
图4 不同序列长度下各算法相对FaScore的单算子加速比
与基线方案相比,测试模型仅改变自注意力模块的计算方式为EagleQBSA,线性层保持不变。在Wan2.2模型上,稀疏率典型值为0.63,文生视频和图生视频任务相比基线分别加速1.64倍、1.61倍;在MiniMax-H3模型上,稀疏率达到0.8,文生音视频任务端到端加速1.52倍。

表1 多模生成任务端到端耗时统计
VBench评测中,从主体一致性、成像质量、美学质量、整体一致性和运动平滑度这五个维度打分,取各维度平均值作为最终评分。两类任务相对BF16基线的整体精度误差均小于1%;文生视频使用48条t2v_sora文本输入。结果仅反映本次测试配置,不代表所有内容和模型均无精度损失。
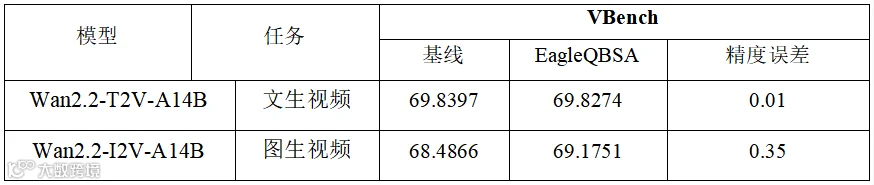
表2 多模生成任务VBench评分
下图展示的是不同方法在相同提示词下生成视频的画面对比,可见EagleQBSA与基线的画面主体和风格保持一致。
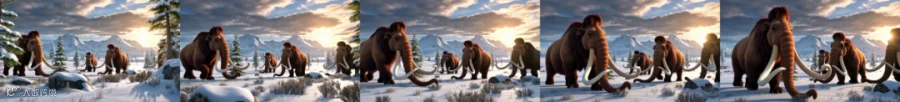
图5a Wan2.2-T2V-A14B 文生视频 基线
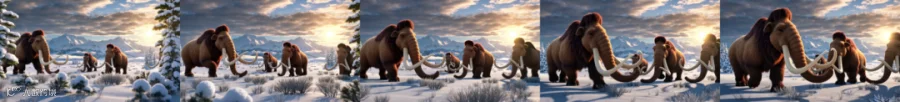
图5b Wan2.2-T2V-A14B 文生视频 EagleQBSA
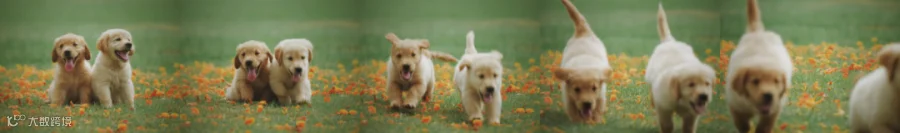
图6a Wan2.2-I2V-A14B 图生视频 基线
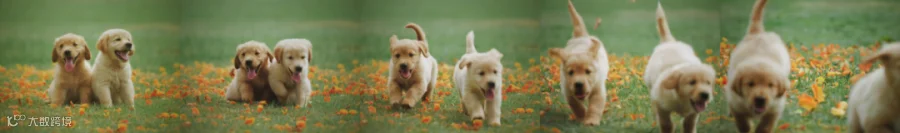
图6b Wan2.2-I2V-A14B 图生视频 EagleQBSA

图7a MiniMax-H3 文生音视频 基线

图7b MiniMax-H3 文生音视频 EagleQBSA
本工作基于昇腾950平台完成了量化联合稀疏注意力机制的推理加速实践,实现了高效的INT8-FP8混合精度量化稀疏注意力算子EagleQBSA。在精度达标的前提下,实现整网注意力模块最高加速7.6倍。在5s视频生成任务中,Wan2.2模型端到端加速1.6倍,MiniMax-H3模型端到端加速1.5倍。
该特性基于CANN的BlockSparseAttention算子开发,结合面向多模态生成场景的量化与稀疏协同优化,已随MindIE SD发布。欢迎开发者和客户在视频生成场景中试用,也欢迎把使用反馈带到昇腾社区一起讨论。
CANN算子源码:
https://gitcode.com/cann/ops-transformer/tree/master/attention/block_sparse_attention
开源社区链接:
https://gitcode.com/Ascend/MindIE-SD/pull/608
