



10 个关键问题 Q&A
-
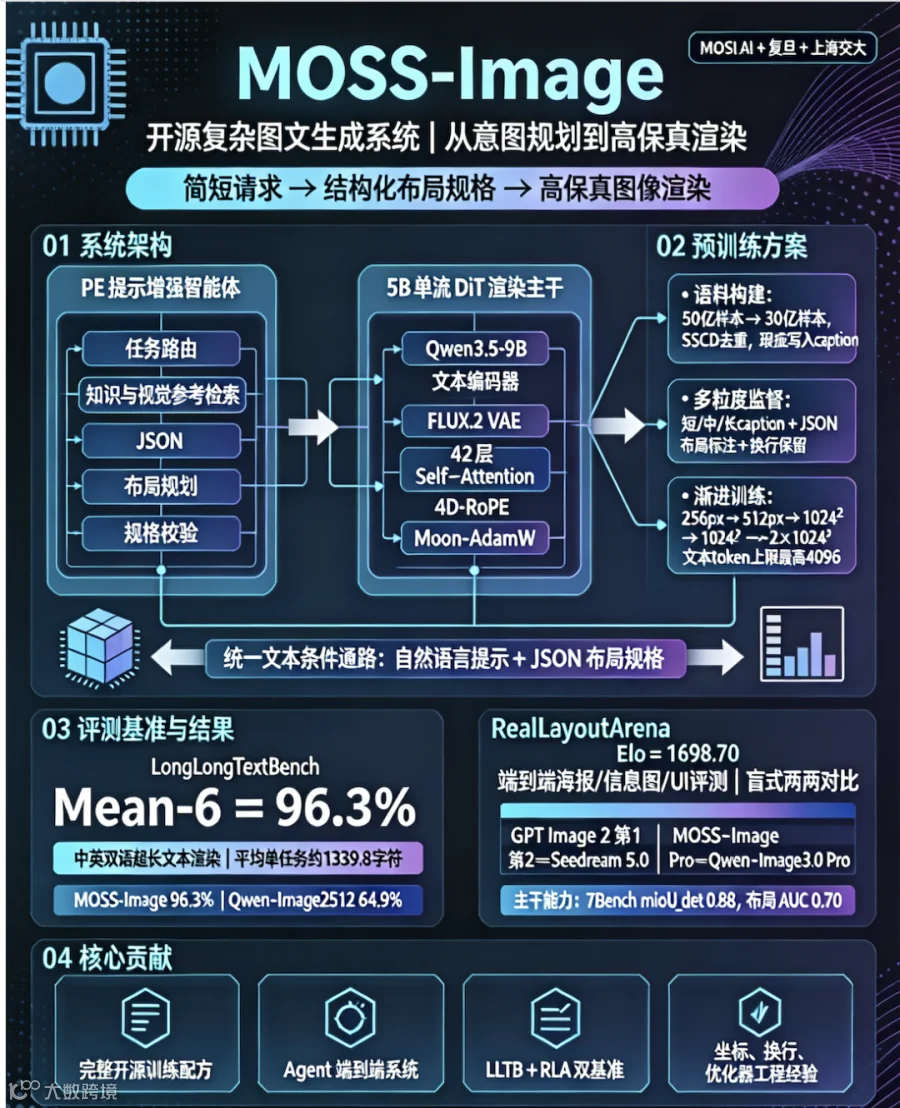
Q:MOSS‑Image 是什么? A:复旦、上交、MOSI.AI 联合推出的开源复杂图文生成系统,擅长生成带大量文字的信息图、海报、UI。 -
Q:系统由哪两大模块构成? A:Agent 提示增强模块 PE + 5B 单流 DiT 渲染主干。 -
Q:PE 模块的核心作用? A:把简短用户指令转化为带 bbox 包围盒的 JSON 结构化布局规格,直接供 DiT 渲染。 -
Q:DiT 主干有什么特色? A:支持自然语言与 JSON 布局两种输入,使用 4D-RoPE 与 Muon‑AdamW 混合优化器。 -
Q:训练语料处理有什么特殊设计? A:50 亿样本过滤至 30 亿,不做额外启发式质量过滤,瑕疵直接写入 caption 训练。 -
Q:提出哪两个评测基准? A:LongLongTextBench(LLTB,超长文本)、RealLayoutArena(RLA,真实布局人类评测)。 -
Q:LLTB 相比旧文本评测集优势? A:样本平均字符量约为 LongTextBench 的 11 倍,用于评估中英双语超长文本渲染。 -
Q:MOSS‑Image 的核心性能水平? A:LLTB 开源 SOTA;完整系统 RLA 评测排第 2;固定提示下主干模型 Elo 分数第一。 -
Q:哪些设计显著提升排版效果? A:JSON 布局输入、文本换行符、中心相对绝对像素坐标。 -
Q:当前模型主要局限性? A:主干仅支持文生图,不支持参考图与图像编辑;PE 依赖外部大模型,会引入规划错误。
MOSS‑Image 由 MOSI.AI 联合复旦大学、上海交通大学推出,是开源复杂图文生成系统,重点解决现有开源文生图模型长文本渲染、复杂布局生成能力弱的痛点,可生成信息图、海报、UI 等文本密集型图像;项目开源模型、训练方案与评测框架,提供 GitHub 仓库、HuggingFace 在线 Demo。
1 研究背景与问题
闭源图像生成模型(GPT Image2、Seedream5.0 Pro 等)可以完成信息图、知识卡片这类复杂图文创作,但开源权重模型(SDXL、FLUX、Qwen‑Image 等)存在两大耦合难题:
- 渲染问题
难以准确生成长文本,难以遵守空间布局约束;外观看着合理,但文字不可读、内容残缺、空间排布混乱。 - 规格定义问题
用户简短提示只给出主题,缺少具体内容、信息层级、空间排布说明。
只靠详细提示无法保证渲染正确;只靠强渲染模型,无法补全用户缺失的设计决策。因此需要一套意图感知的规格规划 + 高保真渲染完整系统,同时需要端到端评测基准。
2 整体系统架构
MOSS‑Image 由两大模块构成:5B 从头预训练单流 DiT(扩散 Transformer)渲染主干+ Agent 提示增强模块 PE(Prompt Enhancement)。
- Agent 提示增强模块 PE
接收用户简短输入,输出详细的内容 + 布局规格(自然语言或者 JSON 布局格式,包含文本内容、包围盒 bbox、排版)。 - DiT 渲染主干
统一文本条件通路,既可以接收普通自然语言提示,也可以直接读取结构化 JSON 布局规格完成图像渲染。
2.1 5B 单流 DiT 主干模型
-
组件配置:冻结 Qwen3.5‑9B 作为文本编码器,冻结 FLUX.2 VAE;主干共 42 层,采用Joint Self‑Attention 联合自注意力、SiTU‑GLU 门控前馈网络、4D‑RoPE 旋转位置编码。 -
4D‑RoPE 四个维度:参考索引 r、序列位置 t、图像宽度 w、图像高度 h;没有参考图输入时 r=0,该维度不旋转,为未来参考图条件生成预留扩展能力。 -
优化器:Muon‑AdamW 混合优化器,对比纯 AdamW 收敛速度更快,达到相同损失可以减少约 28‑33% 训练步数。
2.2 Agentic Prompt Enhancement(PE,提示增强智能体)
使用 GPT‑6 作为规划器,处理简短用户请求:
- 任务路由
区分海报、信息图、UI 不同任务,加载对应任务的设计指导。 - 知识与视觉参考检索
按需检索知识、参考样例,规划图像内容。 - 可执行布局规划
输出 JSON 格式规格,包含场景类型、宽高比、元素、文本、bbox 包围盒、调色板、禁止项;会校验 JSON 合法性、坐标、文本适配画布,再喂给 DiT 统一文本输入接口。
对比普通提示增强 Agent:普通 Agent 只能输出自然语言,本模块可以输出结构化布局规格,直接被 DiT 理解执行。
3 预训练完整方案
预训练分为:语料构建、多粒度结构感知监督、分阶段渐进式训练三部分。
3.1 预训练语料构建
数据源来自 ReLAION、OmniCorpus、DataComp 等公开多模态数据集。
-
预处理:SSCD 去重,自研检测器过滤 AI 生成图,原始 50 亿样本过滤得到 30 亿样本。 - 关键设计:不做额外启发式质量过滤
。不直接过滤有水印、模糊的图片,改为把瑕疵直接写进 caption 参与训练;消融实验证明额外过滤会损害生成质量,尤其严重降低文本渲染效果。
3.2 多粒度、结构感知文本监督
- 多粒度描述
对同一张图生成短、中、长三种粒度 caption,不是固定 token 长度,而是语义详略不同;训练时原始 caption 和重写 caption 采样比例 20:80;短 / 中 / 长描述均匀采样。 - 结构化布局标注
部分样本增加 JSON 结构化标注,包含全局描述、物体、文本元素、bbox 包围盒、转录可见文字;保留原始换行符,换行作为布局信息监督模型多行文本排版。 -
标注会做随机丢弃字段、打乱元素顺序、多种坐标格式随机采样(归一化、绝对像素、中心相对像素),提升泛化;消融证明中心零绝对坐标对未见过的分辨率泛化效果优于归一化 [0‑1000] 坐标。
3.3 分阶段渐进式训练(Progressive training)
分多阶段逐步提高图像分辨率、提升文本 token 上限:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
损失使用 Flow‑matching 损失;噪声采样采用截断 logit‑normal 采样混合少量均匀采样。
4 提出两个全新评测基准
现有 LongTextBench 文本平均仅 120 字符,模型分数接近饱和,难以评估超长文本能力;7Bench 仅评估布局,不能评估端到端根据用户需求设计图文。
- LongLongTextBench(LLTB)
评估中英双语超长文本渲染 -
240 任务,中英各 120,分短 / 中 / 长三档;总字符 321545 字符,平均单任务1339.8 字符,约为 LongTextBench 的 11 倍,最短样本字符就超过 LongTextBench 最长样本。 -
指标 Mean‑6:6 组(中英 × 短中长)覆盖率的等权平均;用 OCR 多集合召回计算文本覆盖率。 - RealLayoutArena(RLA)
端到端复杂图文人类评测基准 -
61 个真实设计任务(20 海报 + 20 信息图 + 21UI),输入都是简短用户指令;采用盲式两两人类对比,Bradley‑Terry 拟合 Elo 分数;综合评测指令跟随、内容完整度、文本可读性、视觉布局。
5 主要实验结果
5.1 LLTB 长文本渲染评测
MOSS‑Image 开源模型中 SOTA,Mean‑6=96.3%,大幅超过其他开源模型(Qwen‑Image2512 为 64.9%),接近闭源顶尖模型水平;长英文 97.1%,长中文 92.4%。
5.2 7Bench 布局控制评测(仅主干,不使用 PE)
MOSS‑Image 大幅领先全部对比模型:mIoU_det=0.88,Layout AUC=0.70;对比第二名 Ideogram4.0 仅 0.44/0.20,证明主干极强的空间布局控制能力。
5.3 RLA 端到端完整系统评测(主干 + PE 提示增强)
-
MOSS‑Image Elo=1698.70,全部系统中排第 2;仅次于 GPT Image2,高于 Seedream5.0 Pro、Qwen‑Image3.0 Pro。 -
消融实验提示策略:JSON 布局规格提示 > 直接扩展提示 > 详细提示 > 简短原始提示;证明结构化布局输入显著提升人类偏好。 -
固定使用统一增强自然语言提示,剥离 PE 模块,只对比不同主干模型:MOSS‑Image 主干 Elo=1807.34,所有主干模型第一,说明主干本身就极强,不是单纯靠提示增强。
5.4 补充自动 rubric 打分
GPT‑6 多维度加权自动打分作为辅助指标,和人类 Elo 趋势大体一致,但对细微布局差异区分度不足,论文以人类成对比较作为主要结论。
6 案例研究与关键设计验证
- 布局零样本修改
仅修改布局 JSON 提示,不需要原图输入、不需要微调,就可以完成元素重排、替换大标题文字,保持整体视觉风格不变。 - 换行符作用
提示中显式换行,在去噪更早阶段就生成每行正确字符,显著改善最终多行文本渲染质量。 - 包围盒坐标
中心相对绝对像素坐标,对训练没有见过的高分辨率泛化更好;归一化坐标会把内容挤压到画布中心。
7 局限性
-
当前主干只支持文生图,不支持参考图输入、图像编辑;是未来工作。 -
Prompt Enhancement 依赖外部大语言模型,大模型事实错误、审美缺陷,会造成生成规格本身出错,即便 DiT 渲染完全忠实规格,最终结果依旧会有缺陷。
8 贡献总结
- 预训练主干模型
从零预训练 5B 单流 DiT,统一条件通路同时支持自然语言 + 结构化布局输入;公开完整训练配方(数据、监督方式、渐进训练、优化策略),开源权重。 - Agent 端到端生成系统 MOSS‑Image
意图感知提示增强 Agent,把几个字的简短用户请求转为可执行 JSON 布局规格,和渲染主干协同生成海报、信息图、UI。 - 两套评测基准 LLTB、RLA
分别评估超长双语文本渲染、真实场景端到端复杂图文生成;系统在 LLTB 开源模型 SOTA,RLA 端到端第二;主干在共享提示条件下取得第一。 -
大量消融实验:数据过滤策略、RoPE 坐标、优化器对比、提示策略对比、坐标格式、换行作用,为后续文本密集图像生成提供工程经验。
9 相关工作简述
对比三类方向:文生图基础模型、视觉文本生成模型、布局可控生成、Agent 提示增强、评测基准;和同期 Ideogram4 等工作对比,MOSS‑Image 完整公开全部训练配方,不只是发布推理权重。