


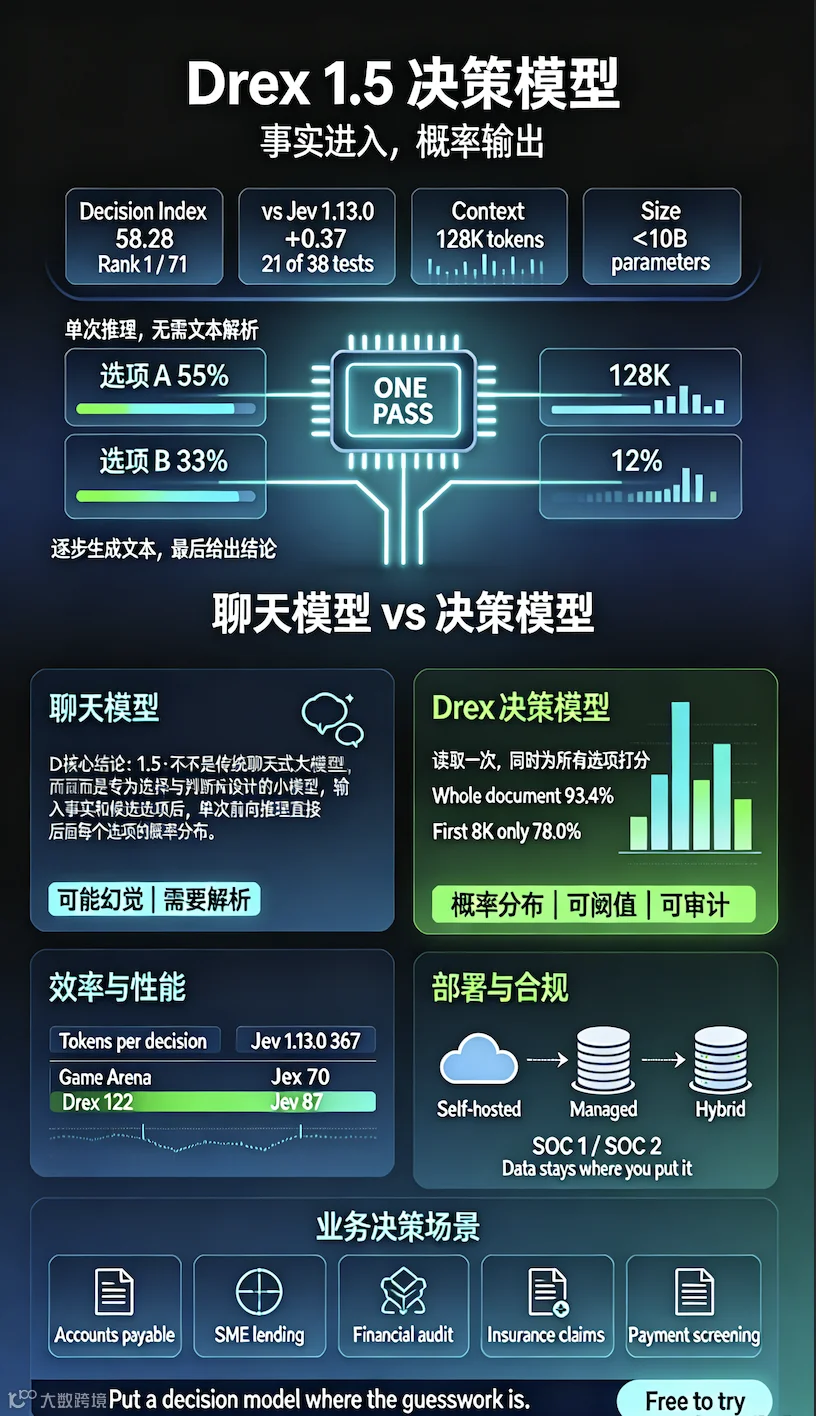
编者摘要:Drex 1.5 是 Nace AI 推出的专用决策模型(Decision Model),区别于生成式 LLM,不输出自由文本;输入事实与候选选项,单次前向推理直接输出各选项概率分布,无幻觉、无需文本解析,模拟人类 System1 直觉决策。模型参数量<10B,支持 128K 上下文窗口,相比上一代 32K 大幅提升,长文档读取全文准确率远高于仅截取前 8K 内容。
在 Decision Index 0.2.1 评测中,Drex1.5 在 71 个模型里排名第一,总分 58.28,领先同类标杆 Jev1.13.0(+0.37),38 项决策类测试赢下 21 项;且推理 token 消耗仅为 Jev 的 1/5。棋类对战中,8 款游戏 256 场对局总战绩 Drex 占优。支持 FP8 量化,98.1% 决策结果不变,显存减半。
适配信贷、保险理赔、应付账款审核、工单路由等企业业务。部署模式包含私有化、托管、混合部署,私有化方案保证数据不出内网,具备 SOC1/SOC2 审计合规,适配金融等高监管场景,支持基于企业自有业务标签数据微调。 模型可输出概率分布而非单一判定,方便设置阈值,自动处理高置信案例,不确定项流转人工复核,适合业务流程自动化。

10 个关键问题Q&A
-
Q:Drex 是什么模型?和普通 LLM 有什么根本区别? A:Drex 是决策专用模型。普通 LLM 生成文本,易幻觉,需要解析输出;Drex 不生成文本,限定候选选项,直接输出概率分布,单次推理完成打分。 -
Q:Drex 1.5 参数量与上下文窗口? A:总参数量<10B,支持最高 128K token 上下文。 -
Q:Decision Index 是什么?Drex 成绩如何? A:Decision Index 是面向决策任务的评测基准,共 38 项测试,分数经过随机猜测校正。Drex1.5 得分 58.28,71 个参评模型中排名第一。 -
Q:Drex 对比标杆 Jev 核心优势? A:总分更高,38 项测试赢 21 项;单次推理读取 token 仅 Jev 的 1/5;棋类对抗总战绩更强;支持更长 128K 上下文。 -
Q:Drex 可以处理哪些业务场景? A:信贷审批、保险理赔、应付账款审核、客服工单路由、合同判定、工具调用路由等企业决策场景。 -
Q:FP8 量化对 Drex 的影响大吗? A:很小。98.1% 决策结果不变,概率平均偏移仅 0.015,显存占用减半,适合私有化部署。 -
Q:Drex 支持哪些部署方式? A:三种模式:私有化本地部署、Nace 托管部署、混合部署;私有化场景数据不流出企业内网。 -
Q:Drex 是否支持基于企业自有业务数据微调? A:支持,可用企业标注业务结果微调模型,交付专属权重。 -
Q:Drex 合规能力如何,能否用于金融审计场景? A:具备 SOC1、SOC2 Type II 审计认证,决策日志完整可追溯,适配财务、风控等强监管业务。 -
Q:Drex 输出概率分布的业务价值是什么? A:不只是简单 “是 / 否” 判定;可设置阈值,高置信案例自动执行,边界模糊案例流转人工复核,降低误判风险。
附录 Drex 简介:做决策的小模型
输入事实,输出每个候选选项的概率。单次前向推理,无需文本解析。 https://drex.nace.ai/?utm_campaign=drex-launch&utm_content=hero&utm_medium=website&utm_source=nace.ai 复制配置提示词
决策指数 0.2.1,排名第 1,得分 58.28相比 Jev 1.13.0,高出 +0.37上下文窗口 128K token总参数量 <10B
决策指数 0.2.1 评测:Drex 1.5,71 个参评模型中位列前五 横轴起始刻度是 55,非 0;模型名称下方标注总参数量;Jev 参数量未公开 Drex 1.5(<10B)|Jev(未公开)|Rune(258 亿)|Decider(327 亿)|AutoJev(278 亿)|simple(278 亿)
-
《星际争霸 2》人族基地对抗内置 AI:每一条指令都是一次选择 -
业务流程:供应链场景,从订单到最终结果,每个检查点由 Drex 完成一次决策 -
Doom 死亡竞赛:每帧 4 个问题 —— 目标、开火、移动、武器选择;面板实时输出结果 -
旅鼠(Lemmings):分配每只旅鼠的技能与行动位置,每次分配即一次决策 -
舰队(Armada):每轮为所有舰船下达指令,进攻或重整,仅调用一次模型
客户信任
四大会计师事务所 首批登上公开决策指数榜单,性能超过其余所有参评模型
决策指数 0.2.1 包含38 项决策类测试(侧重判断而非文本生成):合同、因果推理、工具调用、路由、综合判断。指数经过随机概率校正,纯随机猜测得分为 0。 Drex 1.5 参数量不足 10B,在 71 个参评模型中位居榜首;榜单前十里其他公开参数量的模型,规模均在 258B~327B 之间。
评测总表(决策指数 0.2.1,38 项测试,经随机校正。下方各行是单项指标)
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
| 知识与推理 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 语言理解 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 检索与分类 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 工具与自动化 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 人文与主观偏好 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Drex1.5 于 2026-09-28,使用官方 0.2.1 评测套件跑完全部 38 项基准;上一版 Drex1.1 使用同一套件。表格单元格为单项测试指标;总分是经过随机校正后的决策指数,平台判定差距小于 0.25 即视为平局。其余模型分数取自公开榜单,数据读取时间 2026-09-28。 https://discord.com/invite/nace-ai
输入问题,Drex 输出每个答案的概率。 把案件事实和你接受的候选选项发给 Drex。单次模型前向推理,返回每个选项对应的概率。它不会生成文本,因此无需解析,也不会编造内容。
适用场景:应付账款、中小微企业信贷、财务审计、保险理赔、支付风控筛查
【示例输入】 申请人:成立 6 年的物流企业,营收 420 万美元,同比下滑 8%,债务偿付比率 DSCR=1.18;24 个月内有 2 次逾期付款记录;申请 65 万美元贷款,抵押物价值 90 万美元。 这笔申请如何处理? 选项:移交核保专员・附条款批准・拒绝
单次推理输出 移交核保专员:55% 附条款批准:33% 拒绝:12%
输出仅为各选项概率,没有额外文本,无需解析。(数值仅作演示,页面下方附真实测试结果)
它不是聊天机器人,是另一种思考范式。 心理学将审慎分步推理称为系统 2;熟练、直觉式判断称为系统 1。 聊天大模型属于系统 2:逐字生成文本,最后给出结论。 决策模型属于系统 1:学习过大量决策场景形态,单次推理直接输出置信概率。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
输出的是概率分布,而不是单一结论。 因为返回全部选项的概率,你可以直观判断决策边界是否模糊。设定阈值,把高不确定性案例流转人工审核;高置信案例可自动处理,无需人工阅读。 每个面板都是案例示例,每一栏是对应选项概率;页面下方有完整真实记录。
应付账款场景:该发票如何处理? 争议・暂存待买方确认・通过
和 Jev 是同类模型吗?
属于同类决策模型,决策指数得分更高。 Jev 正是这份公开决策指数所命名的基准模型。Drex 接收同类请求、输出相同格式结果,指数得分更高,单次决策读取 token 数量仅为 Jev 的 1/5。
-
决策指数:Drex1.5 58.28,Jev1.13.0 57.91,领先 0.37 分;38 项测试中赢下 21 项 -
单次决策读取 token(8 次相同请求中位数):Drex1.1=70token,Jev1.13.0=367token -
JevBench(231 条公开样本,各模型调用自身 API) -
Jev1.13.0:87.0%(201/231) -
Drex1.5:86.2%(199/231) -
Drex1.1:82.2%(190/231)
Drex1.5 在棋类对战中同样胜过 Jev:总战绩 122 胜 vs 87 胜。 8 款游戏,256 场对局;所有合法走法都作为候选选项输入。两个模型都不做未来推演,每一步仅单次读取棋盘状态。 Drex1.5 在 8 款游戏中的 5 款取得更多对局胜利,总战绩领先。
Drex1.5:122 胜|47 平局|Jev:87 胜 测试使用 Kaggle Game Arena 框架、OpenSpiel 游戏规则。每款游戏设置 16 种开局,双方互换先后手,消除先手优势。计分:胜 = 1 分,平局 = 0.5 分。最后一列为 Drex1.1 在相同协议下对战 Jev 的得分。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
可读取完整长文档,最高 128K 上下文
Drex1.5 单请求最高支持 128K token(Drex1.1 仅 32K)。 针对长文档问答场景:读取全文的准确率显著高于只读取前 8K,且该优势在 32K 以上仍然成立。
-
8K~32K token,单请求中位数耗时 0.65 秒 -
读取全文:89.5%|仅前 8K:76.5% -
32K~128K token,单请求中位数耗时 2.0 秒 -
读取全文:93.4%|仅前 8K:78.0%
Drex1.5 长文档问答准确率;所有请求一次性前向推理完成。“仅前 8K” 指同一份文档截断至前 8K token。
在线体验:真实案例,原始返回结果
任选案例,两列输入完全相同文本与问题;两个模型都不会输出句子文本。 可选案例:客服工单、合同自然语言推理、讽刺识别、工具路由、小学数学、搜索相关性、标题编辑、模型路由
示例:客户消息(Jev 官方文档同款示例,同时输出分类 + 是否人工升级)
案例原文 客户:上周二被扣两次款项,我很生气。订单号 #4419,要求今天退款。
问题 主题分类:账单问题・程序 bug・物流 是否升级人工:是 / 否 记录时间 2026-09-24
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
在主题判断上,Jev 直接输出绝对化 1.000/0.00;Drex 输出概率分布,方便设置阈值分流。
自己跑案例
粘贴案例文本,自定义候选选项,直接获取概率。免费试用,无需绑定信用卡。 https://drex.nace.ai/?utm_campaign=drex-launch&utm_content=playground&utm_medium=website&utm_source=nace.ai
部署方案:在你的数据所在地运行
模型体量轻,可以私有化部署、自主保管。任意部署方式,同一请求返回结果格式完全一致
-
本地私有化部署:部署在你的云账户、边缘设备或本地机房。单卡即可加载,决策数据不离开内网 -
托管部署:Nace 托管基础设施,容量、扩缩容、版本升级由厂商维护 -
混合部署:涉及强监管数据的决策保留在你的环境,其余请求走托管服务;请求格式、输出结果完全相同
可基于你的业务决策数据微调 页面所有评测结果均基于决策数据集训练。可使用你标注的业务结果微调 Drex,交付专属权重文件。
FP8 量化后,98.1% 的决策结果保持不变 Drex1.1 在 FP8 精度下决策行为与 bf16 基本一致。FP8 权重内存占用减半。 2511 道测试题对比:FP8 与 bf16 输出相同答案占 98.1%;概率平均偏移 0.015,最大偏移 0.29;FP8 准确率 92.57%,bf16 为 92.49%。
FAQ
-
什么是决策模型?它和 LLM 有什么区别? -
它能处理哪些类型问题? -
和 Jev 对比如何? -
模型参数量多大? -
训练集是否包含评测基准数据? -
是否可以部署在我方环境、基于我方业务数据训练?
合规:SOC1 & SOC2 认证,审计落地,不是口头承诺
独立审计机构核验 Drex 的管控体系,满足强监管业务场景落地。
-
SOC1:财务报告管控。当 Drex 决策结果用于财务报表流程时,审计重点:权限、变更管理、运维流程 -
SOC2:安全管控。Type II 报告覆盖 Drex 的构建、部署、运维;审计师持续数月验证安全控制。
缩短供应商安全评审流程 直接交付审计报告,不用反复填写安全问卷。 适配你现有审计流程 Drex 可以嵌入你现有审计覆盖的业务流程,无需单独申请例外审批。
数据留存于你指定环境 私有化 / 混合部署场景,模型读取的业务案例不会流出内网。 每一条决策均可留痕 每次输出都是你给定选项的概率,所有决策可完整日志留存、复核。
https://www.nace.ai/contact?product=drex&source=drex-compliance
把决策模型放在不确定性最多的业务环节。 即刻免费试用。业务微调 + 私有化部署方案可按需落地。https://drex.nace.ai/?utm_campaign=drex-launch&utm_content=cta_band&utm_medium=website&utm_source=nace.aihttps://www.nace.ai/contact?product=drex&source=drex
要点提炼
- 产品定位:决策专用模型(Decision Model),不是生成式大模型
不生成自然语言,输入事实 + 候选选项,直接输出各选项概率分布,杜绝幻觉文本、无需解析 JSON。类比系统 1 直觉决策,一次前向推理完成打分。 - 核心亮点
-
参数量<10B,128K 上下文窗口;长文档读取全文,相比截断前 8K 有巨大准确率提升 -
在 Decision Index 0.2.1 榜单 71 个模型总分第一,超过同类标杆 Jev;单次推理 token 消耗仅 Jev 约 1/5 -
支持私有化 / 托管 / 混合部署;FP8 量化损失极小;SOC1/SOC2 审计合规,适合金融、风控、审计、保险等高合规业务 -
业务场景:信贷审批、保险理赔、应付账款审核、工单路由、合同判定、工具调用路由等 - 与 Jev 对比
同类型决策模型,Drex 总分更高;JevBench 综合准确率略低,但长文档、token 效率优势显著;棋类对战总战绩 Drex 胜出。 - 本质差异 vs LLM
LLM 是生成文本,最后给出答案,容易出现幻觉、输出格式错误,需要额外解析;Drex 只在你预先限定的选项集合上输出概率,输出可控,适合自动化业务决策流水线。