


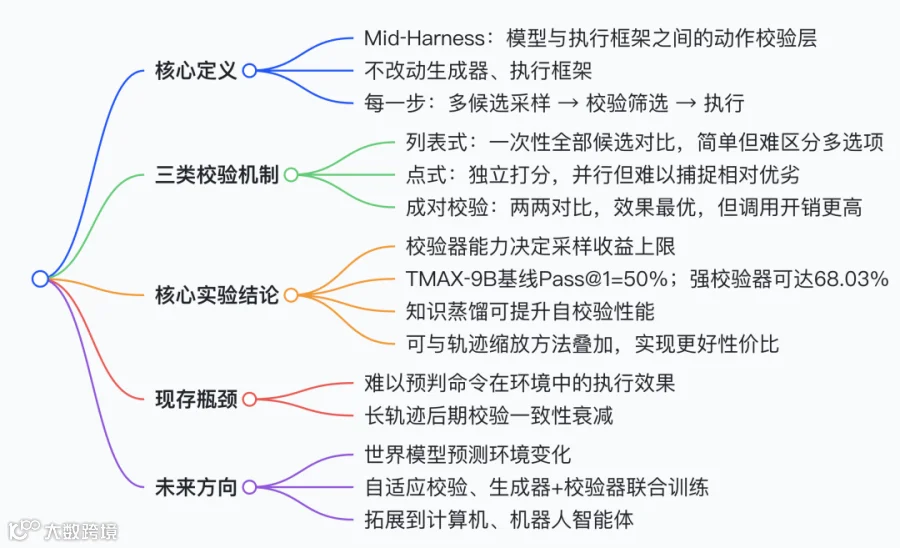
10 个关键问题 Q&A
- Mid‑Harness 核心定位是什么?
在大模型和终端执行框架之间增加一层动作校验,动作执行前筛选候选命令,不改动原有模型和执行环境。 - 和传统轨迹缩放(Best-of-T)有什么本质区别?
轨迹缩放是跑完多条完整轨迹再选最优;Mid‑Harness 在单条轨迹内部、每一步动作执行前做候选筛选,无需多次重启环境。 - 三种校验方式里哪种性能最好?
成对校验性能最优,两两对比更容易识别动作优劣,代价是更大的 token 开销。 - 单纯增加候选动作数量就能提升成功率吗?
不能。收益上限由校验器能力决定,校验能力弱时,增加候选几乎无效果。 - 知识蒸馏在这里起到什么作用?
以强校验器为教师,蒸馏得到轻量校验 LoRA 适配器,动作生成模型权重保持不变,提升自校验的准确率。 - 校验模块当前最大瓶颈是什么?
在不运行命令的前提下预判命令语义与环境执行可行性;长轨迹后期,校验判断一致性会明显下滑。 - Mid‑Harness 可以和轨迹缩放叠加使用吗?
可以。Mid‑Harness+Best-ofT / SR 组合,能用更低 token 成本,拿到比单独轨迹缩放更高任务成功率。 - 这套方案是否只能在 TMAX 模型上生效?
不是,在 4B~27B 不同规模模型、多个评测集与不同执行框架下都有正向增益。 - Pass@1 指标代表什么含义?
任务精确成功率。每个任务多次运行,统计单次运行成功的平均概率。 - 本方法有哪些落地风险?
校验判断存在误判;成对校验推理开销高;仅能作为补充手段,不能替代沙盒隔离、高危命令人工审核等安全防护。

论文信息:Minki Kang¹,²*, Ryo Hachiuma¹, Shaokun Zhang¹, Subhashree Radhakrishnan¹, Yonggan Fu¹, Jindong Jiang¹, Mingjie Liu¹, Ehsan Hosseini‑Asl¹, Yi Dong¹, Yu‑Chiang Frank Wang¹, Byung‑Kwan Lee¹† ¹ 英伟达,² 韩国科学技术院(KAIST) * 本工作为实习期间完成;†项目负责人 ©2026 英伟达,保留所有权利 arXiv:2609.39982v1 [cs.CL] 2026‑09‑30
摘要
终端智能体依靠模型的随机生成完成动作,但能够生成有效动作,不代表动作可以可靠执行。一条错误命令(例如错误的软件包安装)会改变运行环境,即便模型本可以输出更优的备选方案,也会阻碍后续任务推进。本文研究:在模型‑执行框架(model‑harness)边界分配测试时计算资源,能否提升动作可靠性与轨迹任务成功率,以及这种资源分配有效的内在条件。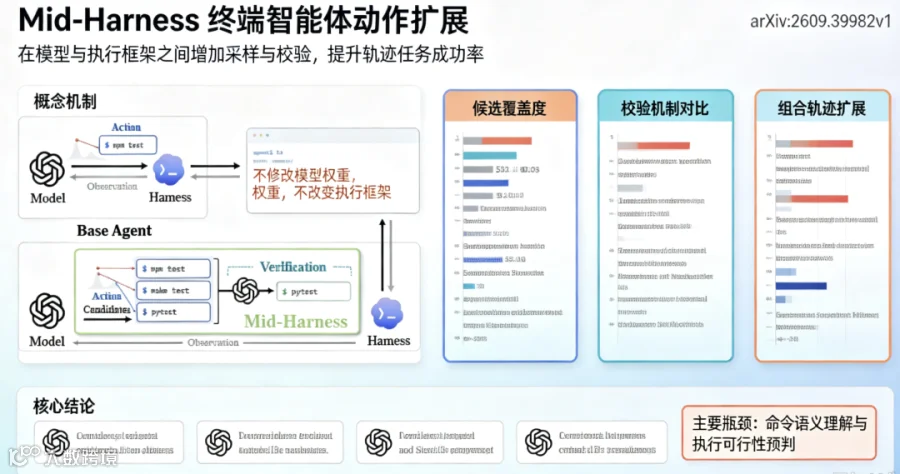
为此本文提出 Mid‑Harness:在将候选动作交给执行框架运行之前,先对多个候选动作做采样与校验,全程不改动原始动作生成器与执行框架。以 TMAX‑9B 作为动作生成器时,如果校验模块能力薄弱,增加动作采样数量几乎不会带来收益;但能力强大的校验器,可以从同一生成器输出里挖掘出可用的备选动作。
在 TerminalBench‑Lite 数据集上,使用 GPT‑5.6 Sol 作为校验器,采样 8 个候选动作时,Pass@1 指标从基础智能体的 50.00% 提升至 68.03%。当使用 TMAX‑9B 自身作为校验器时,在所有被评估的校验方案中,成对校验(pairwise verification)效果最优。把更强校验器的输出知识蒸馏到 TMAX‑9B,可以进一步提升 Pass@1,同时保持动作生成器完全不变。
在 TMAX‑9B、TerminalBench‑Lite 的实验中:同时启用动作扩展与轨迹扩展,可以用比单纯生成更多轨迹更低的预估 token 成本,实现更高任务成功率。Mid‑Harness 在更多模型、评测基准、执行框架上均能带来性能增益。这些结果证明:动作扩展是终端智能体测试时计算资源缩放中极具潜力的研究方向。项目主页见链接。
1 引言
大语言模型越来越多地驱动终端智能体,在软件工程、数据科学、科学发现领域完成任务。然而,能生成有用动作,不等于智能体能稳定完成任务。同一套模型与执行框架,有时运行成功、有时失败,因为每一次运行都要执行一长串随机生成的动作序列。每一条被执行的命令,都会改变后续决策所依赖的环境。
因此,一条糟糕的命令(错误代码修改、错误包安装),即便模型原本可以输出更好的选项,也会通过破坏环境阻碍后续任务。本文将动作可靠性定义为:持续产出有助于完成任务的动作;并通过任务成功率衡量它对整条轨迹带来的影响。
已有大量工作通过采样、校验、结果精调,在测试时投入更多计算资源来提升推理与智能体效果,其中也包含 “执行前校验候选动作” 的方案。这些工作证实,为动作可靠性分配更多计算资源是可行的;但何时、为何这种缩放能提升整条轨迹的成功率,还缺少系统性理解。尤其,产出更多候选动作能带来多少收益,高度依赖校验器识别优劣的能力,因此必须联合研究采样与校验两个因素。
因此,本文开展针对动作采样与校验的系统性研究:在动作执行前投入额外计算,何时能够提升轨迹成功率,背后的有效机制是什么?
为回答该问题,本文提出 Mid‑Harness。该框架在不改动动作生成器、不改动执行框架的前提下,在模型‑执行框架边界,用于系统性研究动作层面的计算缩放。
工作流程:每一步,Mid‑Harness 基于同样的交互历史,向生成器请求若干候选动作,交由校验器筛选,只把最终选出的动作交给执行框架运行(见图 1 (a))。
本文的核心对照实验固定 TMAX‑9B 及其执行框架,只改动候选集大小、校验机制、校验器能力,以此研究两个前提条件:
-
生成器是否能产出真正有用的备选动作; -
校验器是否可以在执行前识别出这些优质候选。
首先验证:生成器是否已经产出了只要能被识别、就可以提升轨迹成功率的备选动作。由于缺少动作候选的真实标签,本文使用能力很强的校验器来探测这种潜力。固定 TMAX‑9B 作为生成器,在 TerminalBench‑Lite 上,GPT‑5.6 Sol 校验器将 Pass@1 从基础智能体 50.00% 提升至 68.03%。这说明:生成器本身可以产出高质量备选动作,无需对生成器做微调或继续训练,仅靠校验就可以挖掘潜力、提升轨迹成功率。
接下来研究自校验场景:由同一个模型既生成动作、又校验动作,究竟可以挖掘出多大潜力。实验发现:如果校验能力弱,单纯扩大候选集宽度只能带来微弱提升。该场景下,成对校验在对比方案中表现最优,说明即便校验模型不变,候选之间的对比方式本身就会显著影响最终效果。 把 GPT‑5.6 Sol 的成对校验结果,做 LoRA 微调蒸馏得到校验器,在不改动动作生成器的前提下,进一步将 Pass@1 从 54.76% 提升到 57.14%。离线分析表明,蒸馏后的校验器和顶尖校验器的一致性有所提升,但在命令语义、执行可行性判断上,仍然存在大量分歧。这说明:如何在不实际运行命令的前提下,预判动作在当前环境中的实际效果,是把候选多样性转化为轨迹成功的核心难点。
最后探究动作扩展的收益,能否和轨迹层面的计算缩放方法叠加。在 TerminalBench‑Lite 上,Mid‑Harness 既可以和并行轨迹缩放 Best‑of‑T 结合,也可以和串行轨迹缩放 Sequential Refine(SR)叠加。TMAX‑9B 实验中,Mid‑Harness 加上一轮 SR,就可以超过 T=7 的 Best‑of‑T 效果,同时预估 token 开销还不到后者一半。同时,Mid‑Harness 在更多模型、任务、执行框架上均可以带来增益。
本文主要发现与贡献
- 校验器能力决定动作采样的收益上限
。TMAX‑9B 在 TerminalBench‑Lite 上:校验能力弱时,扩大采样候选几乎没有收益;强校验器可以显著提升轨迹成功率。 - 校验机制与校验器蒸馏可以挖掘潜力
。对比方案中成对校验效果最好;对校验器做知识蒸馏,在不改动生成器前提下进一步提升任务成功率。离线分析发现:和顶尖教师校验器的分歧,主要来自命令语义理解、执行可行性预判。 - Mid‑Harness 为终端智能体的动作缩放提供系统性研究范式
。在固定的模型‑执行框架边界,通过调整采样、校验,研究额外计算何时提升轨迹成功率;同时证明动作扩展可以和并行、串行两类轨迹缩放技术兼容叠加。
2 Mid‑Harness 方法
Mid‑Harness 的目标:保持生成器、执行框架完全不变的前提下,研究动作候选生成 + 校验如何影响轨迹成功率。伪代码展示:Mid‑Harness 作为模型调用包装层,增加候选采样和校验逻辑,最终只返回一条动作给原有执行框架,不修改模型权重、不改动部署架构。
原有执行框架主循环(完全不变) while not done: response = await model.generate (messages) actions, done = parse (response) obs = await env.execute (actions) messages = update (messages, response, obs)
Mid‑Harness 模型调用包装层 async def generate (messages): candidates = await llm.generate (messages, n=N) return await verify (llm, messages, candidates)
2.1 单条轨迹内部做动作扩展
轨迹级别的校验是对完整跑完的多条轨迹做对比筛选;而 Mid‑Harness 是在动作被执行之前就对候选动作做对比。同一交互历史产出的候选动作,目标与实际效果各不相同,例如:有的候选用于诊断失败命令,有的候选选择重试。基于尚未完成的任务需求直接对比候选,既优化下一步动作,也优化后续会进入的环境状态,而且全程只需要维护一份环境实例。
记\(\pi\)为动作生成模型,\(h_t=(o_0,a_1,o_1,…,a_{t‑1},o_{t‑1})\)代表交互历史。其中\(o_0\)是任务指令,后续观测来自终端返回信息。基础智能体从\(\pi(\cdot|h_t)\)采样一个动作直接执行。
Mid‑Harness 在相同历史条件下采样N个候选,再由校验器\(\psi\)选出其中一条:
校验函数Verify会输出候选集合里的某一条动作。执行框架运行该动作,拿到环境观测\(o_t\),更新交互历史\(h_{t+1}=(h_t,a_t^*,o_t)\);其余候选全部丢弃。下一步会基于更新后的历史,重新生成一组候选。
注:和 ReAct 一致,生成器会输出思考内容,放在标签内;校验器接收任务、历史、候选动作,但看不到候选动作对应的思考文本。
2.2 各类校验机制
给定历史\(h_t\)与候选集合\(\mathcal{A}_t\),校验机制\(Verify_\psi\)定义校验器如何调用、如何整合多条输出,选出待执行动作。本文对比列表式校验、点式校验、成对校验三种机制,观察校验形式如何利用固定生成器产出的候选集合。
列表式校验(Listwise verification)
校验器一次性接收全部候选,在同一个 prompt 内直接返回选择结果 \(i^{*}=\psi_{\text{list}}(h_t,\mathcal{A}_t)\)。
-
优点:一次模型调用,所有候选直接互相比较。 -
缺点:要求模型区分全部候选、在单轮输出内完成排序;当候选数量变多,即便集合中存在优质动作,联合决策难度也会急剧上升。
点式校验(Pointwise verification)
校验器为每一个候选输出独立标量分数 \(q_i=\psi_{\text{point}}(h_t,a_t^i)\),选择分数最高的候选 \(\arg\max_i q_i\)。和过程奖励模型的分步打分思路类似。
-
优点:N次评估完全独立,可以并行运行。 -
缺点:需要给目标完全不同的动作放到同一套打分标尺;有些动作单独看很合理,但相比其他候选实际价值更低,该模式很难捕捉这种相对优劣。
成对校验(Pairwise verification)
校验器每次只对比两条候选,输出偏好与对比分数。对一组对比对\((i,j)\),得到\(J_{ij}=\psi_{\text{pair}}(h_t,a_t^i,a_t^j)\),再通过聚合函数从全部对比结果选出最终动作。本文默认的成对校验:基于带权重的胜率做排序,选出排名最高的动作。
-
优点:每次只聚焦两个候选之间的差异,给模型提供统一参照基准。 -
缺点:想要从大量候选中选出最优,需要的模型调用次数远高于列表式、点式。举例:8 个候选,列表式仅 1 次调用,点式 8 次;全量无序成对对比需要 28 次调用。
自校验场景:生成器\(\pi\)与校验器\(\psi\)使用完全同一个模型。校验细节见附录 B.2。
3 实验设置
本文实验研究:动作扩展何时生效;蒸馏能否提升校验质量;动作扩展如何和跨完整轨迹的计算缩放方法组合。
任务与模型
主实验:TerminalBench‑Lite 评测集,生成器 TMAX‑9B,执行框架 Vanillux2。TMAX‑9B 基于 Qwen3.5‑9B,在合成终端任务上经过强化学习训练。模型规模拓展实验还使用 TMAX‑4B、TMAX‑27B。 生成器采样温度 0.8;最大 64 步;上下文窗口 65536 token;单步最大输出 16384 token。除非特殊说明,校验器与生成器使用同一个模型。4.1 节的顶尖校验器使用 GPT‑5.6 Sol。
评测指标
一次运行代表在单个任务上完整执行一轮,轨迹是对应的动作‑观测序列。每个任务跑 3 轮;Pass@1:3 轮运行精确任务成功率的平均值;Pass@3:该任务只要 3 轮中任意一轮成功,即记为成功,统计任务占比。对于 Best‑of‑T,Pass@1 统计最终选出输出的成功率。更多细节见附录 B.1。
基线与计算缩放方法
基础智能体:每一步只采样并执行一条动作,没有额外动作校验、没有轨迹扩展。 计算资源分配分为两个层级:
- 动作层面(单次轨迹内部)
零样本 Mid‑Harness;蒸馏版 Mid‑Harness:在 GPT‑5.6 Sol 成对对比数据集上 LoRA 微调校验器,生成器权重保持不变。 - 轨迹层面(多条完整运行之间)
-
Best‑of‑T Trajectories:运行 T 条完整轨迹,用概率锦标赛选出一条输出。 -
Sequential Refine (SR):R 轮精调;每一轮对上一轮运行做摘要,以此为条件重新启动一轮全新运行。
推理开销
-
POT(并行输出 token 数):理想并行情况下,生成器 + 校验器解码延迟的近似指标。 -
校验器总输出 token:不做并行假设,累加所有校验调用输出。 图 3 使用这两个指标;图 5 参考公开 token 报价估算成本。详见附录 B.4。
4 动作扩展在什么条件下有效
固定 TMAX‑9B 生成器,研究采样与校验如何提升轨迹成功率、对应的开销,以及校验蒸馏的效果。
4.1 候选覆盖度
顶尖能力的校验器,可以证明采样候选集合中存在可被利用的优质选项。 使用固定 TMAX‑9B 生成器 + GPT‑5.6 Sol 校验器做测试:\(N=4\)时 Pass@1 达到 64.63%,\(N=8\)时达到 68.03%。证明:生成器产出的候选动作集合,已经可以支撑显著更高的轨迹成功率。接下来探究自校验场景,最多可以挖掘出多少这种潜力。
4.2 候选集宽度与校验质量
单纯增加候选数量,无法弥补校验能力不足。 零样本列表式校验:候选数从\(N=4\)增加到\(N=8\),Pass@1 仅从 49.32% 提升到 51.02%,收益非常有限。而同样列表式机制,换成顶尖校验器就可以拿到巨大增益。这说明:能力弱的零样本校验器,很难在一次性对比全部候选时区分好坏;只增加候选数量几乎没有收益。
成对校验在评估方案中性能最优。固定生成器、\(N=8\):点式校验相比列表式仅有微弱提升,而成对校验达到 Pass@1=54.76%,Pass@3=71.43%。
4.3 校验器知识蒸馏
蒸馏实验设置
GPT‑5.6 Sol 作为教师,其校验能力与原生 TMAX‑9B 校验器之间存在明显性能鸿沟。本文测试:在推理阶段不需要调用教师大模型,通过有监督蒸馏,能否把教师的部分能力迁移过来。 数据集:从 244 个高难度 TMAX‑15k 任务采集 732 条轨迹,得到 117k 条 GPT‑5.6 Sol 成对对比样本。使用 LoRA 训练校验器复现教师的推理、打分、偏好标签。LoRA 适配器仅在校验阶段激活,动作生成器完全不改动。训练数据与优化参数见附录 B.3。
蒸馏缩小校验能力差距
\(N=8\)成对校验:蒸馏后 Pass@1 从 54.76% 提升至 57.14%;Pass@3 从 71.43% 提升至 75.51%。\(N=4\)场景同样有提升。即便是最优零样本校验方案,蒸馏依然可以继续提升轨迹成功率,同时生成器权重保持不变。第 5 节分析蒸馏改善了哪些成对偏好、哪些仍然难以处理。
4.4 动作扩展与校验的计算开销
成对校验会带来显著解码开销。图 3 对比 POT(并行输出 token)和校验器总输出 token。N从 4 扩大到 8,生成器 POT 上升,因为更多候选采样后取最长输出。成对校验会带来极高校验解码开销:\(N=8\)零样本成对校验 POT 约 26.6k;列表式、点式最多 1.3k。总输出 token:列表式 0.6k,点式 7.0k,零样本成对高达 125.7k。
校验不一定需要生成完整推理文本。校验是否必须输出详细推理链?借鉴判别式奖励模型直接预测结果的思路,测试 “仅输出 A/B 决策” 的校验器。\(N=8\)条件下,TMAX‑9B 仅输出决策的成对校验,相比带推理的版本,Pass@1 不降反升,同时 token 参考成本零样本版本降低 20.9%,蒸馏版本降低 24.1%。但 4B、27B 模型上,仅输出决策版本开销更低,但 Pass@1 低于带推理的校验器。
5 分析:校验仍然受限于什么?
基于 21 个未参与训练的 TMAX‑15K 任务的离线轨迹,\(N=8\),离线对比不同校验器的成对输出。注意:该离线指标衡量和教师校验器的一致性,不等同于动作本身正确、也不等于轨迹实际成功率。
成对一致性:校验器和教师对同一组对比,A/B/ 平局偏好完全相同的占比。 校验一致性:统计每一个状态下,两者经过成对比较选出的最优候选是否一致。
5.1 蒸馏带来的改进
蒸馏可以迁移顶尖校验器的行为。离线基准下:成对对比打分 MAE 从 2.59 下降到 1.05;成对一致性 59.01% 提升到 74.58%;校验一致性从 38.52% 提升至 57.79%。说明蒸馏后,离线选出的候选和教师输出更加吻合。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
5.2 仍然存在的校验难点
- 轨迹后期状态一致性显著下降
蒸馏在所有回合区间都带来提升;前 4 步校验一致性可达 68.13%,但 17‑32 步仅 54.07%。即便有蒸馏,长轨迹后期仍然存在大量分歧。 - 分歧主要来自命令语义理解、执行可行性预判
用 GPT‑5.6 Terra 标注校验器和教师之间的分歧,筛选出明确属于校验器失误的样本。零样本版本共 3328 例,蒸馏后下降到 1810 例;蒸馏后全部明确失误样本中,67.4% 归属于命令语义、执行可行性预判两类问题。这类问题本质就是:在不运行命令的前提下,预判命令在当前环境下会产生什么效果,是校验最大的瓶颈。
6 动作扩展的组合使用与泛化性
研究动作校验是否可以和轨迹缩放技术互补;以及该方法跨模型、执行框架、任务的泛化能力。
注意:Best‑of‑T、SR 都需要多次全新环境运行;很多真实场景很难做环境状态序列化保存。实验验证 Mid‑Harness 可以直接增强这两类方法,不需要增加环境运行次数。
6.1 和轨迹缩放方法组合
实验结果(表 2):Mid‑Harness 可以同时增强并行的 Best‑of‑T,也增强串行的 SR。
-
TMAX‑9B 基线 Best‑of‑T (T=3):Pass@1=55.10%;如果每一条轨迹内部启用零样本 Mid‑Harness,提升至 61.22%;蒸馏 Mid‑Harness 进一步到 66.33%。 -
基线 SR (R=1):Pass@1=55.10%;蒸馏 Mid‑Harness 用于原始轨迹和精调轨迹,Pass@1 提升至 60.20%。
动作扩展 + 轨迹扩展,实现更优的成功率‑开销权衡。
-
SR token 开销相对低,但性能很快进入平台期,R=1/2/3,Pass@1 大致在 55‑56% 区间。 -
\(N=8\)蒸馏 Mid‑Harness,达到和 Best‑of‑T (T=5) 同等的 57.14% Pass@1,但参考 token 成本仅后者三分之一。 -
蒸馏 Mid‑Harness 搭配 SR (R=1) 达到 60.20%;搭配 Best‑of‑T (T=3) 达到 66.33%;两者均超过 Best‑of‑T (T=7) 的 59.18%,同时预估成本更低。 使用仅输出决策的校验器,可以把组合方案整体参考成本再降低 22‑24%。
6.2 跨模型、评测集、执行框架的迁移
- 模型规模 4B‑27B 均有收益
TMAX‑4B:零样本 Mid‑Harness Pass@1 从 38.78%→41.50%;蒸馏版到 43.88%。TMAX‑27B:71.09%→73.13%→76.19%。每个规模下蒸馏校验器都基于对应规模的模型主干初始化,成对校验机制保持不变。 - 在难度更高基准上同样有效
Terminal‑Bench 2.1:TMAX‑9B 基线 Pass@1 仅 21.72%;零样本 Mid‑Harness 提升至 27.34%。FeatureBench‑Mini 任务难度极高:TMAX‑9B 基线 Pass@1 仅 1.45%;零样本 5.80%,蒸馏 7.25%。TMAX‑27B 基线 17.39%,蒸馏提升到 23.19%。在 SWE‑bench‑Verified 上也观察到正向增益。 - 兼容其他模型与其他执行框架
零样本 Mid‑Harness 对 Nemotron3.5 Lightning、Nemotron3 Ultra 均有提升;对 Qwen3.5‑9B 搭配 Terminus‑2 执行框架同样有效。全部 7 组配置下,零样本 Mid‑Harness 均提升 Pass@3,Pass@1 持平或提升。
7 相关工作
- 终端智能体:模型与执行框架
大量工作优化智能体接口、上下文管理、执行框架本身。Mid‑Harness 则固定模型与执行框架,专门研究动作层面测试时计算缩放。 - 测试时缩放、过程奖励模型
推理任务中广泛使用聚合、校验、搜索实现测试时计算缩放;过程奖励模型评估中间步骤,也有生成式校验工作;\(V_1\)使用成对对比锦标赛做数学、代码任务。但大部分面向纯推理任务;本文面向智能体,每一步动作会真实改变环境状态。 - 智能体的测试时缩放
Best‑of‑T、SR 等是对完整轨迹做并行或串行缩放;也有工作在 Terminal‑Bench 中每一步做候选校验;SWE 任务中也有结合打分 critic 与轨迹选择。本文则系统研究在终端任务中,以生成器自身作为校验器,对比不同校验机制的效果。
8 结论
本文在固定动作生成器与执行框架的前提下,研究终端智能体的动作扩展。同一个生成器已经产出可以提升轨迹成功率的备选动作,但如果校验能力弱,单纯增加采样候选几乎没有收益。在被评估的校验方案中,成对对比表现最优;对顶尖教师校验器输出做蒸馏,在不改动生成器前提下继续提升成功率。该增益可以跨多种智能体设置复现;动作扩展与轨迹扩展组合,可以比单纯增加轨迹数量实现更高成功率、更低预估 token 开销。本文证明:动作扩展是测试时计算缩放中一条重要、可与轨迹扩展互补的新方向。
局限性与未来工作
蒸馏后的校验器与顶尖教师之间仍存在不小性能差距,未来可以用强化学习训练校验器;本评测缺少动作层面金标准标签,很难直接衡量校验正确率与候选集的理论上限。未来方向:引入世界模型预判动作执行效果;同时联合训练生成器和校验器;自适应校验(不同步骤动态调整候选数量与对比开销);把该范式拓展到计算机使用智能体、机器人智能体。
AI 使用声明
本研究使用生成式 AI 工具构建合成数据集、实现代码、设计方法论、辅助定性数据分析、辅助翻译。没有用 AI 提出 / 打磨研究假设、清洗数据集、解读实验结果、完成证明推导。AI 辅助生成的图表与论文润色全部经过人工审核;AI 生成代码由两位作者检查测试,最终内容由作者负责。
伦理声明
全部实验运行在隔离评测沙盒。本文研究的动作可靠性仅针对任务完成效果,不等于命令的安全性、安全性保障。终端智能体能力提升可以服务合法自动化,但也有可能被用于有害行为。真实部署必须配套权限限制、环境隔离、高危动作人工审核;动作校验只能作为安全补充手段,不能替代安全防护。
可复现说明
附录 B 记录校验机制、prompt 模板、蒸馏数据与训练配置;附录 B.1 记录评测任务、基线、超时设置;附录 B.4 记录推理开销计算;附录 D 记录离线分析与分歧分类。
附录
A 局限性与未来工作
-
校验器训练:蒸馏后和 GPT‑5.6 Sol 仍然存在性能缺口,主要瓶颈在于命令语义、执行可行性预判,长轨迹后期校验一致性下降。未来可以引入世界模型预测动作带来的环境变化;参考\(V_1\)思路用强化学习联合训练生成器‑校验器。 -
评测难题:缺少动作金标准标签;执行不同动作会改变后续环境状态,因此无法简单在固定轨迹数据集上离线评估校验器,往往需要真实重启环境。环境快照、分支仿真可以支持树搜索、束搜索,但依赖环境克隆技术。 -
推理资源分配:本文固定单候选内部推理的计算量;未来可以对比 “动作扩展” 和 “单条候选投入更多思考” 两条路径的取舍;可以做自适应校验,关键步骤才启用大量候选与校验;仅输出决策可以降低开销,但性能随模型规模会有波动。 -
拓展方向:借鉴蒸馏、自蒸馏、强化学习、工具增强校验;结合记忆、上下文压缩;把这套范式迁移到计算机操作智能体、机器人智能体。
B 实验实现细节
B.1 评测与基线流程
-
TerminalBench‑Lite:原始 100 个任务,两个任务因沙盒故障被剔除,最终 98 任务。 -
Terminal‑Bench 2.1:全部 89 个任务。 -
SWE‑bench‑Verified Mini:50 任务子集。 -
FeatureBench‑Mini:23 个 CPU 任务,排除 GPU 任务。 -
指标计算公式:每个任务跑 3 轮。
\(z_{ij}\):第i任务第j轮是否精确成功;失败全部计入分母,部分奖励不计入成功。
-
Best‑of‑T:T条完整轨迹,用锦标赛选出一条输出。Mid‑Harness 会在每一条待选轨迹的内部每一步都启用动作校验。 -
SR:对原始轨迹做 5 字段摘要,在全新环境基于摘要重新运行;Mid‑Harness 同时用于原始轨迹与精调轨迹。
B.2 校验机制与超参
-
列表式:一次性输入全部候选,输出 JSON 选择最优。 -
点式:每次输入单条候选,输出 0‑10 分数、预测下一状态、理由。 -
成对校验: -
\(N=8\)时采用环 + 枢轴锦标赛:候选循环两两对比,选出前 K 个枢轴,其余候选和枢轴做对比;用带分数差权重的胜率做聚合排序。 -
仅输出决策(Decision‑only):只输出 A/B,不输出完整推理链。 -
无效输出处理:非法模型响应直接丢弃,不记为平局;全部对比失效时回退到第一条有效候选。
B.3 校验器蒸馏训练设置
训练集 117k 成对样本;验证集 10k+,完全不参与训练。LoRA rank=64,alpha=128,dropout 0.05;学习率\(10^{-4}\);2 轮 epoch;batch size=8;4 张 H200 GPU 训练。适配器作用于注意力层、MLP、状态空间模块。 仅输出决策的蒸馏数据集去掉推理文本,只保留 A/B 标签,剔除平局样本。
B.4 推理开销统计
-
POT 并行输出 token:每个并行阶段取该阶段最大输出长度,累加。成对校验的环阶段、枢轴阶段是串行,两个阶段的最大值相加。 -
总校验输出 token:直接累加所有校验调用输出,不做并行假设。 -
参考计价:Qwen3.5‑9B 参考价格:输入 0.08 美元 / 百万 token,输出 0.13 美元 / 百万 token。4B、27B 按比例缩放。
B.5 评测成本说明
终端智能体每一轮运行需要全新 Docker 沙盒,大量模型调用,部分任务单轮可达数小时。Mid‑Harness 每一步还要额外采样候选、调用校验器。本实验每个配置每个任务运行 3 次;受计算资源限制,无法做更多重复。
B.6 完整 Prompt 模板
附录提供列表式、点式、成对校验完整英文 Prompt,输出格式强制要求 JSON,内置打分规则、失败惩罚、禁止过早完成任务、避免重复无效操作等约束。
C 补充实验结果
- 数值结果表
记录不同N、不同校验方案、蒸馏 / 零样本、仅输出决策下的 Pass@1、Pass@3。 -
顶尖 GPT‑5.6 Sol:\(N=8\),Pass@1=68.03%; -
TMAX‑9B 蒸馏成对\(N=8\):Pass@1=57.14%。 - 仅输出决策的开销‑性能权衡
TMAX‑9B 上\(N=8\)蒸馏仅输出决策,Pass@1 提升,token 成本下降 24.1%;但 4B、27B 模型上会出现性能下降。 - 更多校验消融
增加校验调用次数、多轮采样输出、评分标尺放大,并不会稳定提升性能,很多时候开销翻倍但收益很小。 - 置信区间
bootstrap 重采样统计 Mid‑Harness 相对基线的提升;95% 置信区间。部分配置置信区间跨过 0,说明样本内有正向提升,但统计不确定性仍存在;蒸馏 9B、27B 的置信区间完全大于 0。 - 按任务分组分析
增益在软件工程、调试、机器学习任务更明显;困难任务上增益普遍更大;长交互轨迹也普遍收益,但增益不随任务难度单调递增,部分领域甚至出现小幅负向偏移。
D 校验器离线分析
D.1 离线一致性指标计算方式
-
分数 MAE:对比教师与学生校验器对每一条候选给出的打分,求绝对误差均值。 -
成对一致性:同一条 A/B 对比,偏好标签完全一致的样本占比。 -
校验一致性:同一个状态,经过全部成对比较后选出的最优候选是否和教师选出的一致。 -
按回合分段:把轨迹按步数分段,观察随轨迹推进一致性如何衰减。
D.2 校验失败分类
人工(GPT‑5.6 Terra)标注校验失误样本,分为:
- 候选语义
误解命令、代码的实际行为; - 执行可行性
没有预判命令在当前环境下运行会出错、自毁、资源冲突; -
其余类别:观测证据利用错误、动作阶段时机错误、冗余重复操作、需求理解错误、过早标记任务完成。 蒸馏后,前两类占全部明确失误的 67.4%。
D.3 定性样例
提供两个真实轨迹片段:
-
✅ 成功案例:React+TypeScript 任务。8 个候选,成对校验选出唯一正确配置修改,修复 TS6137 编译报错;全部测试用例通过。校验器虽然对配置字段的理解有一处小错误,但最终选出的动作正确。 -
❌ 校验失败案例:别名规范化 Python 任务。校验器错误优先选择重写代码的候选,而不是先做调试诊断;改写引入新逻辑 bug,最终大部分测试通过,但核心测试失败。