


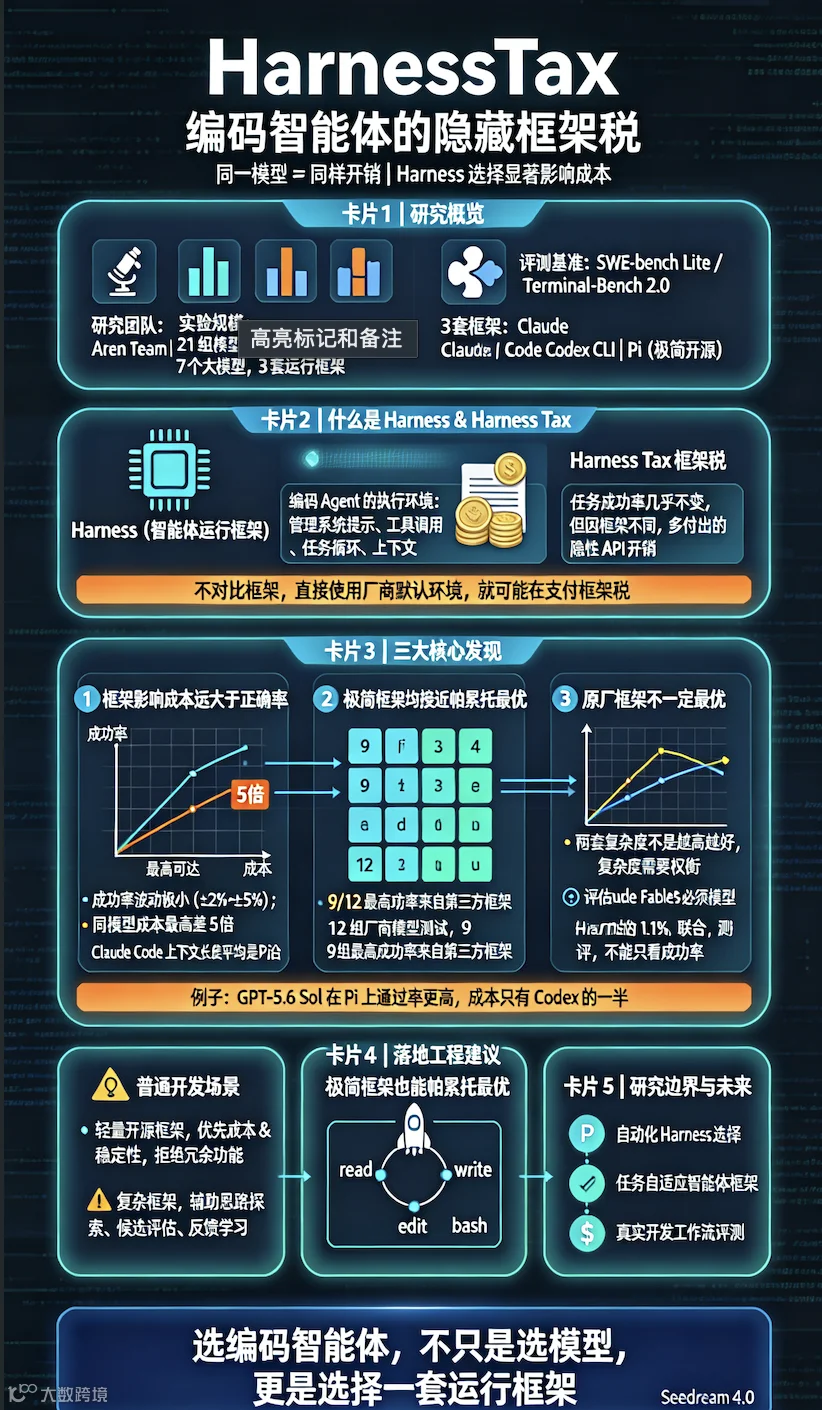
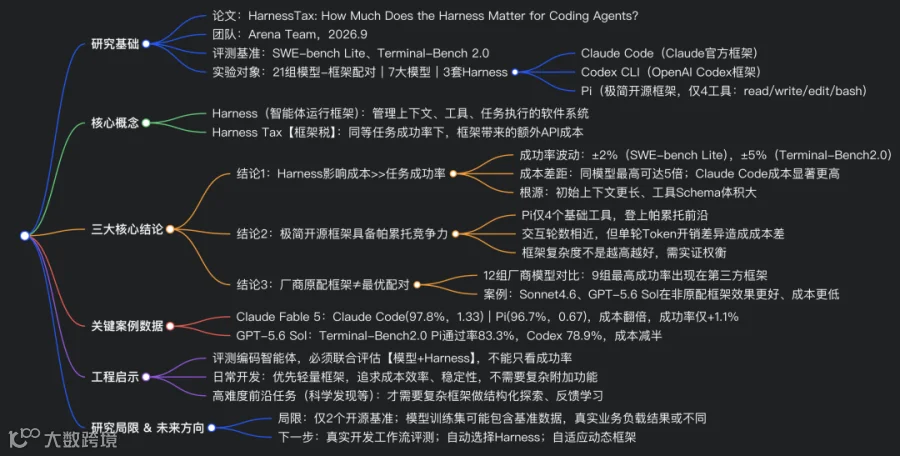
编者摘要:Arena 团队发布的 HarnessTax 研究,核心提出框架税(Harness Tax)概念:编码智能体的运行框架(harness)对任务成功率影响很小,但极大改变调用成本。 实验在 SWE-bench Lite、Terminal-Bench 2.0 上测试 21 组模型 - 框架组合,包含 Claude Code、Codex CLI、Pi 三套框架,7 个大模型。 三大发现:
-
同模型在相近成功率下,成本最高差 5 倍。Claude Code 成本显著高于 Pi、Codex CLI,根源是初始上下文更长、系统提示词与工具 Schema 体积大,从第一轮调用就产生额外开销;成功率波动一般仅 ±2%~±5%。 -
极简开源框架 Pi 仅提供 4 个基础工具,就能站上帕累托最优前沿,证明复杂框架不一定更好。交互轮数接近的情况下,单轮 token 开销差异是成本差距主因。 -
厂商 “原配框架” 不一定最优。12 组厂商模型对比中 9 组,最高成功率出现在第三方框架。例如 Sonnet、GPT-5.6 Sol 在非官方框架上表现更好、成本更低。
研究提示:编码智能体评测不能只看成功率,模型 + harness 必须联合评估成本与效果。日常开发优先轻量化框架;只有高难度前沿任务,才需要复杂框架做结构化探索。研究结论局限于两个公开基准,真实业务场景结果可能变化。
10 个关键问题问与答
-
Q:HarnessTax 论文核心要解决什么问题? A:大家做编码智能体评估时,只关注大模型本身,忽略 Harness 运行框架带来的巨大成本差异;论文量化了框架对编码 Agent 成功率与开销的影响,提出 “框架税” 概念。 -
Q:什么是编码智能体的 Harness(运行框架)? A:一套软件系统,负责管理模型的系统提示词、工具 Schema、上下文窗口、多轮任务循环、命令执行,是连接大模型和开发环境的载体。编码 Agent = 大模型 + Harness。 -
Q:什么叫 Harness Tax 框架税? A:同一个模型,在任务成功率基本持平的情况下,更换 Harness 带来的额外 API 调用成本。用户直接使用厂商默认框架,往往会默默支付这笔隐性成本。 -
Q:Harness 主要影响编码 Agent 的成功率还是成本? A:成本影响远大于成功率。测试中框架带来的成功率波动仅 ±2%~±5%,但同模型的调用成本最高可相差 5 倍。 -
Q:为什么 Claude Code 成本远高于 Pi? A:Claude Code 的初始系统提示词更长、工具描述 Schema 体积更大,初始上下文平均是 Pi 的 10 倍,每轮调用消耗更多 token;哪怕交互轮次差不多,开销显著更高。 -
Q:Pi 框架这么简单,为什么性能还很强? A:Pi 只封装 read/write/edit/bash 四个基础工具,没有多余冗余 prompt;在基准上到达帕累托前沿,证明复杂框架不等于更强,基础工具足以完成大部分编码任务。 -
Q:厂商针对自家模型优化 Harness,为什么原配框架不一定最优? A:厂商优化是面向通用场景,不代表所有负载下最优。实验 12 组厂商模型对比,9 组的最高成功率出现在第三方框架;模型能力具备通用性,可以跨框架迁移。 -
Q:举一个原厂不如第三方框架的典型案例? A:GPT-5.6 Sol,在 Terminal-Bench2.0 上,Pi 框架通过率 83.3%,原配 Codex CLI 仅 78.9%,同时 Pi 的成本只有 Codex 的一半。 -
Q:这篇研究给企业落地编码智能体最重要的启示是什么? A:编码 Agent 评估不能单独看模型,模型和 Harness 必须捆绑评估成功率与成本;日常开发不必盲目选用厂商厚重官方框架,可以测试轻量开源框架降本。 -
Q:这份研究结论有没有适用限制? A:结论仅基于 SWE-bench Lite 和 Terminal-Bench 2.0 两套开源基准,模型训练数据可能包含基准题目;迁移到真实业务代码库、复杂开发场景,结论可能发生变化。
研究 | Arena Team 发布于 2026 年 9 月 16 日 最后更新:2026 年 9 月 18 日
大语言模型正在改变我们构建软件、求解计算问题的方式。编码智能体借助运行框架(harness)调用模型能力:这是一套管理模型工具、上下文与任务执行的软件系统。模型是编码智能体的核心智能源,但运行框架越来越被认为决定了这份智能能否被高效利用。因此,选择编码智能体,本质上是同时选定模型 + 运行框架,哪怕大家目光只聚焦在模型本身。
已有数百万人在使用编码智能体,但运行框架的选择带来的影响,长期没有被清晰量化。换一套运行框架,同一个模型能不能解决更多任务,或是降低调用成本?
本研究在 SWE-bench Lite、Terminal-Bench 2.0 两个开源基准上,评估21 组模型 - 运行框架组合,覆盖 7 个模型、3 套运行框架:Claude Code、Codex CLI、Pi。研究得到三个反直觉结论:
-
运行框架对任务成功率影响很小,但会显著改变调用成本;同模型在相近成功率下,成本最高可差 5 倍。 -
极简运行框架也能具备很强竞争力。开源轻量框架 Pi,在成本与任务成功率上均可对标主流方案。 -
模型在非官方配套框架上效果可能更好。也就是说,Claude 模型未必一定要跑在 Claude Code 上 🤔
下文逐一解读结论,研究的性能追踪日志将对外开源。
实验设置
运行框架:对成本的影响远大于正确率
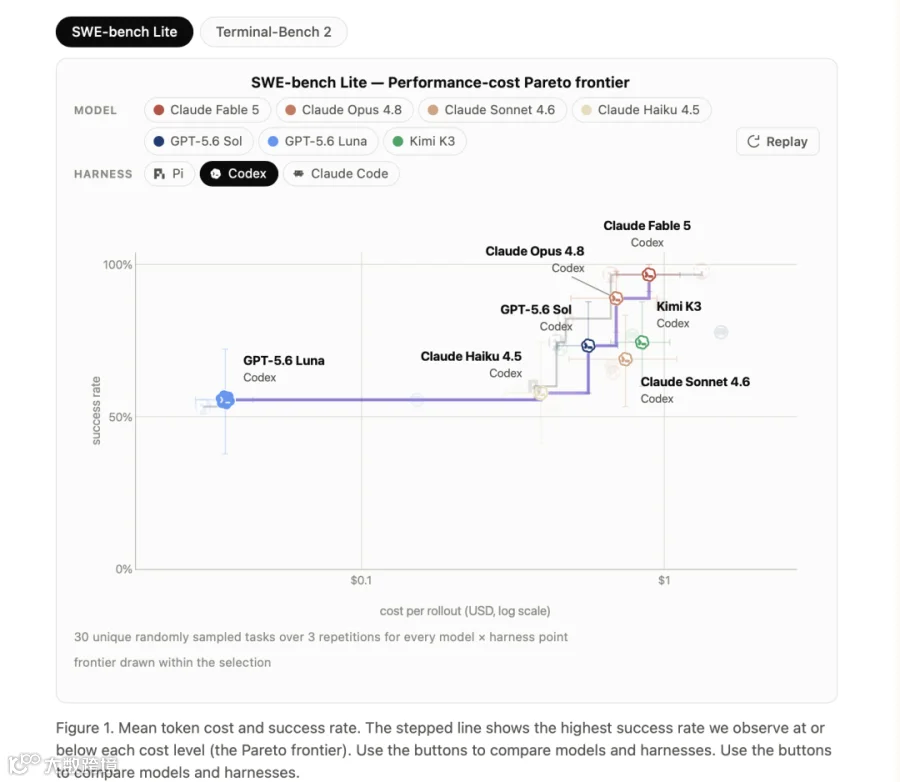
同一个模型,常常能拿到差不多的任务成功率,但成本差异巨大。GPT-5.6 Luna 在两套基准上成本最低;Claude Fable 5 在 SWE-bench Lite 上取得最高成功率。开源权重模型 Kimi K3 在 SWE-bench Lite 上非常接近帕累托前沿,Terminal-Bench 2.0 上略低于帕累托前沿。但这些模型,在不同运行框架之间的任务表现差距并不大。
以 Claude Fable 5 为例:在 Claude Code 中尝试通过率 97.8%,Codex CLI 为 96.7%,Pi 也是 96.7%;但 Claude Code 的调用成本几乎是 Pi 的两倍(1.33 美元 vs 0.67 美元)。
Fable 5 在 Claude Code 仅小幅提升成功率(+1.1%),成本却翻倍。成本差距不是个案:在共用模型的对比中,
-
SWE-bench Lite:Claude Code 成本约为 Pi 的 2.0 倍,Codex CLI 的 1.6 倍; -
Terminal-Bench 2.0:Claude Code 成本约为 Pi 的 1.5 倍; 以上均采用成本比率几何均值计算。
而运行框架带来的成功率波动范围很小:SWE-bench Lite 在 ±2% 以内;Terminal-Bench 2.0 大约 ±5%。
仅仅因为换了运行框架,就要为几乎一样的任务质量多花钱 —— 这就是框架税(Harness Tax)💰。如果你直接使用编码智能体默认框架、不做横向对比,很可能就在支付这笔隐性框架税。 因此模型评测,必须在相同模型下,跨主流运行框架同时对比成本 + 任务成功率两个指标。
极简运行框架也具备竞争力
Pi 仅提供 4 个工具:读文件、写文件、编辑文件、bash 命令,就在两套基准上站上帕累托前沿。 为理解框架设计如何影响开销,研究统计了所有成功任务的成本、交互轮次、初始上下文。

智能体交互轮次相近,单次成本却可以相差巨大。 SWE-bench Lite 上 Fable5 实验:Pi 平均每任务 15.4 轮,Claude Code 15.3 轮。但 Claude Code 成本翻倍,仅换来 1.1% 的成功率提升。这代表单轮调用成本更高(不同框架对 “一轮” 的定义本身也存在差异)。
框架税从第一次模型调用就开始累积。7 个模型整体统计,Claude Code 的初始上下文长度平均是 Pi 的 10 倍以上,包含更长系统提示词、更大的工具描述 schema。额外上下文直接推高开销;当然总花费同时受缓存、生成 token、后续多轮调用共同影响。

Pi 与 Codex CLI 的良好表现证明:基于现有 SOTA 模型,开源运行框架领域还有大量研究空间。研究者不需要拿到闭源厂商框架,也不需要和模型联合训练,就能研究顶尖编码智能体框架。更复杂的框架特性,仍可能在其他模型、业务负载、交互场景带来收益。 框架复杂度,应当被视作一项需要实证权衡的取舍,而不是越复杂越好。
模型在厂商自有框架之外,也能打出优秀表现
厂商针对自家编码环境做优化,不代表 “原配” 就是最优配对。 OpenAI 就介绍过,GPT-5-Codex 针对 Codex 环境下软件工程任务做了专项优化。但在 6 个 Anthropic、OpenAI 模型 + 两套基准,一共 12 组对比中:有 9 组,最高成功率出现在非厂商原配框架上。

该结论不只适用于 Opus 与 Claude Code: SWE-bench Lite 上,Sonnet 4.6 在 Codex CLI 中通过率 68.9%,而 Claude Code 为 66.7%,两者成本接近。 GPT-5.6 Sol 脱离原配框架同样表现亮眼:Terminal-Bench 2.0 上,Pi 中通过率 83.3%,Codex CLI 仅 78.9%,且 Pi 成本只有 Codex CLI 的一半(0.42 美元 vs 0.76 美元)。
实验证明,模型能力具备通用性,可以迁移到其他运行框架。厂商确实会针对自家环境微调模型,但同一厂商的模型 + 框架组合,并不天然是最优组合。工程上真正要回答的问题是:针对你的模型与业务负载,哪套框架能平衡成本与任务成功率。
结语
实验结果显示:同一模型可以在相近任务成功率下,出现巨大成本差异。在本次测试基准中,轻量化开源框架完全具备竞争力,模型脱离原配框架也能取得不错效果。如果只看任务成功率,这笔 “框架税” 很容易被忽略。
多数场景下 Pi、Codex CLI 能以更低成本拿到和 Claude Code 接近的成功率。本结论局限于这两个开源基准,模型在训练阶段可能见过相关数据;在其他基准、真实业务负载上,结果可能不同。
过往不少研究已经提出,模型选型与系统配置必须联合评估;而编码智能体用户基数大、场景广,运行框架选型问题更为紧迫。下一步研究方向,是在真实开发流程中评测框架,并实现框架自动选择 —— 真实场景需求持续变化、开发者持续反馈、任务跨多会话执行。
更宏观来看,框架选型取决于编码智能体的定位。日常开发场景,编码智能体本质是模型能力的接口:管理上下文、调用工具、执行任务。随着模型能力变强,编码智能体可能不再需要现在这么厚重的脚手架。通用编码智能体,应优先保证成本效率与稳定性;很多任务并不需要花哨附加功能。
而在模型能力边界的高难度任务(如科学发现),编码智能体仍受益于强框架:用来结构化引导思路、评估候选方案、从反馈中学习。运行框架研究,可以看作释放模型潜能、推进下一阶段智能能力的路径。但用户不应该手动完成这些复杂配置选择。我们期待新一代自适应运行框架:随任务动态调整,同时保持通用性。
引用
如果 HarnessTax 对你的研究或工作有帮助,请按如下格式引用: Pan, M. Z., Yang, S., Arabzadeh, N., Chiang, W.-L., Stoica, I., & Zaharia, M. (2026). HarnessTax: How Much Does Harness Matter for Coding Agents? https://harnesstax.github.io/
致谢
感谢亚马逊 AI 奖学金提供 AWS 算力额度,Arena Intelligence 为本实验性能采集提供 API 授权,Laude 提供 Anthropic API 额度。感谢 Michael Chang、Tyler Griggs 为研究提供 AI 订阅支持,Mert Cemri 为本文稿提供宝贵意见。
本实验室研究由埃森哲、AMD、Anyscale、博通、谷歌、IBM、英特尔、意大利联合圣保罗银行、Lambda、Mibura、三星 SDS、SAP 捐赠支持。感谢所有对开放研究的资助。
参考文献(略)
术语对照
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|