


数据质量决定模型输出效果,是AI行业公认的底层规律:数据集质量,直接决定模型所能达到的能力上限。无论是用于模型训练的训练数据集,还是用于效果评估的评测数据集,一旦出现标注错误、场景缺失、合规漏洞,后续无论模型如何调优,都难以产出可靠的AI能力。当前产业内大量团队把注意力集中在模型效果,却忽略数据集本身的质量评估,由此带来一系列落地难题。
◉ 标注质量不可控:样本标注错误、标签不一致、内容冗余,噪声数据大量存在,造成模型效果偏差。
◉ 场景覆盖缺失:通用数据集缺少行业边界案例、异常样本,行业数据集样本量不足、场景同质化。
◉ 偏见与事实风险:数据集隐含偏见、事实错误,训练后带来模型输出偏差,引发业务风险。
◉ 合规风险隐患:版权不清、未脱敏个人信息、来源不可追溯,带来合规与法律风险国家数据局。
◉ 测评数据集失效:测评集被训练污染,出现“考卷泄露”,测评结果失真,无法客观衡量模型真实水平。
◉ 缺少统一评估标尺:数据集好坏多依靠人工主观判断,缺少标准化指标体系,质量难以量化。

中国信通院可信 AI ADAQ 人工智能数据集质量评估体系覆盖训练数据集、评测数据集两大对象,依托「一套评估方法 + 一个评估平台 + N 项定制服务」的1+1+N实施框架,提供标准化质量测评 + 合规审计服务,从质量管理、基础质量、标注质量、场景完备性、偏见风险、合规性多维度完成全链路评估,适配文本 / 图像 / 音频 / 视频 / 多模态数据,覆盖预训练、微调、对齐、评测等模型全生命周期阶段。
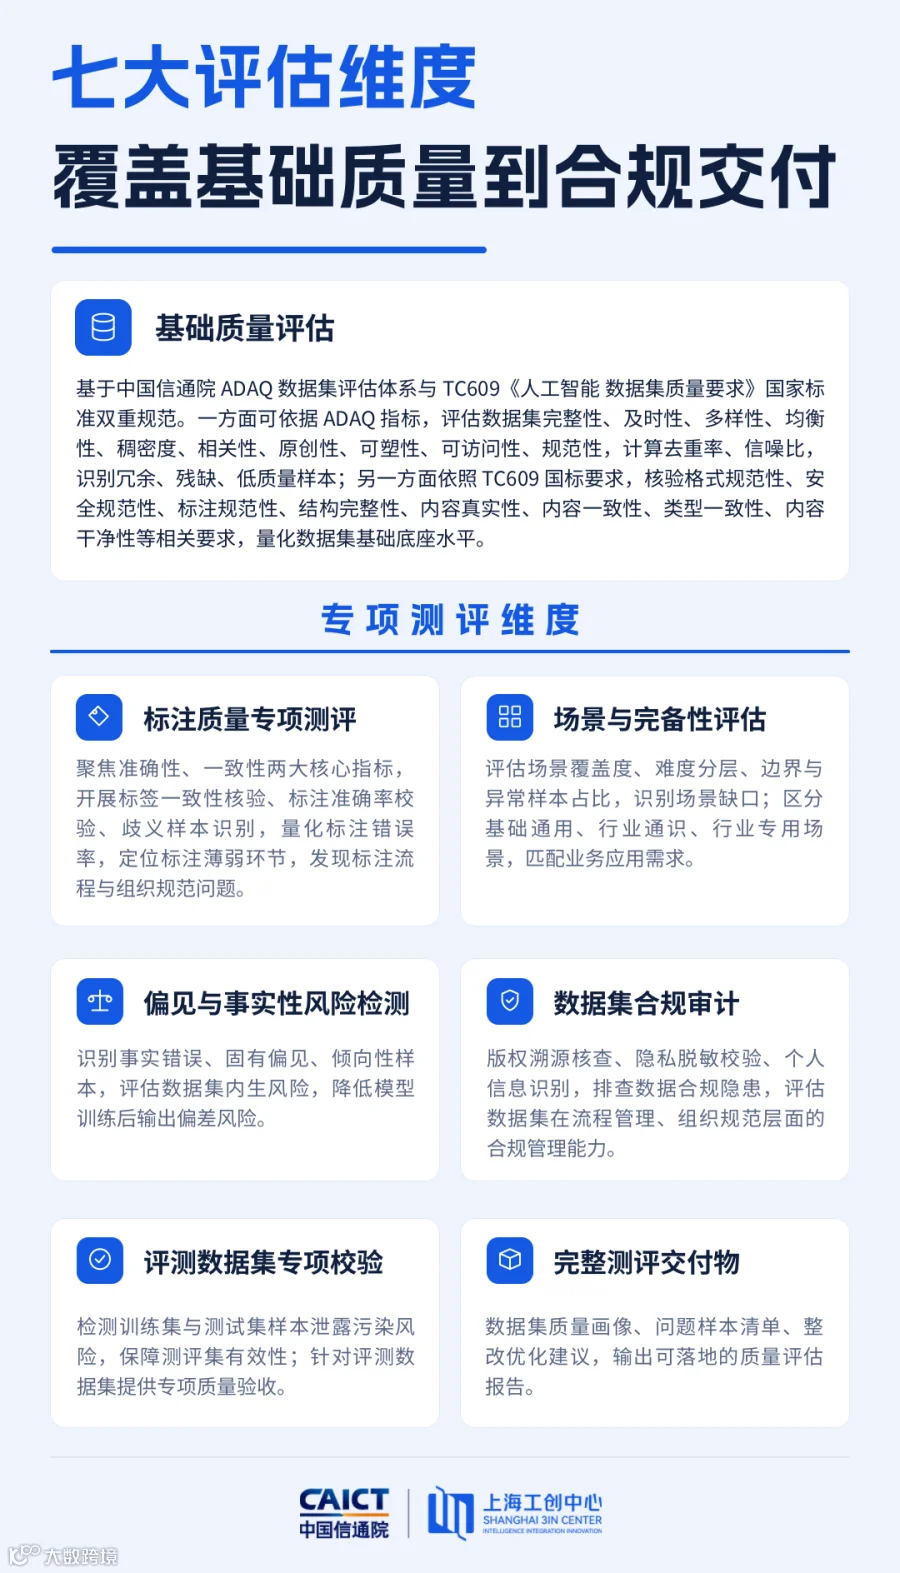

大模型时代,数据集不只是燃料,更是衡量AI能力的“考卷”。只有把数据集测评放在AI研发的前置位置,才能从源头筑牢AI可信根基。
[ 相关业务联系人 ]
周老师 13402141870
肖老师 15828811939
张老师 15026741992
· END ·
