发表期刊:Nature
研究领域:计算生物学、蛋白质组学、AI药物发现
ML/DL方法:Neural ODE、多任务学习、连续时间动力学、药物分子指纹、SWAG、SHAP
文章创新:
构建包含超过3,800万条蛋白丰度测量的时间分辨扰动蛋白质组资源;
通过Neural ODE联合学习潜在表征与药物条件动力学;
将动态表征用于药效、药物协同、耐药蛋白、患者预后和类器官筛药;
以细胞、PDX、临床活检和患者来源类器官构成多层验证链路。
1
研究背景
虚拟细胞模型旨在通过计算方法模拟细胞对外界干预的响应,为药物筛选提供预测依据,并降低大规模湿实验的成本。现有研究大多依赖单一时间点的转录组数据或扰动终点测量。尽管数据规模持续扩大,这类数据仍难以刻画细胞状态随时间演化的过程。此外,mRNA位于基因表达向功能表型传递的中间环节,其变化与实际承担细胞功能的蛋白质并非完全对应。因此,如何在扩大建模规模的同时准确描述细胞的动态功能变化,仍是虚拟细胞研究需要解决的关键问题。
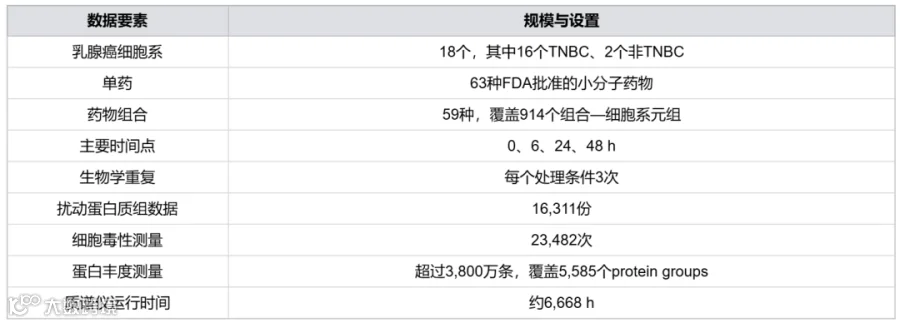
针对这一缺口,文章将时间分辨扰动蛋白质组作为虚拟细胞建模的基础。研究团队对18个乳腺癌细胞系实施63种单药和59种药物组合扰动,获得16,311份蛋白质组数据、23,482次细胞毒性测量以及超过3,800万条蛋白丰度记录,并据此开发ProteinTalks。该模型利用Neural ODE刻画药物扰动后0—48 h的蛋白组变化,再将预测得到的动态轨迹与药物结构特征结合,用于药效预测、药物组合筛选、耐药相关蛋白识别、患者预后分层及类器官候选药物排序。
2
为什么虚拟细胞需要动态蛋白质组?
Geneformer、scFoundation和UCE等基础模型主要从大规模转录组中学习细胞表征;STATE、STACK、x-Cell 和CellOT等方法进一步利用扰动转录组预测干预后的细胞状态。PRESCIENT、TrajectoryNet和DeepRUOT等轨迹模型则尝试描述细胞状态随时间的变化。这些工作推动了细胞状态建模,但多数模型仍侧重静态嵌入、扰动终点,或在预先定义的潜空间中完成轨迹插值。
ProteinTalks试图补足两类信息。
第一,蛋白质是细胞功能的主要执行者,与药效、耐药和表型变化更直接相关。
第二,连续时间数据能够约束模型学习如何变化,而不仅是变化前后有什么不同。
因此,论文的关键并非简单地把输入模态从转录组换成蛋白质组,而是让实验时间序列与连续动力学模型相互匹配:真实轨迹为Neural ODE提供监督,扰动条件下的动力学又反过来塑造潜在表征。这一设计决定了ProteinTalks的定位。它并非完整复刻细胞全部过程,而是围绕药物扰动—动态蛋白组—治疗表型构建一个可直接执行药物发现任务的虚拟细胞原型。
3
核心技术
PTDS:超过3,800万条测量构成动态学习基础
论文首先建立ProteinTalks dataset(PTDS)。主数据集聚焦乳腺癌,尤其是三阴性乳腺癌,并以高通量数据非依赖采集质谱测量不同药物和时间条件下的蛋白丰度。
为了确定时间点,作者还构建了更密集的mtPTDS:在3个TNBC细胞系中,对55种单药和57种组合采集 0、2、4、6、8、10、12、24、36、48、60h共11个时间点,得到2,528个蛋白质组样本。UMAP显示扰动后的状态大致形成早期、中期和晚期三个阶段,作者据此在主数据集中采用0、6、24、48h,分别覆盖基线、早期、中期和晚期反应。
动态数据本身也揭示了药物作用机制。作者以PertScore汇总蛋白在不同药物、细胞系和时间点中的重复性变化,识别出823个扰动相关蛋白(PertScore ≥ 10,FDR < 0.05)。作用机制相关通路在6h已出现变化,而细胞死亡通路主要在48h富集,说明时间维度能够区分早期药理作用与后期表型结果。
ProteinTalks:从基线蛋白组推演药物响应
ProteinTalks由两个相互衔接的模块组成。第一个模块预测扰动后的动态蛋白组,第二个模块将蛋白组轨迹转化为药物疗效或组合协同概率。其数据流可以概括为:
基线蛋白组与药物靶点 → 连续时间潜在轨迹 → 6、24、48h蛋白组 → 药物结构融合 → 药效或协同预测

动态蛋白组模块:用Neural ODE表达连续变化
模型输入包括5,585个蛋白的基线丰度 和药物靶点描述D。二者在每个蛋白位置拼接,经共享线性层和kernel size为1的一维卷积映射到潜在空间。该点卷积共享参数,不把蛋白排列顺序错误地视为局部空间关系,同时使参数量基本不随蛋白数量增加。
潜在状态满足如下常微分方程:
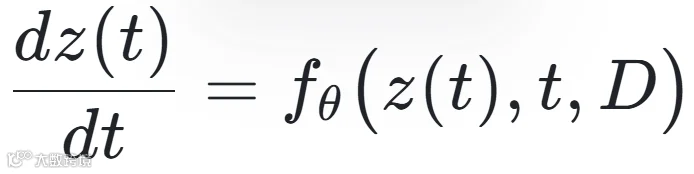
其中z(t)表示时刻t的潜在蛋白组状态,D表示扰动条件, 由神经网络参数化。模型使用四阶Runge—Kutta求解6、24、48 h的潜在状态,再经解码器还原为未来蛋白丰度。动态分支采用均方误差:
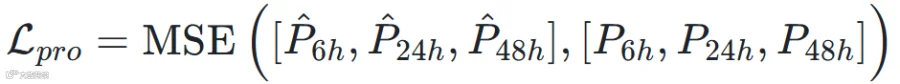
与先固定潜空间、再在其中拟合轨迹的方法不同,ProteinTalks在训练中同时学习潜在表征与向量场。能够被扰动动力学连续推进,成为这种表征的组成条件。
药物表型模块:融合轨迹与分子特征
第二个模块把基线蛋白组和预测的6、24、48 h蛋白组压缩为32维表示。每种药物则由935维特征描述,其中包括881维drug molecular fingerprints(DMF)和54维 drug physicochemical properties(DPP)。单药任务中复制同一药物特征;双药任务中按预先规定的anchor—library顺序拼接两种药物。
融合后的蛋白质组与药物表示经多层感知机和sigmoid输出药物有效性或协同概率,使用二元交叉熵损失 。最终目标为:

固定权重意味着训练目标更偏向药物表型预测:动态蛋白组重建占20%,疗效或协同分类占80%。因此,蛋白组轨迹既是模型输出,也是约束药效表征的中间任务。
4
实验结果
实验一:跨细胞与跨药物预测
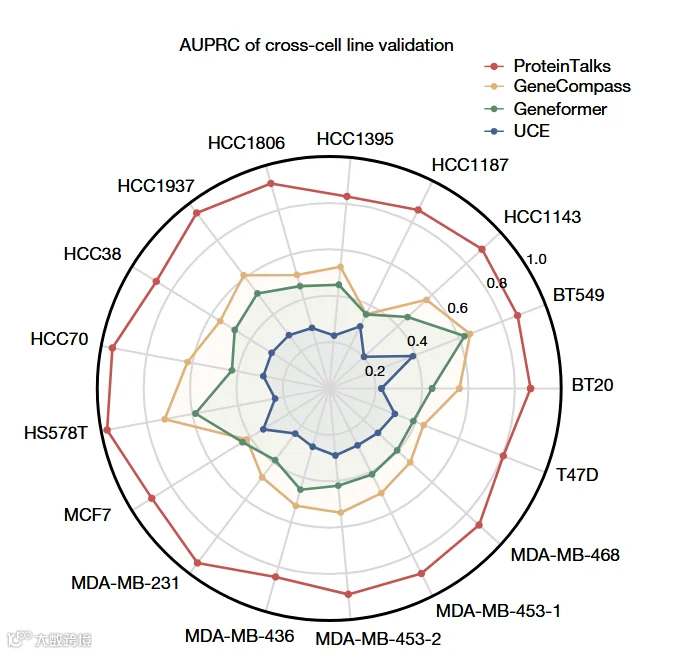
在跨细胞系评估中,ProteinTalks整体优于论文选取的转录组基础模型和传统机器学习方法;在包含81种未训练药物的PTNC数据集上,无需微调即可取得0.94的AUPRC。不过,leave-one-drug-out的AUPRC降至0.57,说明跨药物机制外推仍具挑战。PTNC使用的细胞系已在训练数据中出现,因此主要验证的是新药物、已见细胞背景下的泛化能力。
实验二:预测药物组合协同作用
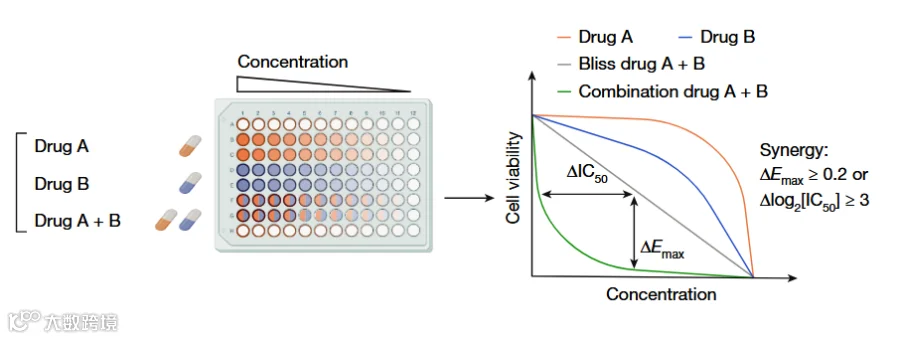
作者将63种药物构成的1,953个双药组合与18个细胞系配对,共生成35,154个候选组合。ProteinTalks对协同组合给出的预测分数显著高于非协同组合。
研究团队从高排名结果中选择4个组合进行实验验证,均达到预设协同标准, 为0.28—0.74。这表明模型可用于缩小实验筛选范围,但由于只验证了少量高排名候选,尚不能据此估计全部预测结果的假阳性率。
实验三:动态归因识别耐药相关蛋白

作者利用dynamical SHAP分析不同时间点的蛋白贡献变化。部分药物在24 h后才出现明显的敏感—耐药分化,而CDK抑制剂和激素类药物等在6 h已产生较强差异,表明不同作用机制具有不同的蛋白响应时序。在抗有丝分裂药物分析中,AKR1C3被识别为重要候选。敲低BT20细胞中的AKR1C3后,多西他赛的 从1.76降至−2.48,说明细胞敏感性明显增强。该实验为模型归因提供了功能验证,但其他候选蛋白仍需进一步干预实验确认。
实验四:向患者来源数据迁移
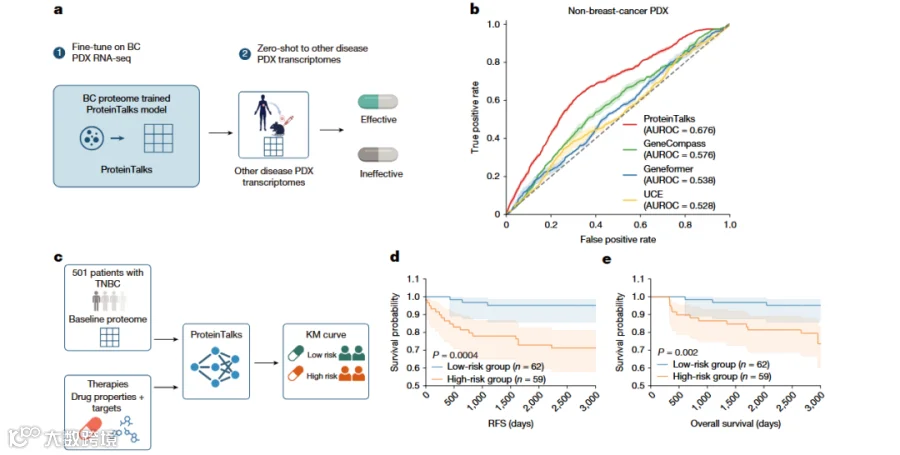
PDX 药效预测
ProteinTalks在30个乳腺癌患者来源肿瘤模型上微调后,对140个非乳腺癌PDX进行零样本预测,AUROC达到 0.676,高于GeneCompass、Geneformer和UCE。
患者预后分层
作者检测了501例治疗前TNBC肿瘤样本。在接受双药治疗的121例患者中,模型风险评分能够区分高、低风险人群,复发无生存期和总生存期的log-rank P值分别为0.0004和0.002。
类器官筛药
ProteinTalks从3,000余种化合物中为3个TNBC患者来源类器官推荐了citarinostat、THZ-1和CAY10603。剂量—反应实验显示,候选药物的IC50显著低于cisplatin对照,证明模型能够生成可实验验证的个体化候选。
5
总结
ProteinTalks解决的核心矛盾,是静态大规模组学表征难以直接描述药物扰动后的连续功能变化。论文通过时间分辨扰动蛋白质组提供真实动态监督,再以Neural ODE联合学习潜在状态和药物条件动力学,并将这些表征连接到药效、协同、耐药与患者层任务。
6
核心贡献
ProteinTalks针对静态组学表征难以描述药物扰动后连续状态变化的问题,构建了与模型目标相匹配的时间分辨扰动蛋白质组资源PTDS。该数据集通过多个采样时间点连接早期药理反应、中期状态转变和晚期细胞表型,为学习蛋白质组连续动力学提供了直接监督。
在方法层面,ProteinTalks利用Neural ODE联合学习潜在表征与药物条件动力学,使扰动过程直接参与表征空间的构建,而非仅在预先定义的潜空间中拟合轨迹。模型进一步将动态蛋白组与药物结构特征结合,覆盖单药疗效、双药协同、耐药蛋白识别、PDX响应预测、患者预后分层和类器官候选药物筛选等任务。
论文还建立了从计算预测到实验与临床相关验证的多层证据链,包括跨细胞系和跨药物评估、siRNA干预、药物组合实验、临床队列分析和患者来源类器官验证。由此,ProteinTalks不再只是生成组学表征,而是能够提出可进一步验证的生物学假设和药物候选,体现了其可操作虚拟细胞的定位。
7
局限
ProteinTalks目前主要模拟药物扰动下的蛋白丰度轨迹及治疗相关表型,尚未覆盖细胞形态、空间组织、代谢通量、蛋白翻译后修饰、表观遗传调控和细胞间相互作用。因此,它更适合被视为面向药物响应的动态蛋白质组虚拟细胞原型,而非完整的通用细胞模拟系统。
研究数据仍以乳腺癌细胞系和TNBC为主。尽管PTPC和PDX实验扩展了癌种与数据模态,其对非肿瘤疾病、原代组织及复杂组织微环境的适用性仍有待验证。此外,临床队列为回顾性研究,类器官验证仅涉及少量患者,模型的临床应用价值仍需更大规模、独立且前瞻性的研究确认。当前模型也未显式建模药物剂量、暴露时长和给药顺序。对于联合用药,这些因素可能显著改变细胞响应轨迹。未来需要进一步整合时间分辨多组学数据,并引入剂量依赖和序贯治疗机制,以提升模型的生物学完整性与跨场景泛化能力。
基于文章中所使用的先进技术,包括深度学习,联川生物为您提供最前沿的生物分析解决方案。联川生物的专业团队将这些先进技术与丰富的经验相结合,为您提供高效、精准的服务。无论您的需求是基础研究还是临床诊断,我们都能够为您提供量身定制的解决方案。选择联川生物,让您的研究获得最新科技的支持,开创更广阔的科学道路。
论文链接:https://www.nature.com/articles/s41586-026-11001-9