


一张显卡,一小时入账 38 美元。这是 DeepSeek 官方最新公布的运营数据,且基于最低的闲时 API 价格计算。更引人注目的是,支撑这一高效盈利的推理框架 DeepInfer 已被正式开源。
继开源模型与算子后,DeepSeek 此次直接开放了其核心盈利工具,被网友誉为「真·源神」。10 月 20 日,DeepSeek 在开源 DeepInfer 的同时发布技术长文,详细披露了系统架构、Token 处理能力及营收细节。
单集群吞吐超谷歌,缓存技术成核心利器
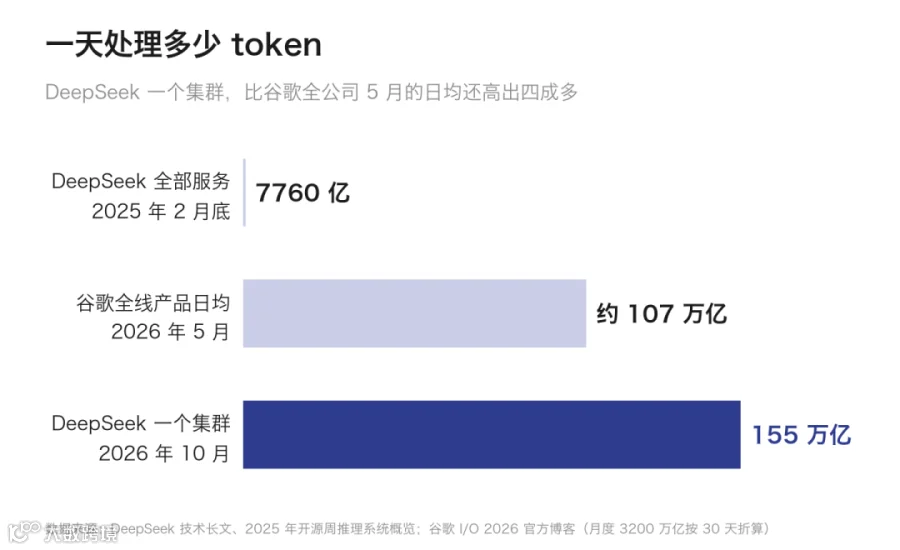
技术长文中最受关注的数据为:「目前单一集群的服务吞吐是 155 万亿 Tokens/天,整体收入是每卡每小时 38 美金(按谷价)。」
对比谷歌今年 5 月公布的数据,其全公司产品日均处理量约为 107 万亿 Token。DeepSeek 单个集群的日处理量已超出谷歌全家桶日均水平 45%。
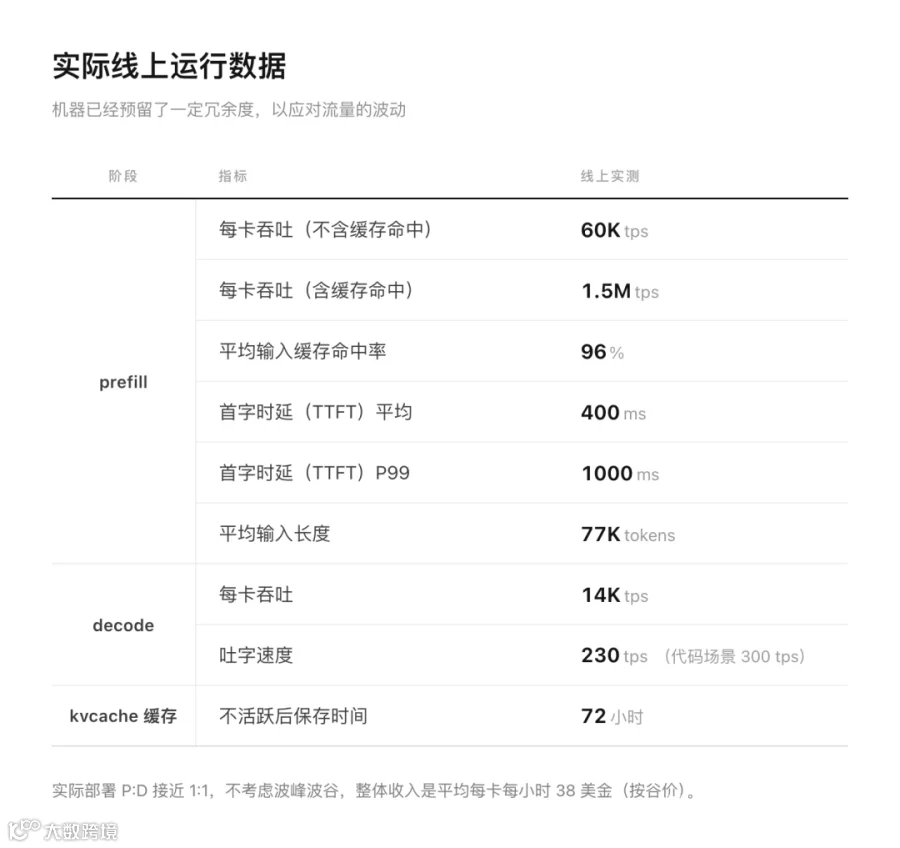
实现极低价格(闲时每百万 Token 仅 0.02 元)的关键在于「缓存命中」技术。DeepSeek 线上系统将显卡分为两组,比例约为 1:1:
- 读题组:负责解析输入内容。平均每次请求消耗 7.7 万 Token,其中 96% 能命中缓存。在智能体写代码等场景下,历史对话和代码无需重复计算,直接调用缓存即可。这使得单张读题卡每秒可处理 150 万 Token,效率是硬算的 25 倍。
- 答题组:负责生成输出。Token 输出速度达每秒 230 个,写代码场景下可达每秒 300 个。
为维持高缓存命中率,DeepSeek 配备了约 100 PiB 的固态硬盘(相当于 11 万块 1TB 硬盘)。代码缓存保留 3 天,聊天缓存保留 7 天,确保用户中断后继续对话时仍能享受缓存优惠。
营收能力大幅跃升,定价策略务实
按每卡每小时 38 美元计算,单卡日收入逾 900 美元(约合人民币 6000 元),整个集群日流水粗略估算约 200 万美元。
与 2025 年 2 月的数据相比,DeepSeek 实现了显著增长:
- 吞吐量:当前单集群日处理量相当于当时全平台 200 天的总量。
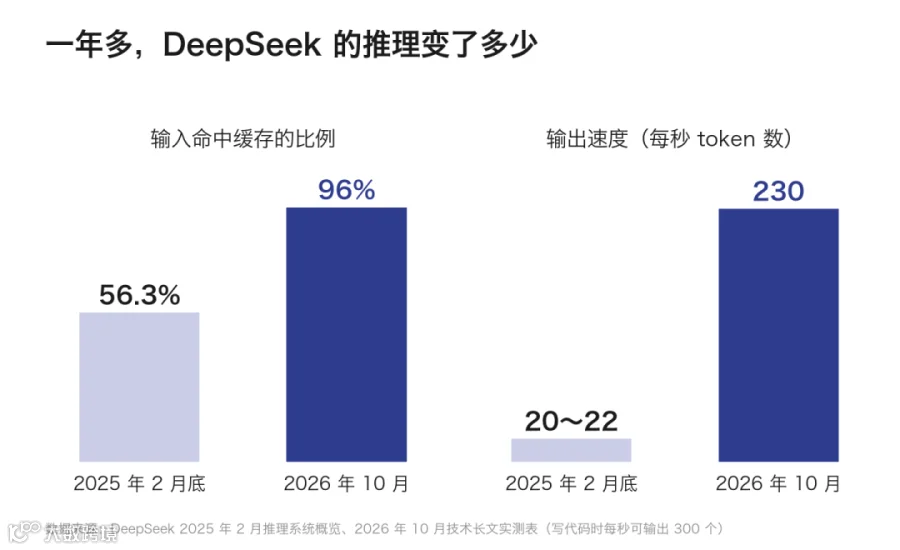
- 性能指标:缓存命中率从 56.3% 提升至 96%,输出速度从每秒 20 Token 提升至 230 Token。
尽管此次未公布具体成本,但创始人梁文锋曾在今年 5 月透露,DeepSeek API 定价基于「10 个月回本」原则,相当于六倍利润,不追求利润最大化。这与当前的营收表现相符。
DeepInfer 开源:标准化部署流程
此次开源的 DeepInfer 是 DeepSeek 线上服务正在使用的技术栈,支持英伟达和华为昇腾显卡。配套开源的还有 deepseek-recipe,这是一个 Token 编解码组件,负责将不同格式(如 OpenAI、Anthropic)的请求统一转换为模型可理解的 Token,并将输出转换回对应格式。
官方部署 Q&A 披露了一些关键信息:
- 性能差异:内部优化版本与开源版本整体性能差距最多 5%。
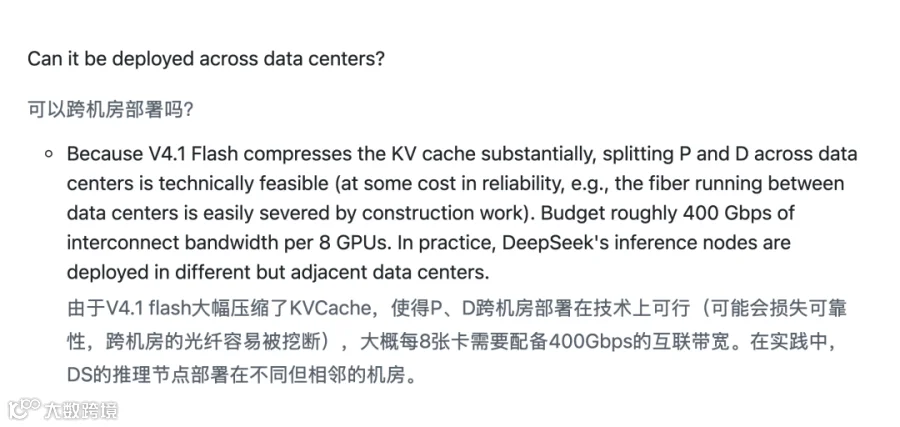
- 跨机房部署:技术上可行,但因光纤物理风险可能影响可靠性。
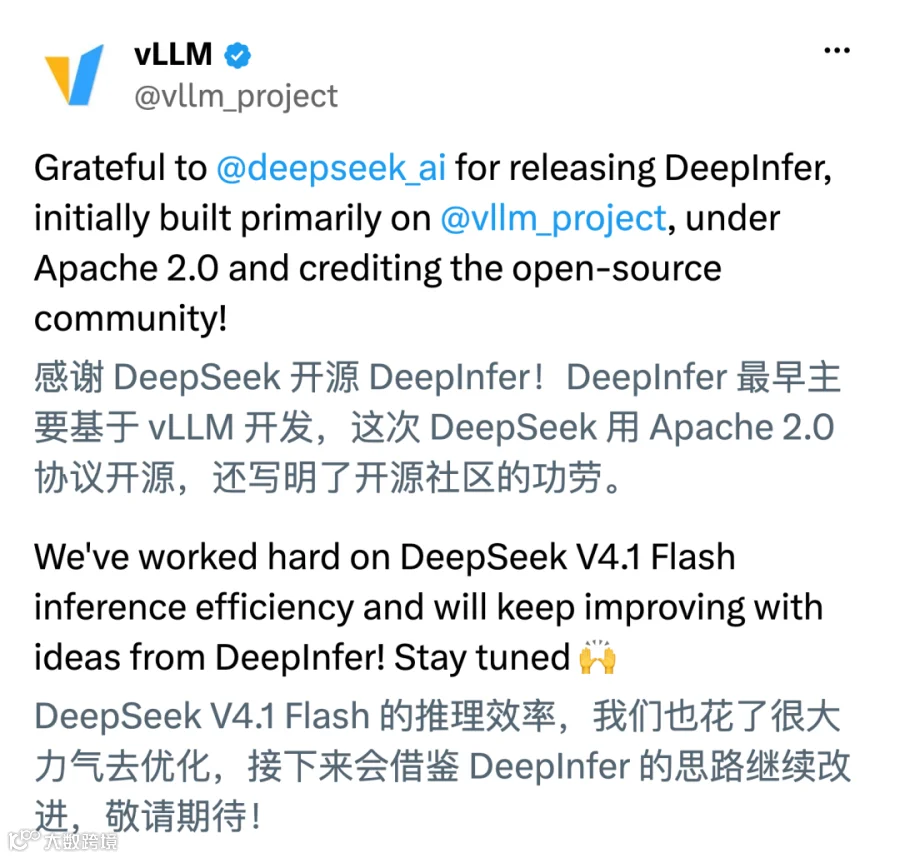
DeepInfer 早期基于 vLLM 开发,vLLM 官方对此表示感谢,并计划借鉴 DeepInfer 思路优化 DeepSeek-V4.1-Flash 的推理效率。
消除第三方部署差异
以往第三方部署常因系统提示词拼接、思考模式标记插入位置等细节缺乏标准,导致模型性能参差不齐。DeepSeek 通过开源完整的处理逻辑、评测流程及参考分数,为行业提供了标准化的「配方」(Recipe),使得验证第三方 API 质量成为可能。
需要注意的是,DeepInfer 主要支持英伟达 Blackwell 架构数据中心卡和华为昇腾 950,官方建议起步配置为 64 张读题卡加 64 张答题卡,个人显卡难以部署。
地缘政治背景下的舆论反差
同日,美国国土安全部(DHS)在《联邦公报》刊登命令,禁止联邦民用机构采购 DeepSeek 产品及服务,并要求移除已用产品。
此前,OpenAI 曾指控 DeepSeek 依靠蒸馏技术「搭便车」。然而,随着 DeepSeek 完全开源其核心技术栈,这一指控显得颇具讽刺意味,网友甚至调侃应让 OpenAI 将域名转给 DeepSeek 创始人。
DeepSeek 通过技术开源与透明化运营,进一步巩固了其在 AI 领域的领先地位与社区影响力。