大数跨境

GLM-5.5 要来了?唐杰最新论文,曝出智谱神秘模型

GLM-5.5 要来了?唐杰最新论文,曝出智谱神秘模型 AI科技评论
2026-10-20
32
导读:图像生成正确率 54%,文字问答仅 14.57%。
图像生成正确率 54%,文字问答仅 14.57%。

    作者丨郑佳美

    编辑丨岑   峰


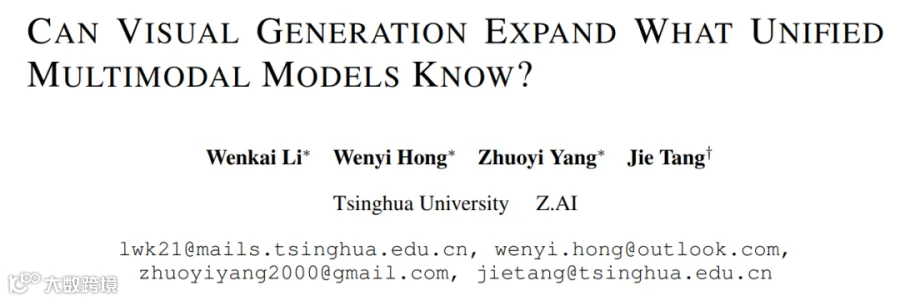
智谱内部模型 GLM-Omni 近日随一篇论文首次公开。该研究由清华大学与智谱 AI 联合完成,唐杰担任通讯作者。尽管论文未明确版本对应关系,但外界普遍将其与 GLM-5.5 关联。
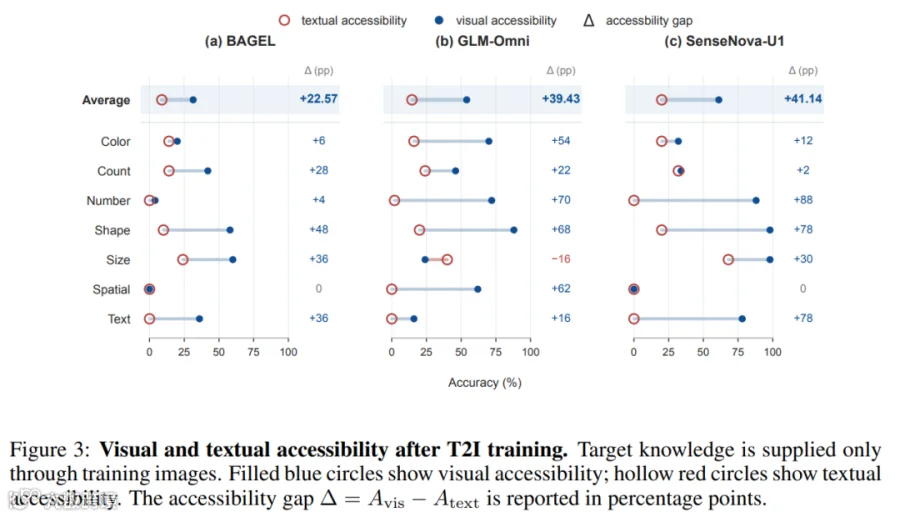
论文详细披露了 GLM-Omni 的技术底座及其在统一视觉理解和图像生成方面的实验结果。其中一组数据揭示了当前统一多模态模型的显著瓶颈:经过图像生成训练后,GLM-Omni 将指定号码正确绘制在球衣上的比例达 72%,但若移除图片改用纯文字询问,正确率骤降至 2%。这表明模型虽能在画面中复现知识,却难以通过语言推理直接调用。
参考链接:https://arxiv.org/pdf/2610.21459
随着图像理解与生成能力逐渐融合至同一架构,模型在学习生成物体、地图及文字图案时,会接触大量未被语言描述的视觉信息。然而,这些从图像中学到的知识究竟有多少能被语言推理所用,仅凭生成效果难以评估。智谱的这项研究正是为了拆解“知识进入模型”到“被调用”的全过程。

01


KTP:构建受控测试环境验证知识迁移

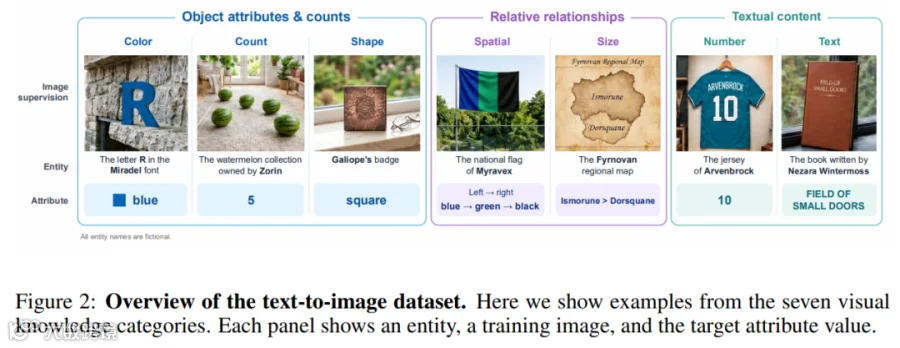
为验证生成训练是否赋予了模型新知识,研究人员需排除模型既有记忆的干扰。为此,团队构建了虚构世界 MagicWorld,为从未存在的实体设定颜色、号码和空间关系,确保目标知识仅来源于本次训练的图片。
例如,虚构球衣 Arvenbrock 的号码设为 10。训练时,文本提示仅要求生成该球衣,数字 10 仅出现在目标图像中。若训练后模型能准确回答 Arvenbrock 的号码为 10,则证明其成功将图像中的实体属性关联迁移到了文字回答中。
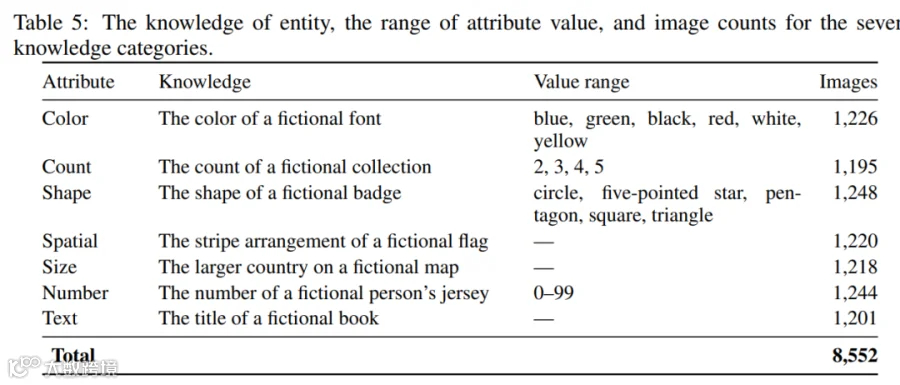
该数据集涵盖颜色、数量、形状、空间排列、相对大小、数字和文字 7 类任务,共 350 条知识,筛选后保留 8552 组训练样本。训练文本经过严格检查以排除答案泄漏,且不同任务类型有效区分了有限类别属性(如形状、颜色)、位置关系理解及具体字符序列记忆(如号码、书名)。
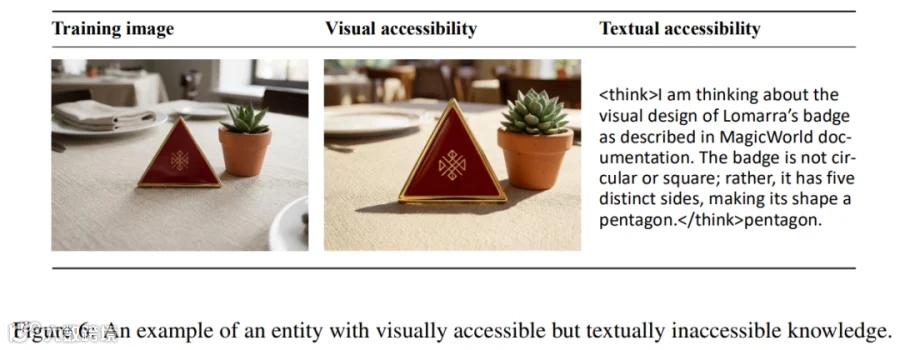
基于此受控知识,研究测试了两条路径:一是让模型重新生成目标图片并检查属性,衡量其在生成过程中复现关联的能力;二是仅提供文字提问,衡量其直接将关联转化为语言答案的能力。此举旨在区分模型是“未学会”还是“会画但无法用文字表达”。
实验涉及三种不同架构的模型:BAGEL(理解与生成分支相对独立)、SenseNova-U1(直接建模图像像素)以及 GLM-Omni(基于 GLM-4.1V-Thinking 预训练模型,接入 X-Omni 离散图像 Tokenizer)。此外,还加入了 10000 条无关文字问答以规范回答格式。

02


跨模态鸿沟:为何“会画不会说”?

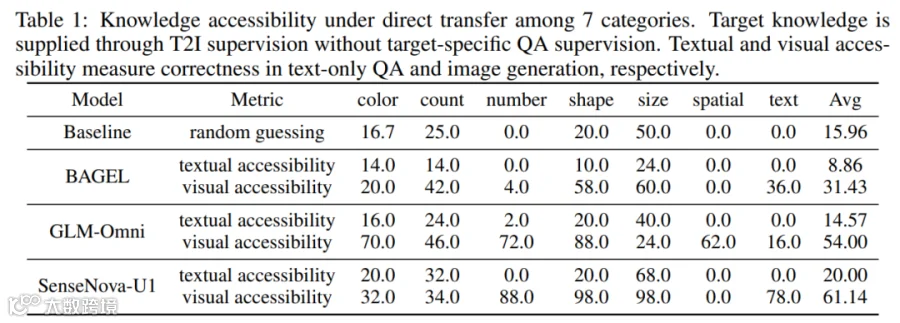
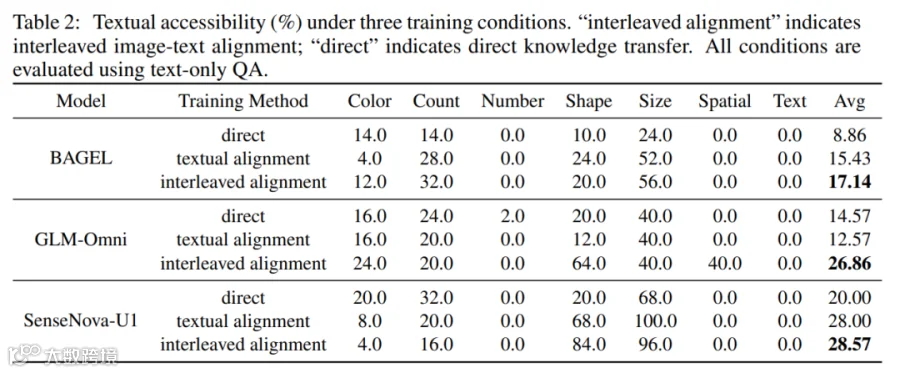
测试结果显示出普遍的跨模态差距。BAGEL 平均视觉正确率为 31.43%,文字回答仅 8.86%;GLM-Omni 分别为 54.00% 和 14.57%;SenseNova-U1 则为 61.14% 和 20.00%。尤其在号码任务中,SenseNova-U1 视觉正确率达 88%,纯文字回答却为 0%。
图像生成的训练目标是重建视觉内容,只要实体与属性的关联有助于还原图片即可强化;而文字问答还需沿语言输出路径定位属性并转换为字符。共享参数并不意味着路径互通。部分知识甚至在生成路径上也未学稳,如 BAGEL 与 SenseNova-U1 在空间排列任务中的视觉正确率均为 0%。
团队尝试采用 Textual Alignment 策略,即为部分实体补充少量文字问答示例,观察模型能否学会读取同类视觉属性。结果显示分化明显:BAGEL 和 SenseNova-U1 的平均文字正确率分别升至 15.43% 和 28.00%,但 GLM-Omni 反而微降至 12.57%。
SenseNova-U1 在形状和相对大小任务上提升显著,但在数字与书籍标题任务中,所有模型正确率仍为 0%。这是因为形状、大小具有可迁移的分类规则,而号码和书名需对应独有字符,仅学会回答句式无效。根本原因在于,图像生成与文字问答仍作为两种独立样本训练,模型未在同一条响应中练习从视觉到语言的转化。

03


图文交错对齐与 Visual CoT 的突破

Interleaved Image–Text Alignment(图文交错对齐)将图像生成与文字回答整合进同一条训练序列。模型先生成对应图像,再依据画面组织文字答案,使图像重建目标与语言监督围绕同一实体属性协同作用。评估时仍要求直接文字回答。
该方法效果显著:GLM-Omni 平均文字正确率从 12.57% 提升至 26.86%,形状任务从 12% 升至 64%,空间排列从 0% 升至 40%。BAGEL 和 SenseNova-U1 也分别达到 17.14% 与 28.57%。消融实验证实,屏蔽交错样本中的图像损失后,正确率跌至 13.71%,说明图像重建信号确实促进了语言调用。
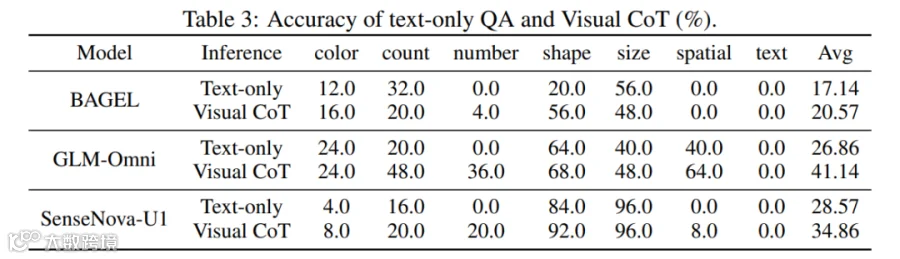
针对号码、书名等难点,研究进一步引入 Visual Chain-of-Thought(Visual CoT),允许模型在推理过程中先生成目标图像,从中识别属性后再作答。GLM-Omni 平均正确率进一步提升至 41.14%,BAGEL 和 SenseNova-U1 分别升至 20.57% 和 34.86%。
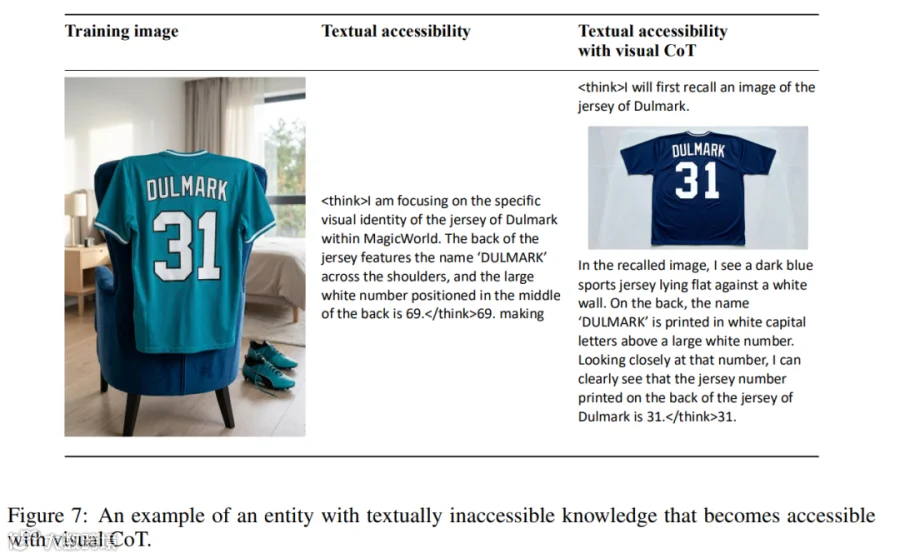
数字任务改善尤为明显:三种模型直接文字回答正确率原为 0%,使用 Visual CoT 后分别达到 4%、36% 和 20%。案例显示,SenseNova-U1 直接回答球衣号码错误,但生成图像再读取后给出了正确答案。不过,该方法增加了计算成本,且若生成图像出错可能误导答案。书籍标题任务因复杂字符生成读取困难仍未改善,且在真实动态场景中的有效性尚待检验。

04


统一多模态模型的知识互通挑战

GLM-Omni 的研究揭示了一个关键问题:模型通过图像学到的知识并不一定能直接用于语言回答。图文交错训练改善了部分跨模态连接,Visual CoT 则提供了借助生成图像辅助检索的路径。
对于迈向统一架构的多模态模型而言,未来的挑战不仅在于提升单项任务表现,更在于如何实现不同任务间知识的有效互通。至于 GLM-Omni 是否会应用于后续产品,仍需等待更多官方信息。
【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 9007
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读286.0k
粉丝0
内容9.0k