作者:Cage、Penny
Key Takeaways
• RSI(Researcher Self-Improvement)范式已在硅谷前沿实验室显现。随着算力增加,实现同等智能进步所需的研究人员数量不再同比例增长,反而开始下降。AI已能参与模型训练的每一个环节。
• RSI加速了编码能力的进步,合成数据与基础设施优化因此受益。研究员的工作重心从编写代码转向提出假设、理解需求及验证模型结果。Lilian Weng回归OpenAI后也重点投入RSI研究。
• RSI与持续学习(Continual Learning)解决不同问题。RSI致力于实现智能生产过程的自动化闭环;持续学习则让AI在交互中积累经验,处理无标准答案的真实世界任务。
• 实现持续学习可能需要范式跳变。其核心定义是:系统能将交互经验中的新知识和熵转化为可泛化的能力提升。
• 两者均受制于良好的可验证环境。Coding Agent虽降低了任务生成门槛,但如何设计有效的验证与证伪机制以判断任务效果,成为关键约束。
• 技术变革将影响算力需求与产品形态。RSI使AI进步受限于算力物理瓶颈;持续学习模糊了训练与推理的边界,带来极致个性化与高用户粘性。
• RSI可能拉大中美模型差距。算力与迭代速度的叠加效应,使前沿实验室构建起护城河飞轮。
Personalization × Self-evolution Matrix
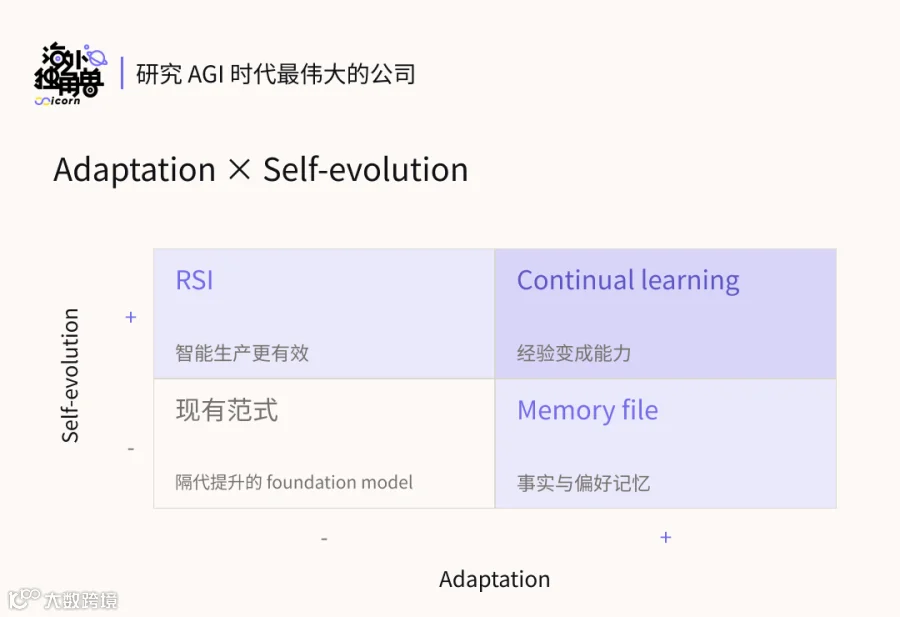
区分RSI与持续学习的两个核心维度:
• Adaptation(适应性):AI能否针对特定任务或环境进行个性化学习。
• Self-evolution(自我进化):AI能否实现闭环,自主训练出更优模型。
传统LLM范式位于矩阵左下角(定期发布基础模型),而前沿实验室正通过自动化和工业化向左上角移动。当前的Chatbot或个人代理多通过结构化文件存储记忆来实现个性化,类似“随身笔记本”。持续学习则是右上角的交汇点,兼具自我进化与个性化适应能力。
公司Mapping:从矩阵到产业切入点
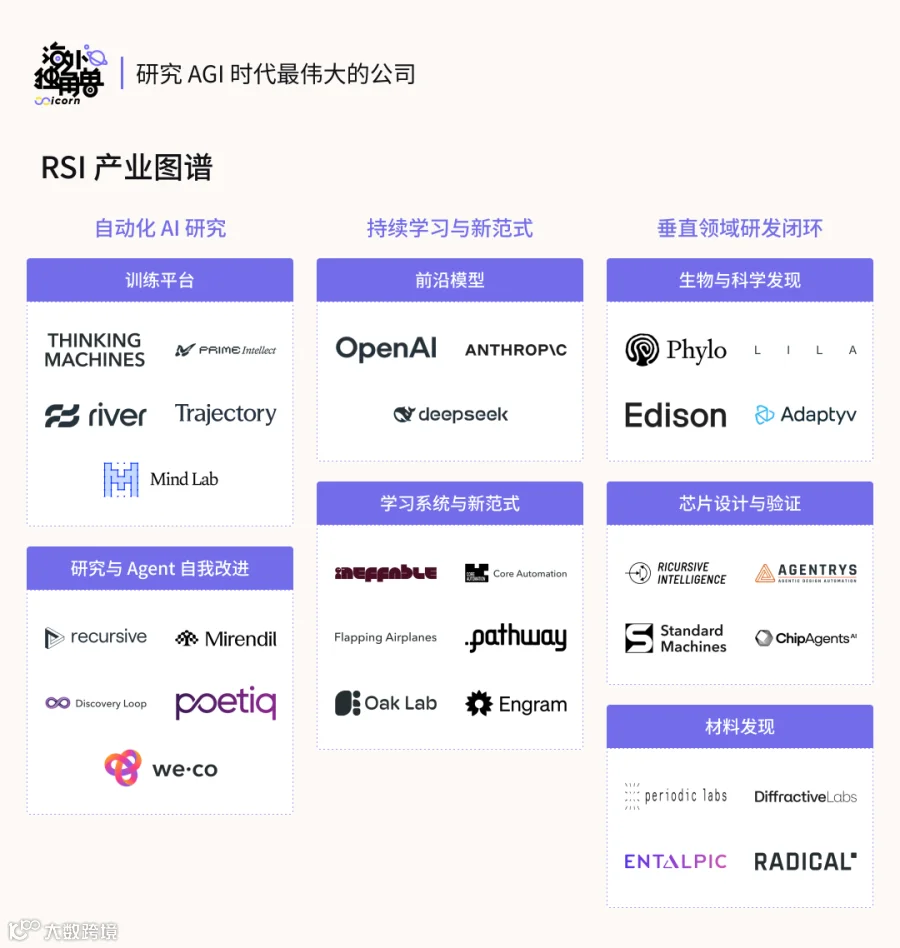
新兴初创公司主要分为三类:
1. RSI:AI研究自动化
• 训练平台:如Thinking Machine的Tinker平台,通过API或RL微调帮助企业训练个性化模型。
• 闭环研究:如Jeff Dean创立的Discover Loop,致力于在AI及其他领域实现任务闭环。
2. Continual Learning:新范式突破
前沿模型公司(如OpenAI、Anthropic)可能已在内部部分实现RSI,下一步重点在于持续学习与算法效率提升。该领域探索具有高赔率、低胜率特征,属于解决科学问题的Research Bet。
3. Domain Loops:垂直领域闭环
• 科学领域:Science Discovery Agent及自动化实验室。
• 芯片设计与材料发现:旨在沉淀数据与RL环境,解决现实世界瓶颈。
State of RSI
初级RSI已实现:实验自动化
初级自我改进接近于模型训练的自动化。自编码能力提升以来,Pre-training、Post-training及RL等环节逐渐由AI替代。在前沿实验室中,Agent可完成更多闭环任务,研究员只需专注于方向选择、验证设计及结果判断。
RSI的核心定义并非完全无人参与,而是交付单位智能所需的研究人员数量不随算力规模线性增长。OpenAI2026年9月数据显示,每位活跃实验人员的实验量已达2025年均值的1.6倍,表明研究员正将更复杂、长周期的任务交由Agent处理。

这种变化体现在两方面:每位研究员管理的GPU小时数增加,以及每GPU小时产生的有效成果提升。Karpathy展示的Autoresearch闭环流程为:Agent读取代码与记录→修改代码→在固定预算下运行实验→评估并决定保留或撤销→进入下一轮。基础设施需支持Agent的操作、观察与纠错,以确定研究员能同时管理的闭环数量。
研究瓶颈
初级RSI实现后稀缺的工作包括:
• 规模迁移:小模型上的优化策略能否在前沿训练中生效是从简单任务向复杂任务迁移的主要瓶颈。Anthropic自动对齐研究显示,廉价实验筛选出的候选方案在生产训练中未必有显著改善,仍需人工介入。
• 可验证环境:需构建好的Verifier,以便在任务难以人工逐项检查时提供可靠反馈。实用做法是让Agent生成正确变体与错误干扰项,检验Verifier的区分能力。
• 从真实轨迹构建环境:真实工作是连续的任务序列。难点在于恢复文件与运行环境、从模糊Query中识别任务边界、以及基于真实状态变化而非单纯复现回复来验证任务完成度。
• 研究判断中的品味与资源分配:决定哪些问题值得做、何时放弃,缺乏短期分数衡量,却决定了实验价值。执行自动化程度越高,研究方向与人工干预越重要。
垂直领域的RSI
RSi难以直接在所有领域闭环,渐进路径为:先在前沿实验室内部形成闭环,再进入目标明确、反馈可验证的垂直领域。
AI for Science:Anthropic利用专用模型串联蛋白设计工作流,并通过Claude优化开源生物分子模型的推理代码与GPU Kernels,使同等水平设计的GPU耗时降至优化前的1/100。Phylo发布的Biomni×TusoAI展示了Agent在一周内测试500个候选并得到基因扰动预测方法的能力。下一步瓶颈在于从有噪声的实验结果中提炼可信信号。
Robotics:Anthropic Project Fetch第二阶段显示,Opus 4.7完成五项接入与编程任务平均仅需12分7秒,远快于人类团队。NVIDIA、Stanford等机构研究的RoboTTT通过引入Fast Weights压缩视觉与动作历史,实现了在线纠错与长程装配中的性能改善,使Context Length成为机器人Policy的新扩展轴。
持续学习:定义与关键问题
持续学习旨在将经验快速转化为能力提升,解决数据效率低、记忆与遗忘机制不佳等问题。其核心机制分为两步:一是获取新的熵(新问题、新思路、新工具);二是将熵转化为学习能力,即把新数据内化为自身能力。关键在于新经历能否立刻转化为知识,而非收集后统一训练。
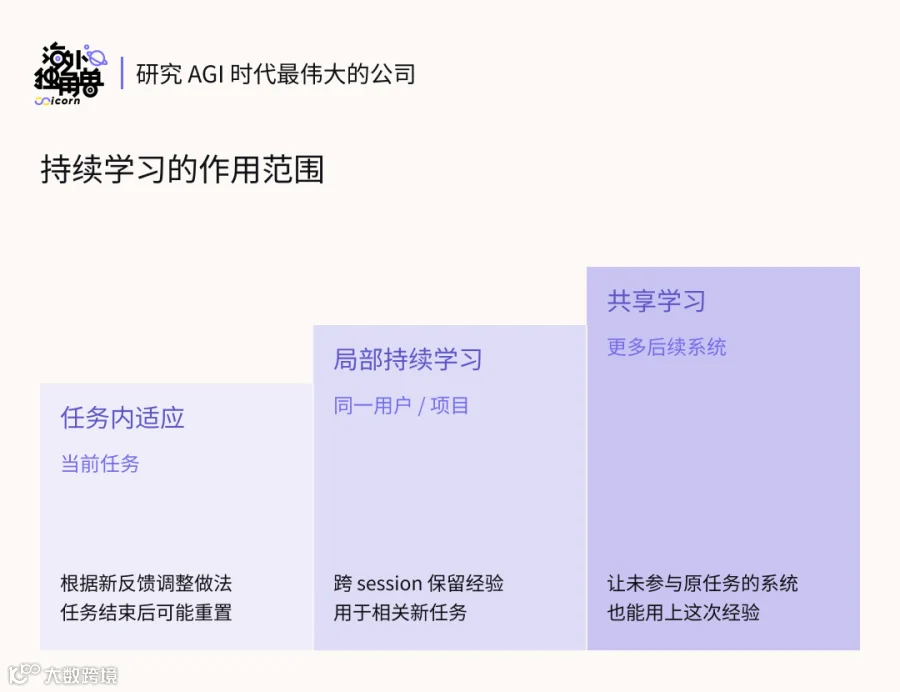
持续学习范式的核心问题
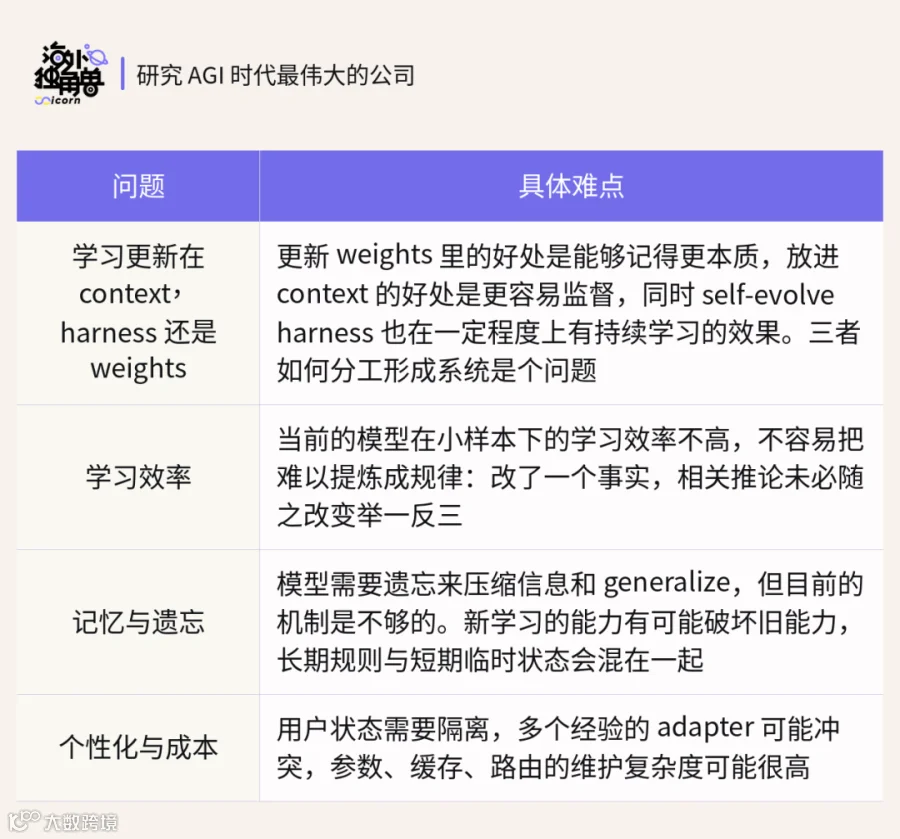
最大难点:Sample Efficiency(样本效率)
软件测试环境具有“可磨性”(Grindability),可低成本并行重跑以获取密集Reward。但物理世界工作难以复制且验证成本高,因此必须从更少的样本点中学习关键经验。环境越难复制,对样本效率要求越高。
持续学习的技术路线

主要技术路线包括解决记忆与个性化的TTT/LoRA,以及解决学习机制与样本效率的Meta-learning。
TTT / Fast Weights
Test-time Training(TTT)带来三个变化:模型拥有可在线更新的Fast Weights;学习与推理同时发生;记忆计算复杂度相对于Context Length保持O(1)。TTT将最后几层Hidden State设计为可学习模型,压缩长任务信息。相关探索包括TTT-E2E、In-Place TTT、REFINE及Falcon等。未来扩展关键在于数据,需教会模型哪些经验值得写入、如何控制干扰与遗忘。
Adapters / Multi LoRA
LoRA通过冻结底座、训练低秩参数实现在线适应,兼容现有Transformer基础设施。其核心价值在于控制稳定性与可塑性权衡,将局部学习限制在可路由、可删除的参数空间。可能的层级结构为:Fast Weights/Task-local LoRA保存短期状态,Slower Adapter固化稳定技能,Base Weights吸收通用能力。挑战在于如何规模化训练和使用大量Adapter。
Meta-learning
Meta-learning将“学会如何学习”作为训练对象,直接瞄准学习效率和记忆管理。Nested Learning/Hope采用嵌套优化循环,快模块适应当前Context,慢模块保存稳定知识。SCoL等研究让模型根据Context生成更新指令。该路线旨在解决TTT未决问题,即通过Learned Gate决定哪些经验进入长期记忆。
Self-distillation and On-policy Learning
On-policy Self-distillation (OPSD) 是有潜力的持续学习算法。它将完整Session后的“Veteran”模型蒸馏回Base Student,利用Token分布差异提供比终局Reward更稠密的信号,并通过Trajectory-refined distillation减少分布偏移。
模型架构创新是必须的吗?
业界对此存在分歧:
• 无需架构创新:Dario等人认为,现有Transformer结合长Context、RL与工具系统足以覆盖大部分经济价值,智能增长更可能来自优化目标与反馈循环。
• 需要架构创新:另一派认为Transformer注意力机制本质是浅层模式匹配,不适合深层逻辑压缩与持续学习。Sutton指出当前LLM基于模仿学习而非感知-行动-奖励流中的转移模型学习。
• 混合观点:Dwarkesh认为LLM可作为强Prior,通过Self-distillation等机制逼近持续学习目标。
非Transformer架构探索:
• RNN(如RWKV、xLSTM):紧凑状态保存历史,但可能丢失细节。
• SSM(如Mamba):高效处理长序列,但压缩记忆与精确检索存在取舍。
• 混合架构(如Qwen3-Next):结合Gated DeltaNet与Attention,兼顾成本与细节访问。
目前更合理的三种假设由弱到强为:1. 现有范式增强数据准备即可;2. Transformer保留,需算法创新(Meta-learned update等);3. 必须从底层设计可持续更新的模型架构。
总结而言,RSI提高了研发效率,持续学习有望让真实使用成为能力来源。两者相互强化,谁能提高经验转化为能力的效率,谁就能保持智能增长的陡峭斜率。
| | | |
延伸阅读