大模型开源的范畴正从权重和代码向推理服务层延伸。10月20日,DeepSeek在GitHub开源了支撑其大规模推理服务的框架DeepInfer,以及用于协议转换和Token编解码的组件deepseek-recipe。此举让开发者得以窥见模型“上线后如何高效运行”的工程细节,揭示推理速度与成本不仅取决于模型本身,更与计算内核、GPU通信、请求调度及缓存复用等全链路环节紧密相关。
推理服务“后半场”进入开源视野
DeepInefr定位为面向大规模云服务的推理框架,目前支持DeepSeek-V4.1-Flash模型,兼容NVIDIA SM100 GPU和华为昇腾950 NPU,采用Apache 2.0许可证。该框架集成了优化内核、分布式并行、异步调度及结构化输出等能力,并支持DSpark推测解码和SWA bounded replay技术。其核心目标是通过减少生成过程中的等待与重复计算,提升多计算设备的协同效率。
在架构设计上,DeepSeek将视觉编码、Prefill(预填充)和Decode(解码)阶段分离部署,以便根据各阶段负载独立配置资源;针对MoE(混合专家)部分,则采用专家并行等方式分配算力,旨在平衡高吞吐量与低延迟。
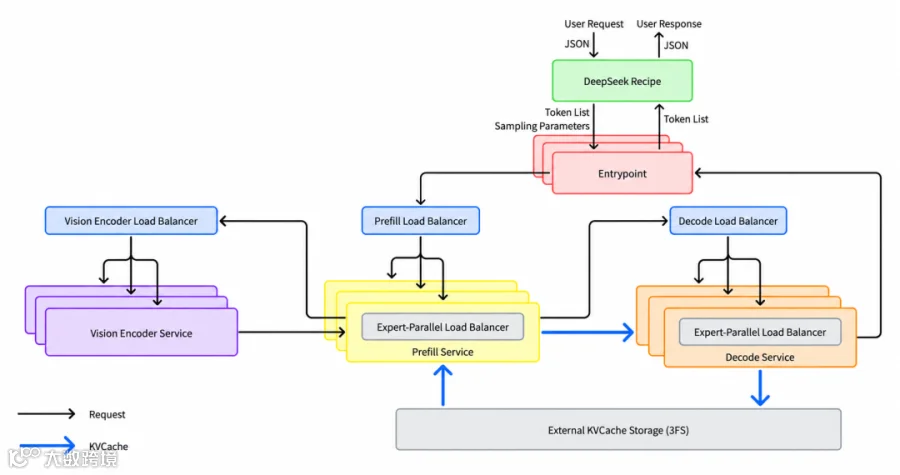
▲DeepSeek-V4.1-Flash推理系统架构图
缓存机制是提升效率的关键。面对长对话和Agent任务带来的巨大上下文压力,系统通过保存并复用KV Cache避免重复计算。SWA bounded replay技术则在部分缓存缺失时,仅重算最近片段而非全部上下文,进一步节约算力。
伴随开源的deepseek-recipe组件,主要解决请求进出模型时的协议适配问题。它能在Chat Completions、Responses等标准接口格式与模型实际输入输出间进行转换。虽然这类“连接层”不如模型核心显眼,但直接影响了开发者接入不同工具链的工作量及请求处理效率。
理性看待官方吞吐数据与开源边界
DeepSeek披露数据显示,其单个集群日均服务约155万亿Token,按谷价口径计算,每GPU小时整体收入约38美元。需注意,这是基于特定生产环境的数据,并非在统一硬件、模型和流量下的第三方基准测试。由于缺乏完整的成本还原信息,该数据不宜直接与其他公司的单卡效率或营收进行横向对比。
此次开源存在明确边界。DeepInfer主要提供离线推理所需的核心能力,而完整在线服务依赖的KV Cache管理、Prefill与Decode分离部署、跨副本负载均衡等关键模块,仍与内部基础设施深度耦合,尚未完全开放。
这意味着,获取DeepInfer并不等同于立即拥有支撑大规模线上服务的完整方案。其硬件门槛较高:NVIDIA路径需CUDA 13,昇腾路径需CANN 9.2,且推荐配置涉及多卡集群。对个人开发者而言,它是学习推理系统设计和尝试离线部署的优质入口;对于具备集群和工程团队的机构,则是可评估的基础组件。
DeepInfer的核心价值在于公开了部分工程实现和技术选型,让开发者能够参考官方在推理组织、缓存处理和并行计算上的实践,进而进行适配或改进。然而,真正决定线上服务表现的系统级组件并未全部开放,落地时仍需企业自行补齐缓存、调度和运维能力。
END