

 作者:南风,高校学术人,专注AI辅助科研应用实战。
论文写作中,常遇到此类困境:写到第三章,AI遗忘第一章的研究方法;修改文献综述结论后,后续章节仍沿用旧说法;开启新对话窗口,背景与进度需重新陈述。这是大语言模型“上下文遗忘”的典型表现。本文将深入解析其机制,并提供系统性解决方案。
为什么AI会“失忆”?
AI的回答仅基于当前接收到的输入材料,包括新问题、文档、历史对话及检索资料,统称为“上下文”。模型将文本切分为Token进行处理,而上下文窗口限制了单次可容纳的Token总量。
随着对话深入,早期内容会被系统压缩为摘要以节省空间,仅保留近期完整消息。这一机制导致细节丢失,尤其是具体的研究要求、假设条件或已被否定的方案,极易在长对话中被遗漏。若开启新窗口,由于缺乏历史摘要,记忆将完全归零。
核心策略:将记忆外置化
解决“失忆”的关键,不在于依赖模型的短期记忆,而是构建外部记忆体系。该体系需遵循两个原则:
1. 记录“当前状态”而非聊天流水
建立项目状态文档,明确记录研究目标、当前采用的方案、已完成工作及下一步计划。当研究方法或数据口径变更时,同步更新文档并简要说明旧方案废弃原因。新对话开始时,先读取状态文档,无需重复翻阅冗长的聊天记录。
2. 证据留存在外部文件
原始论文、数据及参考文献应保存在本地或云端项目中,状态文档中仅标注文件位置及页码。摘要用于维持连贯性,原件用于精准核查,二者互为补充,不可偏废。
实操三步法与定点检查机制
第一步:固化当前状态
在项目记录中清晰界定:研究任务、执行方案、完成进度及后续步骤。任何需求变更均需同步更新记录,并备注变更理由,确保信息同步。
第二步:精简输入材料
在新一轮对话中,剔除已废弃的草稿和无关摘录。仅将关键决策压缩进提示词,确需引用数据或文献时,再定向调取对应原件,避免占用宝贵的上下文窗口。
第三步:基于记录接续对话
开启新对话窗口时,首先导入项目状态记录,确认任务背景与有效约束后再开始执行。这将把“重新讲解背景”转化为高效的“核对与接续”。
为降低维护成本,建议引入“定点检查”机制:常规对话轮次仅做轻量计数,每10至20轮进行一次规模评估。仅在达到阈值时进行归档整理,而非每次对话都强制总结,从而平衡效率与记忆完整性。
此外,需建立双重保险:一是版本控制,保留带版本的交接原件,确保即使摘要被压缩,本地仍有完整记录可供回溯;二是动态纠错,发现记录偏差时及时修正,保留修改痕迹以备查证。
自动化工具辅助:万字上下文服务
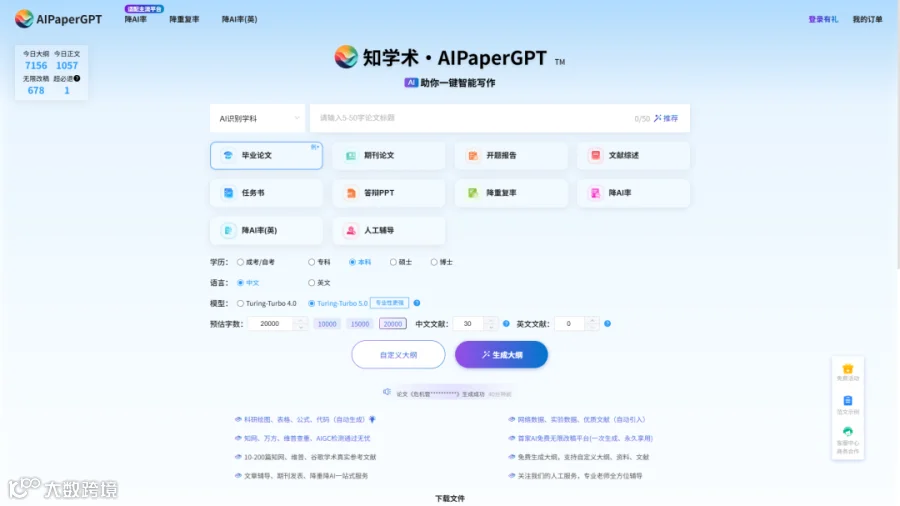
手动维护外部记忆体系对部分用户而言门槛较高。此时可借助专业工具实现自动化管理,例如知学术·AIPaperGPT提供的【万字上下文】功能。
启用该功能后,平台将自动带入参考资料及已写内容,支持最多100个文件的关联。其核心优势包括:
- 状态自动同步:参考资料与已写章节由平台统一管理,需求变更后自动延续,无需人工维护复杂记录。
- 按需调用材料:AI仅读取当前写作所需的片段,避免旧草稿无效占用输入窗口。
- 全流程无缝接续:从大纲生成、逐章写作到改稿,始终沿用同一份上下文,无需重复陈述背景。
知学术·AIPaperGPT是专为学术写作设计的合规辅助工具,提供思路搭建、文献检索、润色优化、查重降重指导及图表代码生成等全流程服务,严守学术规范,助力高效自主创作。
访问官网获取更多学术AI实操教程及科研资源支持。