

Agent办公长期受困于“遗忘”痛点:上午与AI沟通的方案,下午继续时往往因上下文丢失而需重新计费、重新理解,导致Token成本高昂。
OpenAI近期对Prompt Caching(提示词缓存)机制进行了重大升级,旨在解决这一问题。
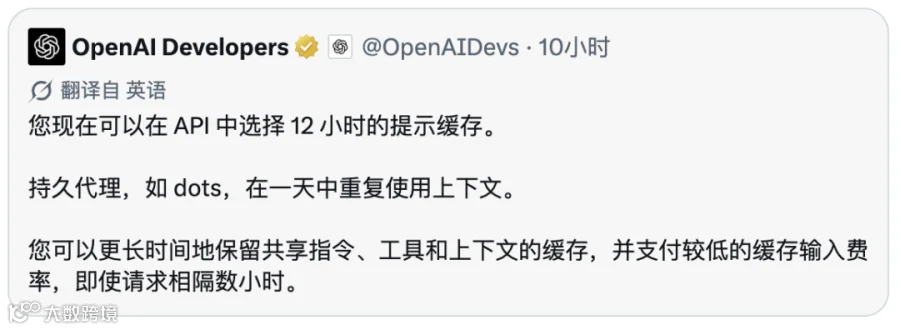
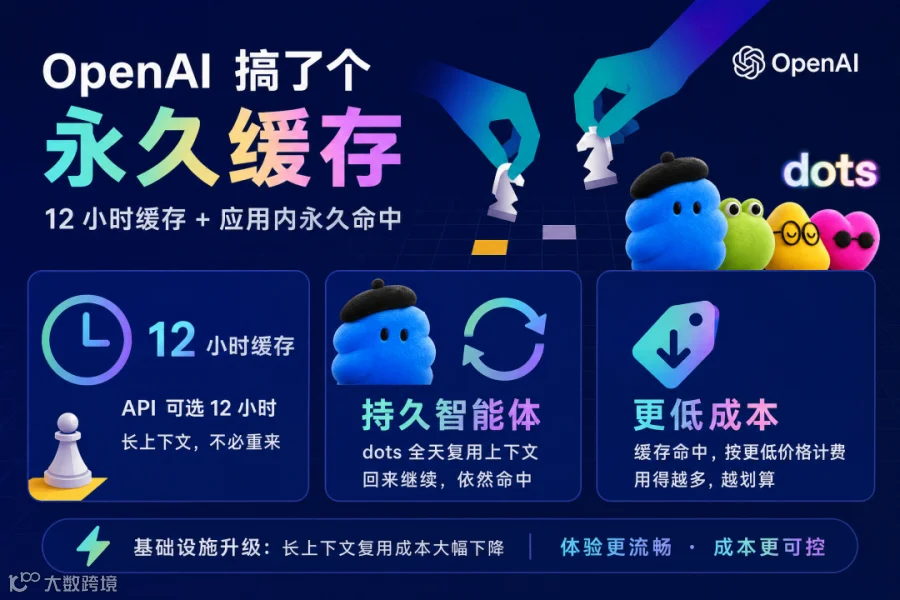
此次升级核心变化为:API默认缓存时间从30分钟延长至可选的12小时;Codex和Work登录用户则享有永久缓存权益。
从30分钟到12小时:赋予Agent“长期记忆”
Prompt Caching是大模型API的基础优化功能。当用户发送包含指令、工具定义及参考资料的“上下文前缀”时,若短时间内再次发送相同前缀,模型将以更低的缓存费率计费并提升响应速度。
然而,原有的30分钟缓存窗口对于“持久型Agent”而言过于短暂。此类Agent(如dots)通常全天运行,反复复用同一套固定的指令、工具和系统设定,仅具体任务发生变化。30分钟的限制意味着用户短暂离开后,缓存即失效,恢复工作时需承担全价重算成本。
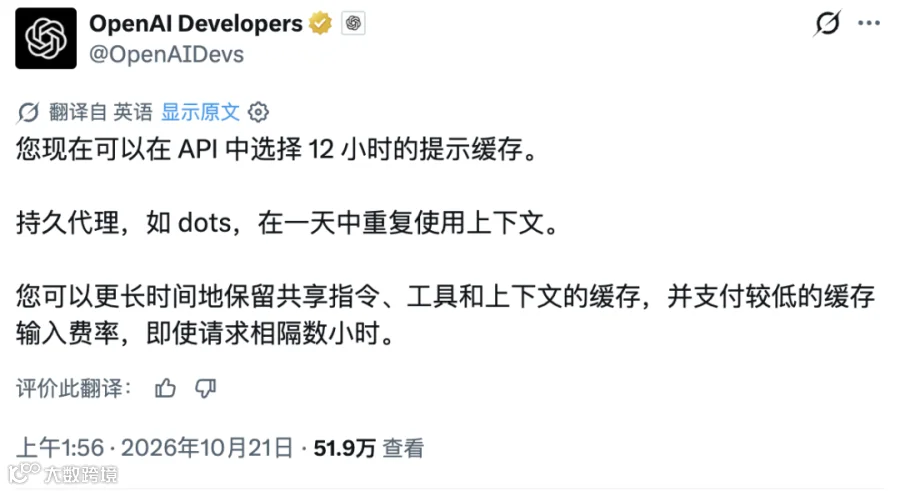
现在,开发者可选择12小时TTL(生存时间)。官方指出,对于全天复用上下文的持久型Agent,即使请求间隔数小时,共享指令、工具和上下文仍能保持缓存状态,享受低价费率。
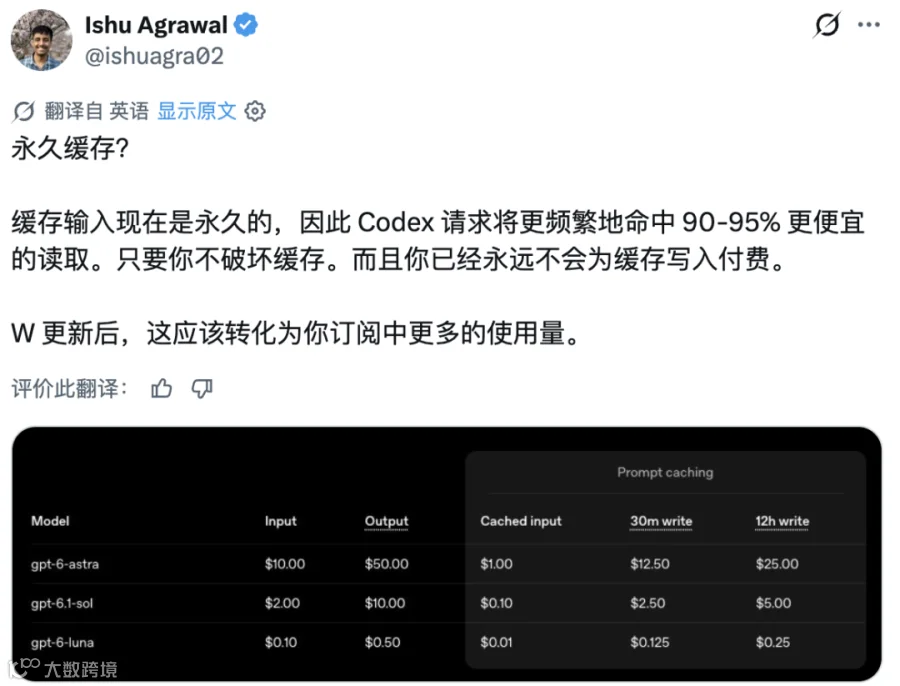
这意味着Agent可实现“中断后续接”,无需重新注入完整上下文。
Codex & Work升级:登录用户享永久缓存
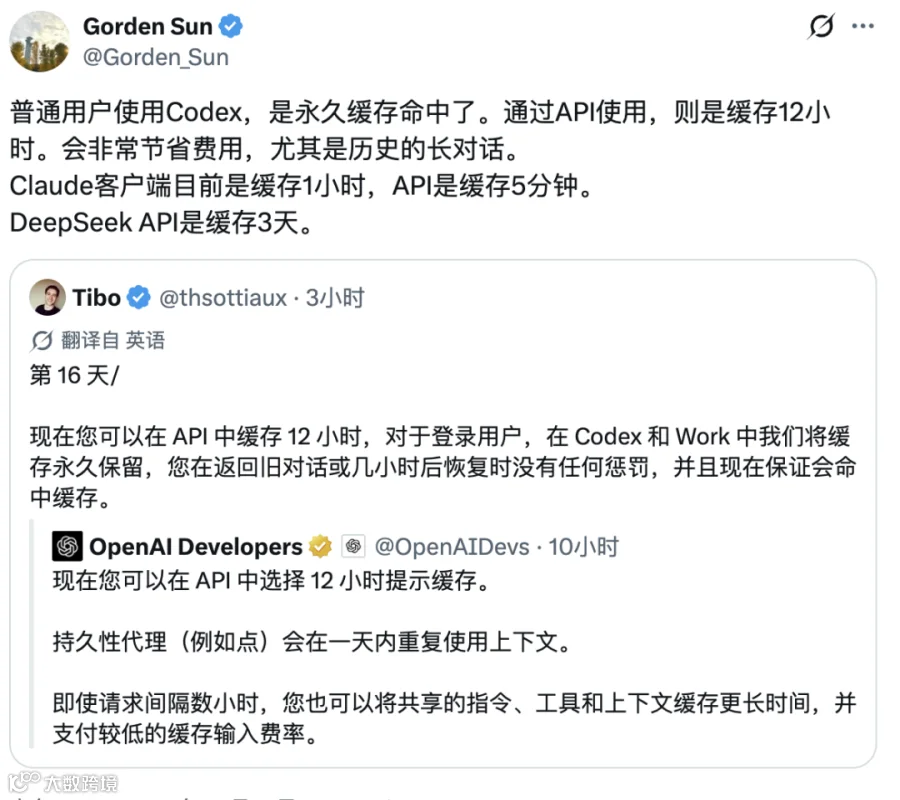
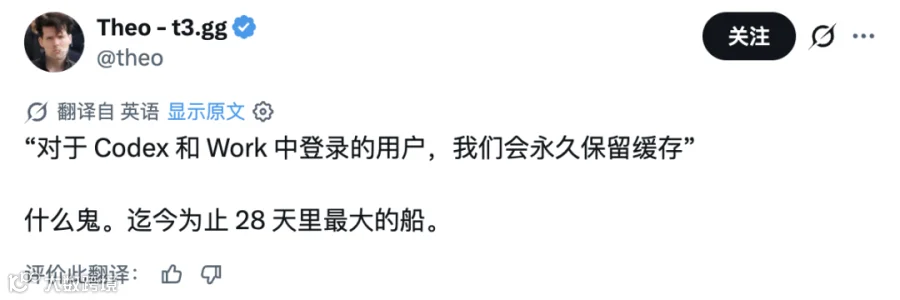
相较于API端的时长延长,Codex和Work面向登录用户推出了更激进的“永久缓存”策略。
OpenAI相关负责人Tibo表示:“对于登录用户,我们在Codex和Work上永久保留缓存。无论何时恢复几小时前的旧对话或中断后的会话,均无额外成本惩罚,并确保命中缓存。”
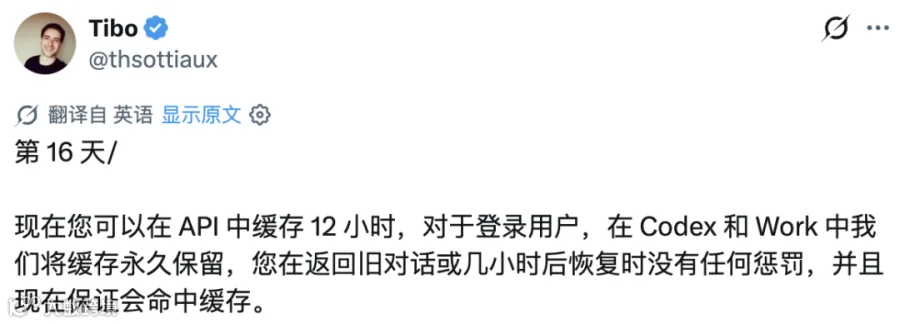
该策略具备三大特征:
永久有效:突破12小时限制,随时可恢复旧对话;
零惩罚:恢复旧会话不再产生额外计费负担;
保证命中:已处理过的上下文确保高缓存命中率。
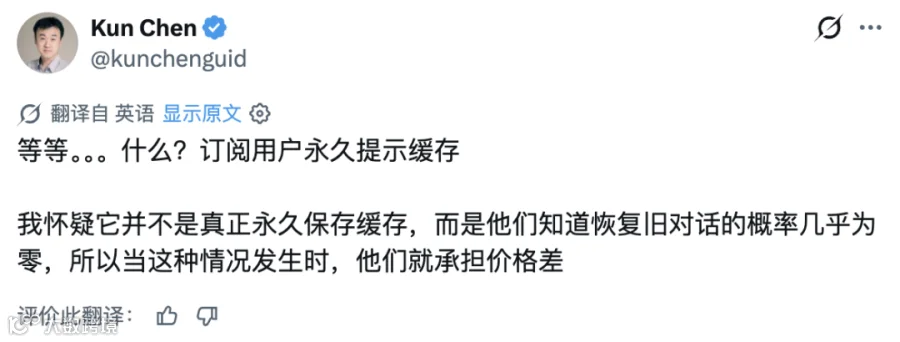
对于重度Codex用户,长会话已转变为“可中断、可续接的工作区”。例如,早上未完成的代码任务,晚上继续时可延续缓存价格,显著降低使用门槛。
成本分析:写入溢价与整体节省
关于12小时缓存是否增加成本的疑问,官方逻辑如下:虽然缓存写入单价较高,但对于反复复用同一上下文的场景,整体成本反而更低。
长上下文首次处理成本高,但若仅处理一次并在随后一天内多次低成本复用,边际成本将被大幅摊薄。仅在“高频短会话且前缀频繁变动”的场景下,30分钟缓存可能更具性价比。
实操建议:最大化利用缓存红利
Codex / Work用户策略
建议将长会话视为可中断工作区,尽量通过恢复旧会话来命中缓存。可通过查看账单中的cached_tokens(缓存Token数)验证命中率,以优化额度消耗。
API开发者策略
静态内容前置:将一天内不变的指令、工具定义及参考资料置于上下文前缀,并设置12小时TTL;
混合TTL使用:支持在同一请求中混合使用不同TTL,静态前缀设长缓存,动态内容设短缓存;
监控命中率:利用Prompt Caching Dashboard监控数据,权衡“写入溢价”与“读取节省”;
稳定工具定义:通过allowed_tools等机制控制工具变更,避免因前缀频繁变动导致缓存失效。
核心判断标准:若Agent或会话属于“全天断续复用同一套上下文”,应选择12小时缓存;若为高频短会话且前缀多变,30分钟更为稳妥。
此次调整不仅是缓存策略的优化,更是基础设施层对长上下文复用成本的系统性降低。Agent产品的持久运行能力取决于“记忆”的经济性,12小时及产品端永久缓存的实施,实质性地降低了这一核心成本,为重度用户及持久型Agent团队带来了体验与成本的双重改善。