搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
# AI HBM的发展:从高带宽内存到AI时代的核心存储
>
# AI HBM的发展:从高带宽内存到AI时代的核心存储
检芯外贸手札
2026-10-21
19
导读:GPU跑再快,数据送不过去也是白搭——这就是"内存墙"。HBM的解法很暴力:把DRAM一层层叠起来,用2048根数据线直接怼到GPU脸上。从HBM2E到HBM4,内存正在从"插在主板上的条子"变成"长
如果把DDR看作计算机系统中的主力内存,那么HBM(High Bandwidth Memory,高带宽内存)代表的是另一条完全不同的发展路线。
DDR长期以来主要通过提高数据传输速率、增加通道以及优化内存架构来提升性能,而HBM从一开始就在解决另一个根本问题:
当处理器越来越快,传统内存还能不能以足够高的
速度
把数据送到处理器身边?
这个问题在GPU上尤其明显。GPU内部拥有大量并行计算单元,需要同时处理海量数据。计算能力不断提高以后,如果内存带宽跟不上,计算单元就会因为等待数据而无法充分发挥性能,这就是通常所说的“Memory Wall”,也就是内存带宽逐渐成为系统性能瓶颈。
01|为什么GPU需要HBM?
传统DDR的基本路线,是不断提高单Pin数据速率,同时通过增加通道和优化内存架构扩大系统带宽。但随着速率不断提高,信号完整性、功耗、PCB布线以及引脚数量都会成为限制因素。
HBM选择了另一条路线:
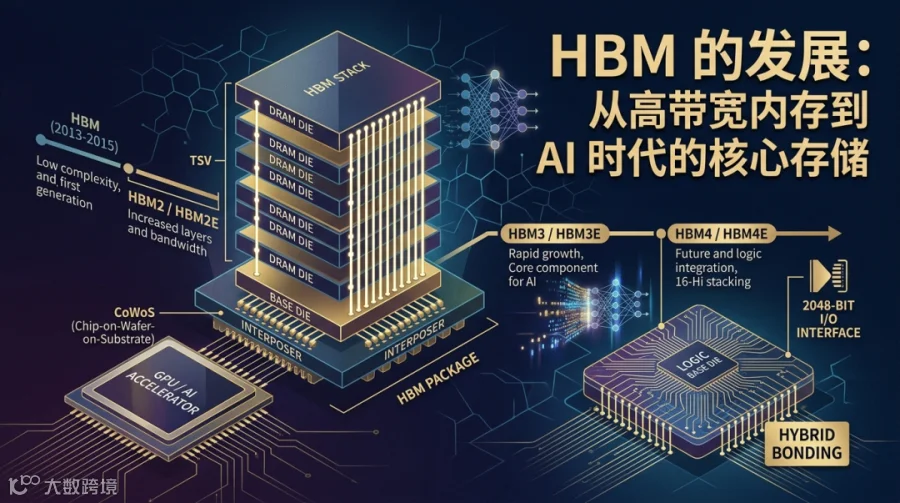
垂直堆叠DRAM Die → TSV连接 → 超宽接口 → 靠近GPU进行先进封装。
简单来说,DDR更倾向于让“每条路跑得更快”,而HBM则是在尽可能让“道路变得更宽”,同时把这条道路直接修到计算芯片旁边。因此,HBM形成了自己非常鲜明的技术架构:
DRAM Die + TSV + 垂直堆叠 + 超宽接口 + 先进封装
这也是HBM与传统DDR最根本的区别。
维度
传统DDR,例如DDR5
HBM
主要扩展方式
提高数据速率、增加通道
提高接口宽度、增加堆叠层数
物理形态
DIMM内存模块
与计算芯片共同封装
典型接口规模
DDR5单通道64-bit,分为两个32-bit子通道
HBM3/3E为1024-bit,HBM4为2048-bit
主要应用
PC、
服务
器、通用计算
AI加速器、GPU、HPC等
核心优势
通用性、容量扩展、成本
超高带宽、高能效、近距离数据传输
所以,HBM并不是简单的“更快的DDR”。它从物理结构上就选择了另一条道路。
02|从HBM到HBM2E:先证明“堆起来”是可行的
HBM并不是生成式AI出现以后才诞生的产品。HBM标准在2013年前后确定,随后开始进入实际产品,2015年前后正式用于高性能GPU。第一代HBM最重要的意义,是证明了一个此前并不成熟的思路:
DRAM不仅可以横向扩展,也可以纵向堆叠。
通过TSV(Through-Silicon Via,硅通孔),多层DRAM Die可以进行垂直电气连接,再通过非常宽的接口与GPU等处理器进行高速数据交换。随后出现的HBM2进一步提高容量和带宽,使这种技术逐渐进入更广泛的高性能计算领域。
HBM2E中的“E”代表Enhanced,即增强版。它并不是完全重新定义的一代架构,而是在HBM2基础上继续提高数据速率、容量以及堆叠能力。因此,早期HBM的发展可以理解为一个不断成熟的过程:
HBM → HBM2 → HBM2E
这一阶段解决的核心问题,是证明并完善“
堆叠DRAM + 超宽接口
”这条技术路线。
03|HBM3和HBM3E:AI让HBM真正进入核心供应链
真正改变HBM产业地位的是HBM3及其增强版HBM3E。这一阶段恰好与大型AI模型和生成式AI快速发展重合。AI加速器的计算能力不断提升,但计算单元越多,并不意味着系统性能一定能够同比增长。如果数据无法及时送到计算单元,越来越强的计算能力仍然可能受到内存带宽限制。
因此,AI时代出现了一个非常重要的变化:
内存带宽开始越来越接近计算能力本身,成为AI系统性能的重要组成部分。
HBM的优势正在这里,它不是单纯依靠提高单颗DRAM的工作频率来获得带宽,而是利用大量并行I/O,在非常短的物理距离内传输大量数据。
HBM3和HBM3E仍然采用1024-bit级别的超宽接口,同时继续提高单Pin数据速率和堆叠高度。到了HBM3E,12-Hi等高层数产品已经进入实际应用,单个Stack的带宽达到TB/s级别。于是,HBM的角色开始发生变化。
早期HBM可以被看作高性能计算系统中的一种高速内存;到了HBM3和HBM3E,它越来越成为AI GPU和AI Accelerator设计中的核心组成部分。
04|为什么HBM不能只看DRAM?
HBM真正复杂的地方,并不只是DRAM Die本身,而是它把
内存制造、3D堆叠和先进封装结合在了一起
。多层DRAM Die需要通过TSV进行垂直连接,Stack需要解决晶圆和Die的良率问题,同时还要处理热量、机械应力以及高速信号完整性。
完成堆叠以后,还需要通过Int
erp
oser等先进封装技术,把HBM Stack与GPU或AI Accelerator连接起来。因此,传统DDR和HBM的理解路径也开始出现明显区别。
传统DDR可以按照:
Memory Cell → Die → Chip → Rank → DIMM
来理解。
而HBM则需要继续往封装和系统方向延伸:
DRAM Die → TSV → Stack → Base Die → HBM Package → Interposer → GPU / AI Accelerator
这也是HBM真正重要的地方:内存不再只是插在主板上的一个独立模块,而开始成为计算芯片封装体系的一部分。
因此,研究HBM实际上已经不能只学习DRAM制造工艺,还必须理解
TSV、Stack、Base Die、Interposer以及先进封装
。
05|HBM4:从“更快”走向“更宽”
到了HBM4,HBM提升带宽的方式出现了一个非常重要的变化。HBM3和HBM3E采用1024-bit接口,而HBM4将接口规模进一步扩大到2048-bit。
可以简单理解成:
HBM3/3E:1024-bit I/O
-->
HBM4:2048-bit I/O
这意味着HBM继续提升带宽时,不再只是不断提高单Pin的数据速率,而是同时扩大数据通路。这背后反映的是一个很重要的工程规律:
当单个I/O继续提速越来越困难时,扩大并行通路同样可以获得带宽增长。
HBM4同时继续向更高容量、更高堆叠和更高能效发展。
截至2026年,Samsung、SK hynix和Micron都已经推进HBM4产品,其中Samsung已经宣布HBM4商业出货,HBM4正在从技术路线进入实际量产和客户导入阶段。
因此,HBM4并不是简单的“HBM3更快版本”,而是代表HBM开始进一步扩大接口规模,并加强与先进封装及AI加速器的系统级协同。
06|HBM4之后:真正困难的已经不只是速度
当HBM Stack越来越高、接口越来越宽以后,新的问题也越来越明显。如果只是不断提高速度和堆叠层数,功耗、散热、良率和成本都会随之增加。
因此,HBM未来的发展并不是简单地追求一个越来越高的“Gbps”数字,而是在几个指标之间寻找平衡:
带宽、容量、功耗、散热、良率、可靠性和成本。
这也是为什么HBM4以及后续HBM4E的发展越来越强调系统设计。
Base Die的功能不断增强,制造工艺也可能采用不同于传统DRAM Array的逻辑工艺;与此同时,更高层数的堆叠也推动产业继续研究更先进的互连和键合技术。需要注意的是,这些技术并不是在某一个HBM版本中突然全部完成,而是在不同厂商、不同产品和不同封装路线中逐步演进。
所以,理解HBM未来的发展,更适合关注技术方向,而不是简单地把某一个工艺节点或封装技术理解成所有HBM4产品的统一标准。
07|HBM为什么开始影响整个DRAM产业?
HBM的意义已经不再局限于一个高端内存产品。原因很简单:HBM需要消耗大量DRAM制造资源,同时还需要额外的堆叠、封装和测试能力。在部分制造环节上,HBM与传统DDR等DRAM产品存在共同的产能基础。当AI服务器对HBM的需求快速增加以后,DRAM厂商就需要重新配置晶圆和封装资源。
因此,HBM需求增长可能进一步影响传统DRAM产品的供应和价格周期。
这也是今天研究HBM时一个容易被忽略的地方:
HBM不仅是在创造一个新的市场,也在重新分配原有DRAM产业的资源。
从产业
角度
看,HBM的价值也与传统DRAM有所不同。
传统DRAM具有很强的规模化和标准化特征,而HBM涉及堆叠、封装、测试以及GPU/AI Accelerator适配,产品复杂度更高,也更依赖整个供应链协同。
因此,HBM正在推动DRAM产业从单纯的存储器制造,进一步走向
存储器制造 + 先进封装 + 系统协同
。
08|结语:从“内存模块”走向“计算系统的一部分”
回顾HBM十多年的发展,可以看到一条非常清晰的路线:
HBM → HBM2 → HBM2E → HBM3 → HBM3E → HBM4 → HBM4E
表面上看,这是一个个产品代号不断变化的过程,但如果把这些代号背后的技术变化串起来,会发现真正发生变化的并不是数字,而是
内存与计算芯片之间的关系
。
最开始,HBM解决的是高性能计算中的带宽问题;随后通过DRAM Die堆叠和TSV技术提高容量和带宽;到了HBM3和HBM3E,AI计算让HBM成为高性能AI加速器的重要组成部分;进入HBM4之后,接口进一步扩大,内存与先进封装、逻辑控制和计算芯片之间的关系也越来越紧密。
因此,HBM的发展可以浓缩成三个阶段:
从“内存模块”,到“靠近计算的内存”,再到“计算系统的一部分”。
DDR帮助我们理解的是:
Memory Cell → Die → Chip → Rank → DIMM → DDR5
而HBM则把这条路线继续延伸到:
DRAM Die → TSV → Stack → Base Die → HBM Package → Interposer → GPU / AI Accelerator
这也是理解今天AI硬件架构的一个重要入口。
因为在AI时代,计算芯片有多强固然重要,但
数据能不能以足够高的带宽、足够低的能耗,被及时送到计算单元附近,同样决定了整个系统能够发挥多少计算能力。
HBM真正改变的,正是这件事情。
【声明】内容源于网络
0
0
检芯外贸手札
1234
内容
243
粉丝
0
关注
在线咨询
检芯外贸手札
1234
总阅读
10.3k
粉丝
0
内容
243


 检芯外贸手札