大数跨境

企业部署Data Agent,必须建立的3道防线:权限、血缘、审计

企业部署Data Agent,必须建立的3道防线:权限、血缘、审计 商业智能研究
2026-10-20
8
导读:从数据稳定流转,到 AI 安全、准确、可追溯地使用数据,权限、血缘和审计是企业将 Data Agent 从试点应用推向生产环境的重要基础。
随着 Data Agent 逐渐应用于企业数据开发和管理,数据查询、任务监控和异常排查等工作开始由 AI 辅助完成。
过去,
开发人员需要逐个检查任务配置、运行日志和上下游依赖

现在,
只需提出“为什么昨天的数据没有同步成功?”,Agent 就能调用相关工具辅助定位问题。

但在生产环境中,真正的挑战不只是 AI 能否完成查询,还包括它能访问哪些数据、能否理解数据加工关系,以及执行过程是否可控。
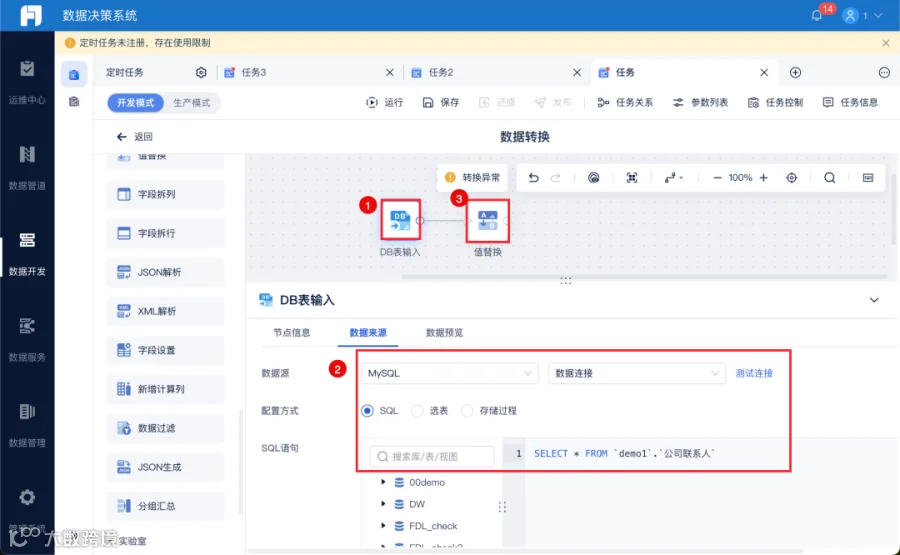
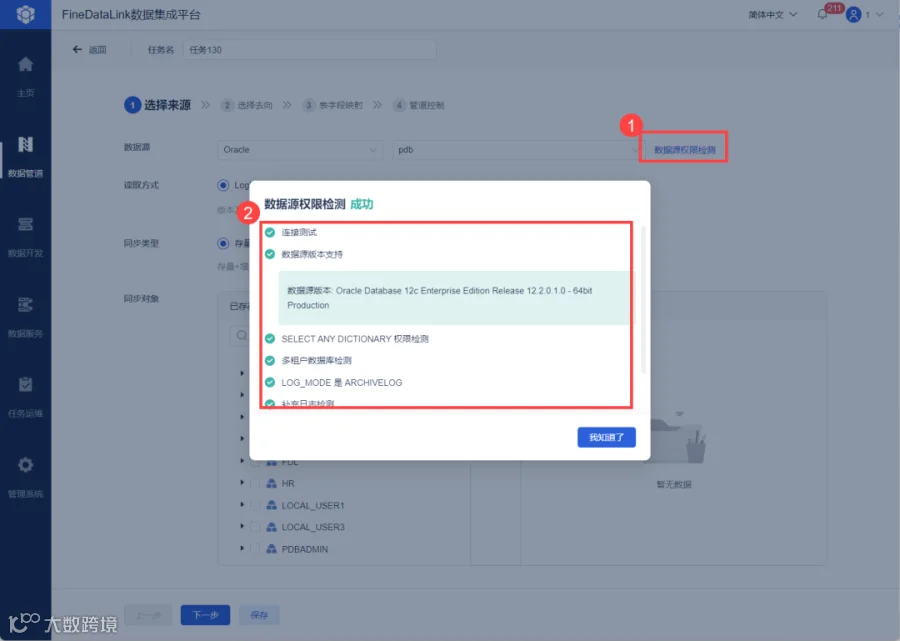
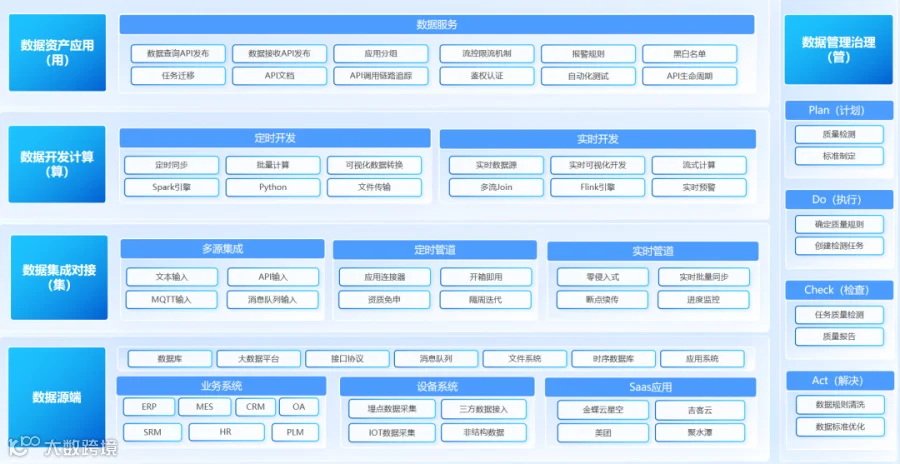
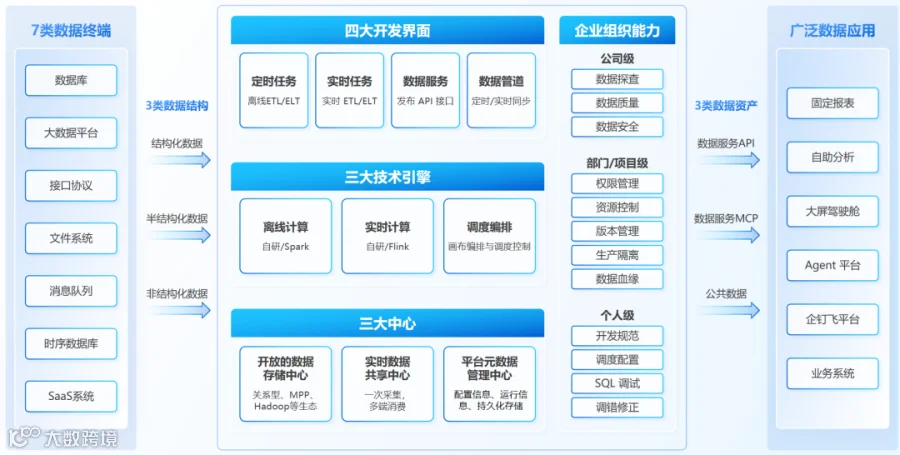
这些能力离不开稳定的数据集成体系。企业需要将 ERP、CRM、MES 等系统的数据统一接入,并规范管理同步任务、加工规则和上下游依赖。FineDataLink 可以承担多源数据接入、数据加工和任务调度等工作,为 Agent 查询数据、排查异常提供基础。
如果正在规划 Data Agent 或企业数据平台,可以参考这份《数据仓库建设解决方案》,了解从数据接入、加工到数仓建设的完整流程。
需要自取:
https://s.fanruan.com/xwgup

不过,数据接通不代表就能放心交给 AI 使用。企业还需要建立三道治理防线:权限管理控制访问范围,数据血缘确保来源与加工过程可追溯,操作审计记录关键执行行为。

一、第一道防线:权限管理,确保 Data Agent 不会越权访问


传统 BI 系统通常围绕用户和组织角色配置数据权限,而 Data Agent 不仅能够查询数据,还可能自主生成 SQL、调用 API、读取任务配置,甚至触发数据同步和加工任务。如果 Agent 使用具有全库访问权限的账号,就可能读取超出当前用户授权范围的数据。
因此,企业不能只给 Agent 配置一个数据库账号,而应根据用户身份、数据资源和操作类型建立分层授权机制。

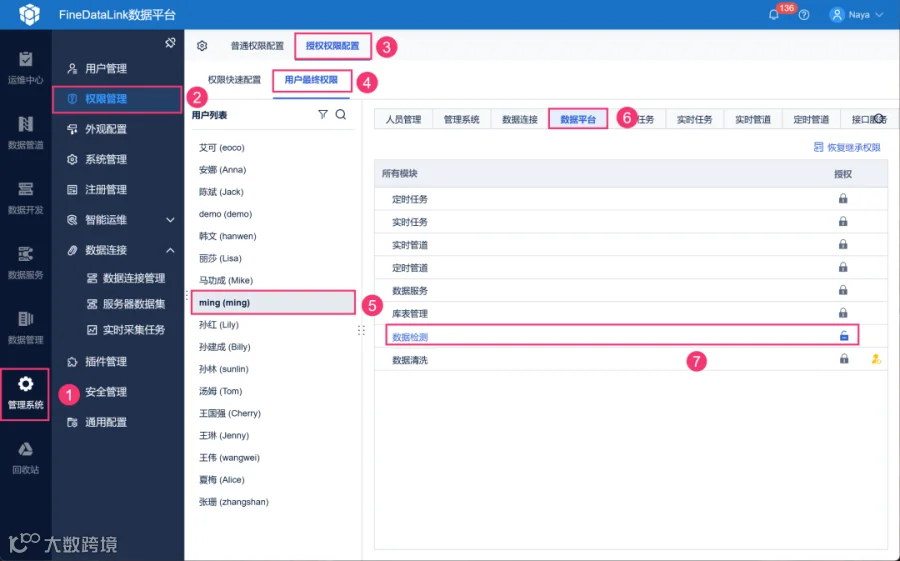
1. 权限控制需要覆盖数据、工具和执行操作

企业首先要明确 Agent 代表谁执行任务,以及它可以访问哪些数据、调用哪些工具、执行哪些操作。
  • 数据权限: 按组织、岗位、数据表和敏感字段划定访问范围。
  • 工具权限: 区分数据库查询、API 调用、任务监控等不同能力。
  • 操作权限: 区分只读查询、任务重试、配置修改和数据写入等操作,并针对高风险操作设置额外限制。
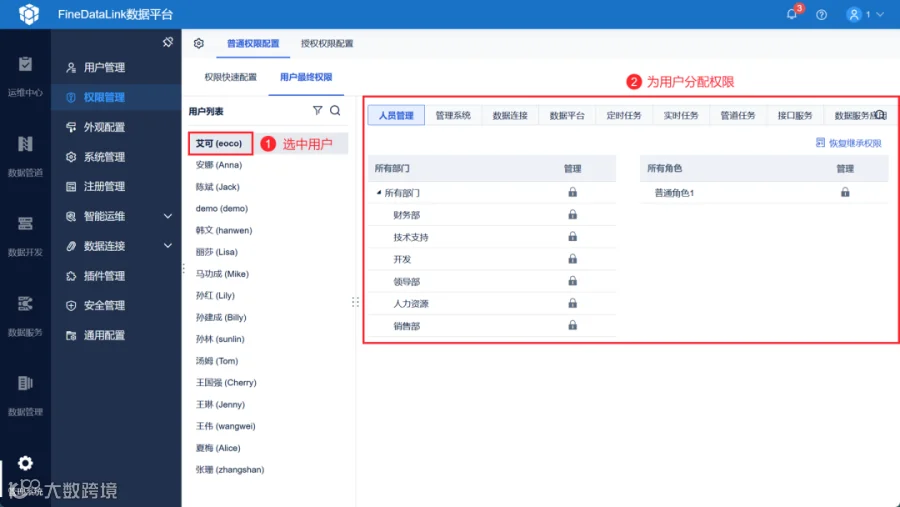
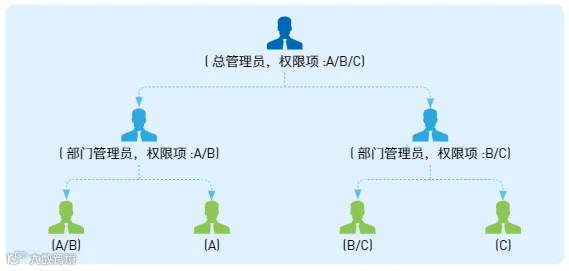
尤其需要注意权限继承。员工通过 Agent 查询数据时,实际访问范围不应超过该员工的授权范围,即使底层数据库账号拥有更高权限,也应在执行时进行身份校验和权限过滤。
对于修改同步规则、全量覆盖数据、批量删除记录等高风险操作,还应增加独立授权和人工确认机制。Agent 能调用某个工具,不代表当前用户就有权执行该工具的所有操作。

2. 将数据安全前置到数据处理环节

权限控制之外,企业还应减少原始敏感数据不必要的流转。
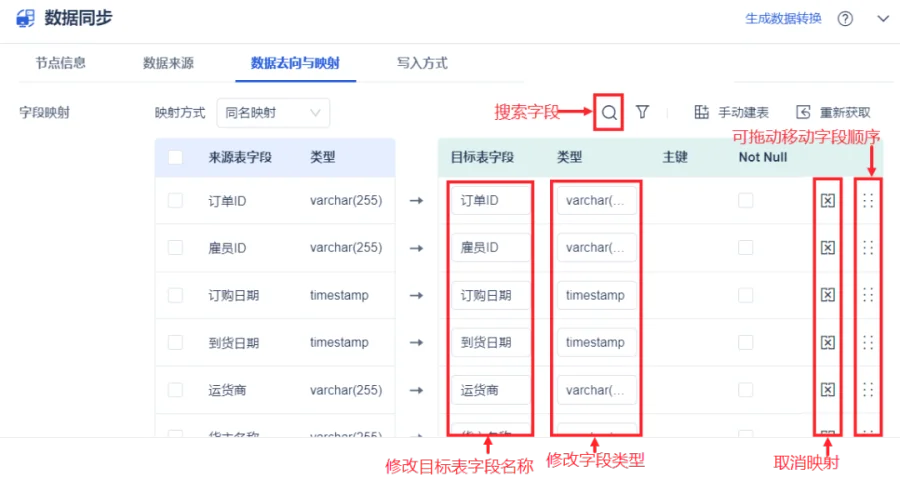
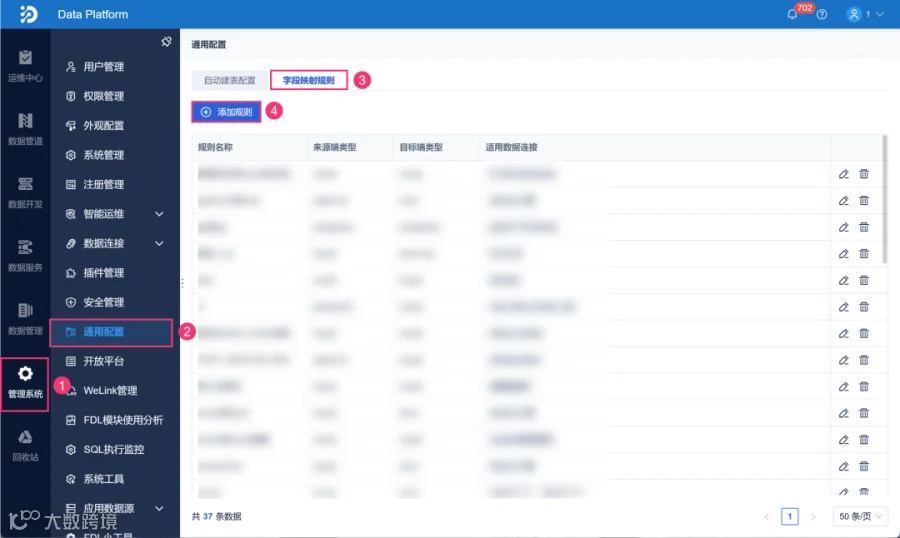
FineDataLink 可以在数据同步与加工过程中,对手机号、证件号码等敏感字段配置脱敏或转换规则,降低原始信息在不同系统之间传播的风险。对于需要跨系统匹配的业务标识,则应根据实际需求选择兼顾关联能力的处理方式。
同时,脱敏不能替代访问控制。企业可以优先将经过授权的数据服务接口开放给 Agent,并通过 MCP 等标准化工具接口提供查询和任务状态检查能力,在接口层统一控制参数、权限和返回范围,而不是直接向 Agent 开放大量生产数据库。
权限管理的核心,是让 Agent 在完成任务的同时,尽可能减少不必要的数据暴露和高风险操作。

二、第二道防线:数据血缘,确保数据来源清晰、过程可追溯


权限管理解决的是 Agent 能否访问数据,却不能保证它理解数据的来源和加工逻辑。
企业的数据通常需要经过
采集、同步、清洗、字段映射、去重、关联和汇总

等多个环节,才能进入数仓或数据服务。
如果 Agent 只知道目标表的位置,却不了解数据经历了哪些处理,就可能将正常的加工结果误判为同步异常。

1. 血缘管理需要覆盖完整加工链路

数据血缘用于记录数据来源、加工转换和下游使用之间的依赖关系。企业至少需要梳理三个方面:
  • 数据来源: 明确目标表对应的源系统、源表和字段,以及数据接入方式。
  • 加工关系: 记录字段映射、过滤、关联、去重和聚合等逻辑,以及任务之间的上下游依赖。
  • 影响范围: 当源端字段、加工规则或任务配置发生变化时,识别可能受影响的下游表、任务和数据服务。
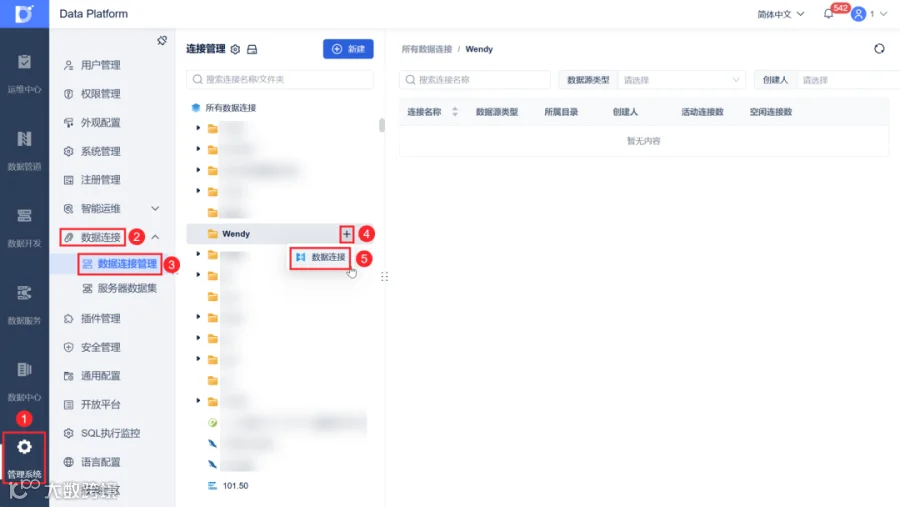
数据库 Schema 只能说明有哪些表和字段,血缘关系则进一步揭示数据如何形成,以及不同任务之间存在什么依赖。

2. 将血缘用于异常排查

假设某企业每天凌晨将 ERP 数据同步至数仓,早晨发现目标表能够正常查询,但部分最新记录没有更新。问题可能来自
源端数据延迟、增量字段配置错误、同步任务异常

也可能是上游加工节点使用了旧数据。
如果缺少血缘信息,开发人员只能逐个检查 SQL、任务配置和运行日志;如果能够从目标表向上追溯数据链路,就可以优先检查相关源表、同步任务和加工依赖,缩小排查范围。
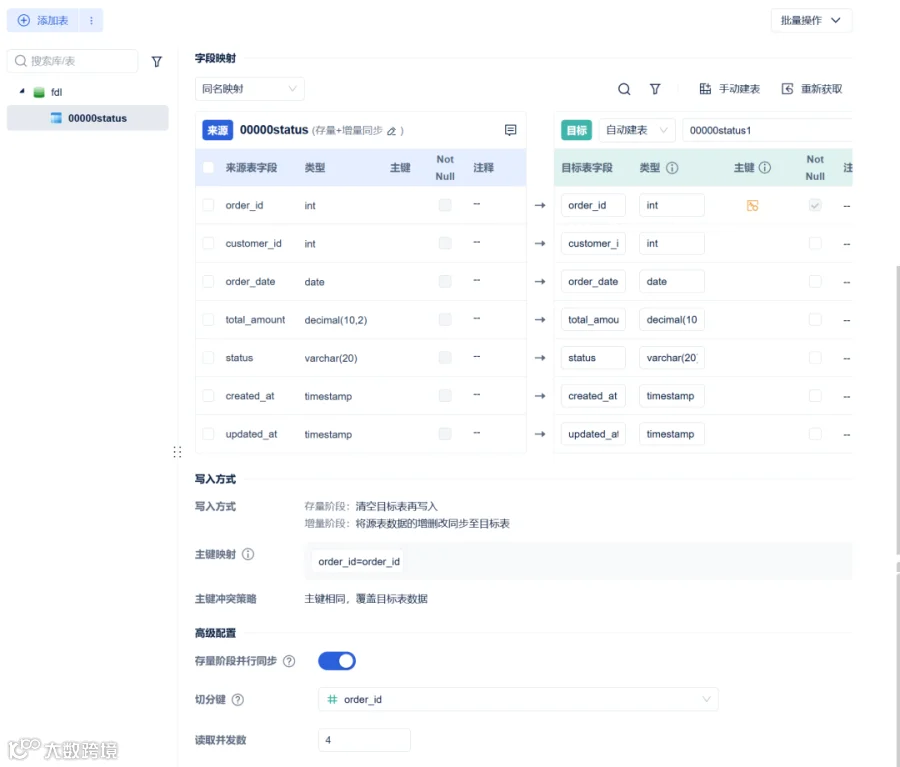
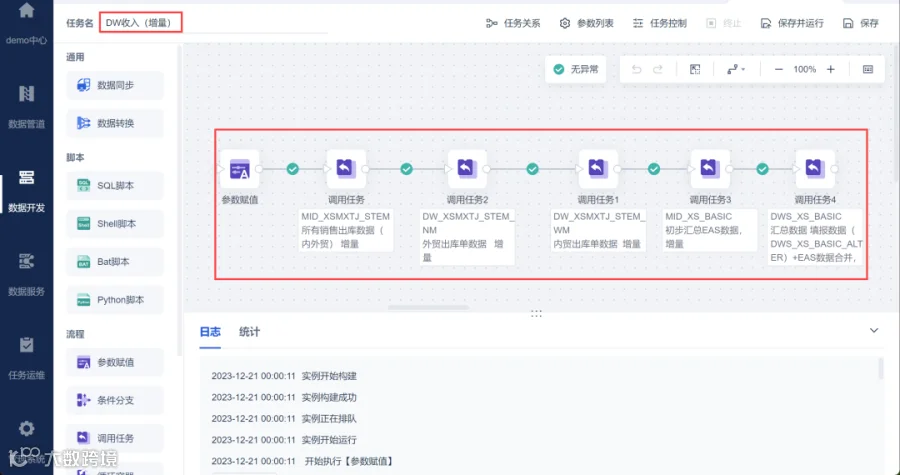
当目标表出现更新延迟或数据量异常时,排查人员需要逐步确认问题出在源数据、同步任务还是后续加工环节。借助 FineDataLink,企业可以结合数据同步、清洗转换和任务调度流程梳理上下游依赖,沿着数据链路检查任务运行状态、字段映射及加工规则,缩小异常排查范围,也为后续 Data Agent 理解数据流转关系、辅助定位问题提供基础。
进一步将相关血缘及元数据信息提供给 Agent,就能帮助它优先定位关联任务,而不是仅根据表名和执行结果推测原因。
需要强调的是,任务执行成功不代表数据一定正确,血缘完整也不代表不存在质量问题。
数据血缘解释数据如何形成,数据质量验证结果是否符合要求

两者结合才能为 Agent 提供更可靠的数据基础。

三、第三道防线:操作审计,确保执行过程有据可查


Data Agent 与传统数据开发工具的一个重要区别,是它可能根据用户指令连续完成多个操作,包括查询数据库、读取任务配置、检查运行日志,甚至触发任务重试。
如果最终结果出现错误,仅查看用户提问和 AI 回答,往往无法判断问题出在哪个环节。

例如,Agent 自动重试同步任务后,目标表出现重复记录。企业需要确认它是否选择了正确任务、是否检查了增量同步状态,以及是否考虑了目标表的写入方式。这些问题都需要依靠完整的操作记录进行复核。

1. 记录关键操作及执行上下文

企业应根据风险等级,记录 Agent 的关键执行行为,包括:
  • 身份与请求: 操作发起人、用户身份、请求时间及任务目标。
  • 工具调用: 调用了哪个数据库、API 或任务接口,使用了哪些关键参数。
  • 授权与审批: 是否通过权限校验,是否涉及人工确认。
  • 执行结果: 任务状态、错误信息、重试次数及关键配置变更。

其中,任务配置修改和数据写入尤其需要关注。修改增量同步起始位置,或将目标表写入方式由追加改为覆盖,都可能影响数据完整性。因此,企业还应保留必要的配置版本和变更记录,并对日志中的数据库凭据、访问令牌和敏感字段进行保护。

2. 关联 Agent 日志与数据任务日志

很多企业已经积累了大量数据集成日志,但这些记录通常只能说明任务何时执行、是否成功以及出现了什么错误。Agent 审计还需要回答:
是谁发起操作、Agent 为什么调用该工具,以及执行前是否经过授权。

因此,两类日志需要结合使用。
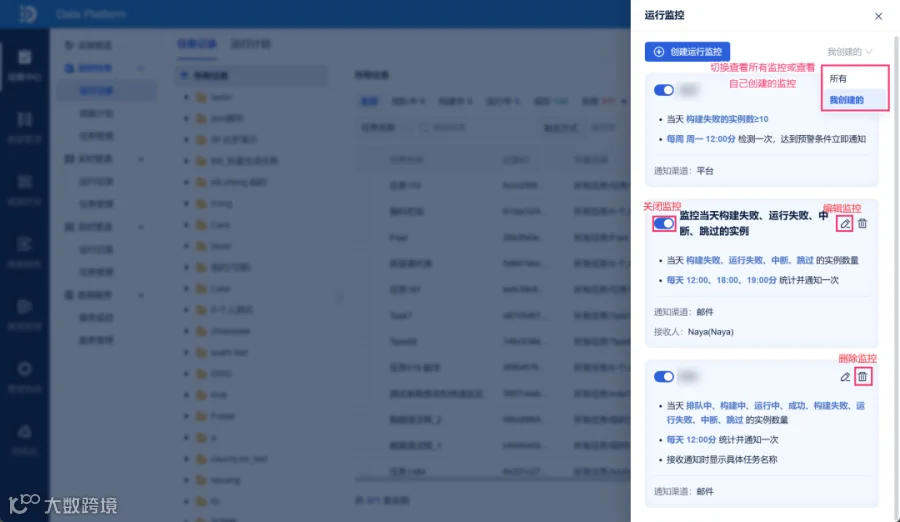
对于由 FineDataLink 管理的同步任务,数据人员可以通过任务运行监控和执行日志检查任务状态、异常信息及执行结果;再结合 Agent 的工具调用记录,确认它是否重复触发任务、使用了什么参数,以及是否遵守预设规则。
通过统一请求 ID、任务 ID 等标识关联 Agent 执行记录和数据集成日志,可以进一步判断问题来自源数据、同步配置,还是 AI 的操作决策。
需要注意,数据集成平台的运行日志不能替代完整的 Agent 审计。模型调用、身份权限、工具选择和高风险操作审批,仍需在 Agent 应用层建立相应机制。
审计的价值不只是保存日志,而是让每一次关键操作都能被复核、解释和追溯。

四、权限、血缘和审计如何协同?


三道防线分别作用于 Data Agent 的不同运行环节:
<span leaf="">&lt;!--br {mso-data-placement:same-cell;}--&gt; td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}</span>

治理能力
解决的问题
关键作用
权限管理
能访问什么、能执行什么
限制数据和操作范围
数据血缘
数据从哪里来、经过什么处理
追溯来源与加工依赖
操作审计
实际执行了什么、结果如何
支持复核与异常排查
以集团利润分析为例,Agent 首先
根据用户身份确定可访问的组织范围,避免查询超出授权的财务数据;

随后
结合指标定义、数据血缘和元数据信息,识别利润数据来自哪些系统、采用什么计算口径,以及是否存在更新延迟;

完成分析后,
还要保留必要的查询记录和工具调用信息,便于财务人员复核异常结论。

实际建设时,企业不必推翻现有架构重新搭建数据体系。对于已经具备数据集成、数仓和 BI 平台的企业,更可行的方式是整合已有的数据管理能力,并在 Agent 的访问接口和工具调用层补充必要的控制机制。
例如,利用现有平台管理核心指标和加工链路,在查询前校验用户权限,在分析过程中提供必要的数据口径信息,再通过统一任务标识关联查询、工具调用和执行日志。
对于具有自主修改数据或触发业务流程能力的 Agent,还应增加人工审批、风险分级和执行隔离等措施。

五、企业落地 Data Agent,应该从哪里开始?


企业不宜一开始就向 Agent 开放所有业务系统和数据资源。更稳妥的做法是从数据基础成熟、业务边界清晰的场景入手,先验证治理机制,再逐步扩大应用范围。

第一阶段:明确业务场景与授权范围

先确定 Agent 要解决的具体问题,例如
收入趋势分析、成本费用分析或应收账款风险识别

再梳理所需的
数据表、字段、使用人员和授权范围

不同场景的数据敏感程度不同,应采用相应的访问限制,并优先通过只读查询、最小权限等方式开展试点。

第二阶段:建立稳定的数据处理链路

Agent 的分析质量取决于数据的完整性、一致性和时效性。已有数仓和 BI 平台的企业,可以从现有流程入手,不必重新建设整套数据体系。
而已经在使用 FineDataLink 的企业,可以进一步梳理核心业务指标涉及的数据源、加工规则和上下游任务,并结合数据质量校验,重点确认三个问题:指标口径是否统一、数据更新是否及时、发生异常时能否追溯上游原因。
只有这些基础问题得到解决,Agent 才能减少因数据缺失、口径不一致而产生的错误分析。

第三阶段:建立审计与持续优化机制

在完成数据授权和链路治理后,可以逐步开放部分低风险任务执行能力。例如,Agent 发现同步任务因临时网络故障失败,在满足预设重试条件并通过权限校验后,可以调用任务接口重试;涉及增量字段调整、目标表覆盖和同步规则修改等操作,则应经过人工确认。
企业还应建立
风险分级、执行审批、任务审计和异常恢复机制

并通过
数据库连接失败、字段类型变化、增量同步遗漏、主键冲突等测试场景

持续验证 Agent 的问题识别和处理能力。
相比一开始就让 Agent 自动完成所有数据开发工作,先在高频、低风险场景中建立可复用的权限规则、血缘信息和审计流程,更有利于后续推广。

写在最后


Data Agent 正在改变企业的数据使用方式,但并没有降低数据集成与数据治理的重要性。随着 AI 开始参与数据查询、任务诊断和工具调用,企业除了确保数据稳定接入,还需要明确 AI 的访问范围、数据处理依据和操作责任。
权限管理确保 Agent 在授权范围内访问数据和执行任务;
数据血缘帮助追溯数据来源、加工逻辑及上下游依赖;
操作审计则为执行复核和异常排查提供依据。

对于已经建设数据集成平台的企业,重点不是为 AI 重新搭建一套数据处理体系,而是在现有架构上补齐面向 Agent 的治理能力。
从数据稳定流转,到 AI 安全、准确、可追溯地使用数据,权限、血缘和审计是企业将 Data Agent 从试点应用推向生产环境的重要基础。


点击【阅读原文】,体验文中同款资料包


【声明】内容源于网络
0
0
商业智能研究
帆软旗下机构「帆软数据应用研究院」 专注于企业数据化应用、大数据BI技术和理论观点研究,向业界输出前沿的研究与洞察,帮助企业把握商业智能趋势,提升管理与商业战略认知,让数据成为生产力。
内容 1149
粉丝 0
商业智能研究 帆软旗下机构「帆软数据应用研究院」 专注于企业数据化应用、大数据BI技术和理论观点研究,向业界输出前沿的研究与洞察,帮助企业把握商业智能趋势,提升管理与商业战略认知,让数据成为生产力。
总阅读19.7k
粉丝0
内容1.1k