9月17日上午,在深圳SEO大会Main Conference的第二天上午,来自头部GEO工具Profound的AI策略负责人Josh Blyska做了一个 《The New Citation Economy: How ChatGPT, Google AI Mode, and Claude Pick Sources》主题的分享,是几天议程下来给我留下印象最深的presentation。

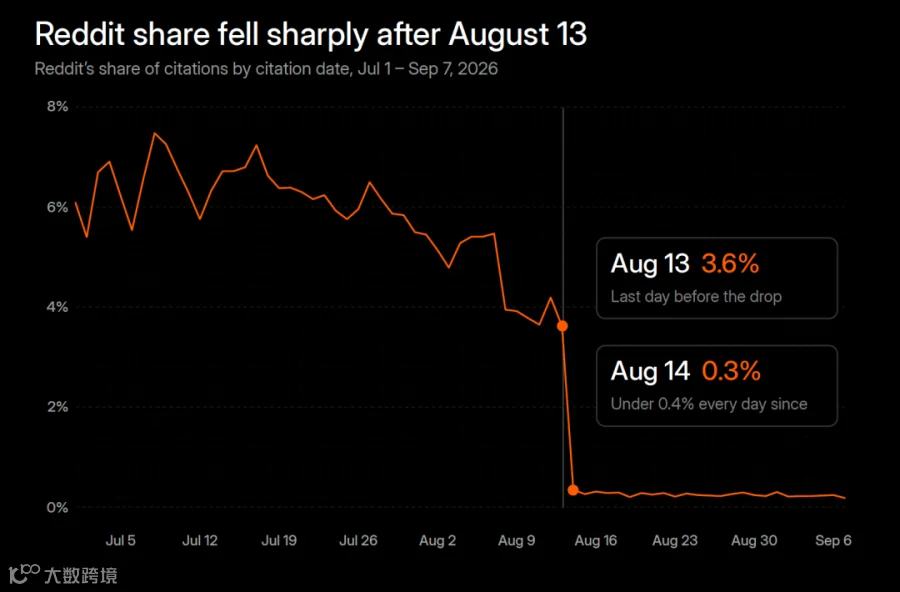
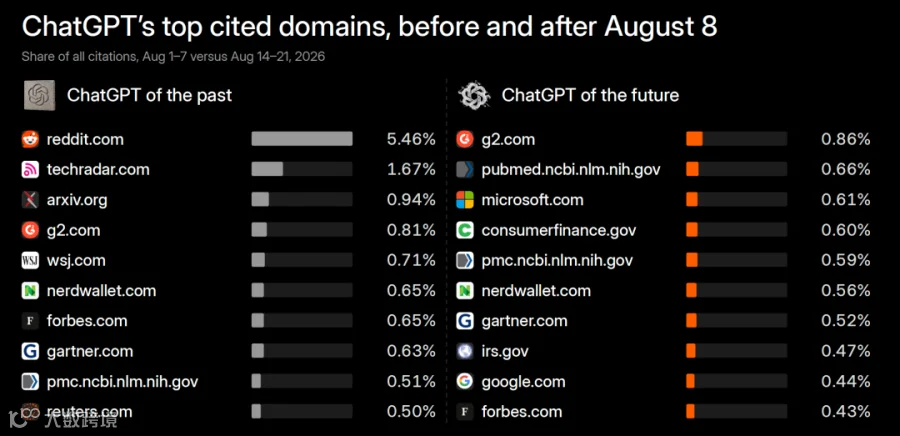
其中他用大量篇幅重点讲述了ChatGPT引用来源的一次结构性变化——ChatGPT回答中来自Reddit的引用率占比从平均6%左右跌至0.3%,足足降低了95%。这个结构性变动已经被很多业内人士发现、转载、讨论,相信大家都已经意识到了变化,也无疑给整个GEO市场引来了轩然大波。
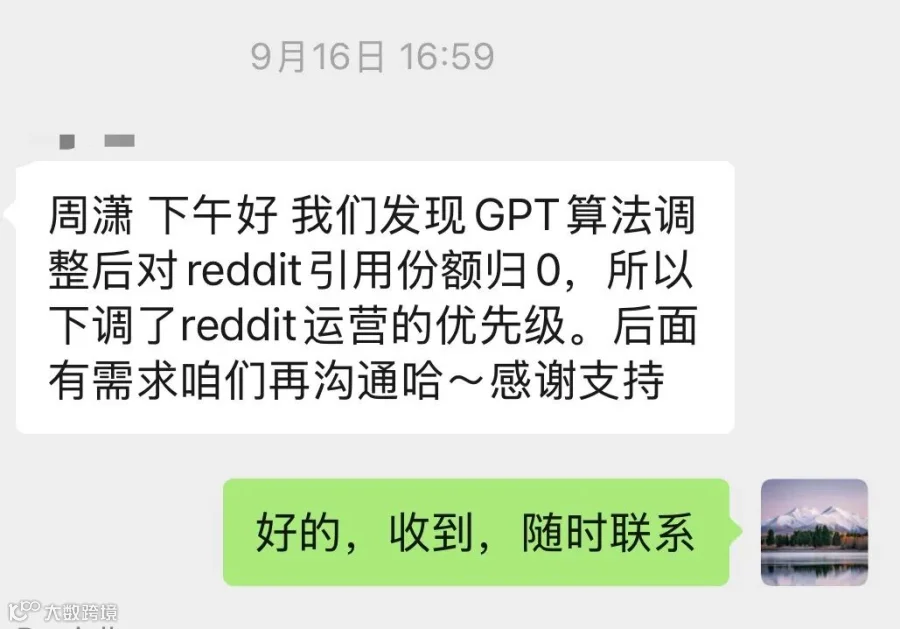
很多客户问我,现在Reddit是不是做不了GEO了?甚至一个客户直接私信我,喊停了已经达成初步意向的合作。
有同行一起讨论,是否有必要再继续投入精力到Reddit GEO中?不如转而投向外链、PR?
团队同学也忍不住开始发问,是不是咱们要考虑“调整”赛道了... ...
但是最近两个客户的Reddit GEO营销效果报告一出来,我心里的一块大石头反而落地了。
数据层面,两个客户订单周期(Campaign 启动时间均晚于8月中旬):
Visibility平均提升 12%
Position平均提升 0.5%
SOV平均提升 3%
Sentiment分数平均提升 1
那么这其中的矛盾点到底在哪?不是说Reddit已经被ChatGPT“抛弃了”吗?为什么Reddit营销对GEO还是会有明显帮助?
一、8月初开始,ChatGPT 到底调整了什么?
Josh 团队(Profound)采样了 326 万条 ChatGPT 前端引用数据和100多万条模型反馈,分享了关于GEO的最新洞察。
这次变动最刺眼的两个数字:
8 月 13 日,Reddit 占引用的比例 3.6%。8 月 14 日,0.3%。此后每天都在 0.4% 以下,跌幅 95%。
Reddit 进入safe-URL(白名单) 的频次,平均每千次响应掉了 96%。按引用份额排,8 月第一周 Reddit 是第一,8 月第三周跌出前十。
同期的结构变化:
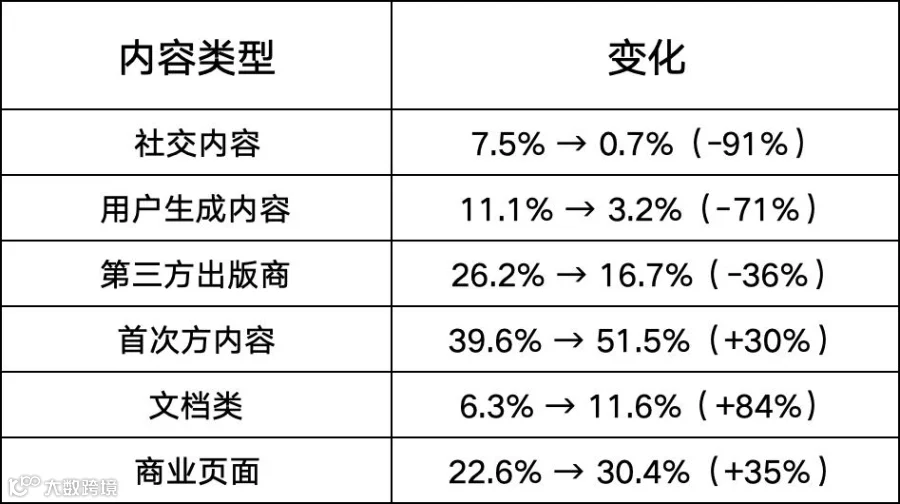
从上面的表格可以快速总结出:这次调整的核心是提高了权威/高质量引用源的占比,降低了UGC/低质量内容的引用比例。
然而,Reddit确实是一个特殊的平台,因为有海量的内容,所以是少数既能做到高质量,又同时掺杂着大量低质量内容的一个平台。
根据Josh的总结,Reddit的引用率大幅降低与站点被判为垃圾源无关,虽然它相当大一部分内容被挡在了搜索结果门外,但不等于平台直接被判定为低质,也不等于Reddit GEO宣告死亡。
二、那 Reddit 引用到底是被谁挡的
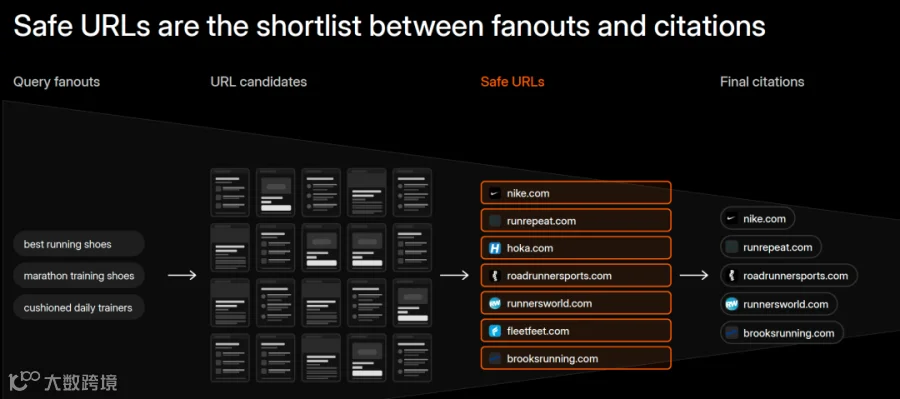
Josh提到,最新更新的ChatGPT算法完成一整个回答的步骤如下:
用户prompt输入
fanout第一轮
初步处理,优化结果
fanout第二轮
hone打磨出高质量结果
筛选出safe urls候选
结果中被最终引用
8月前后对比:
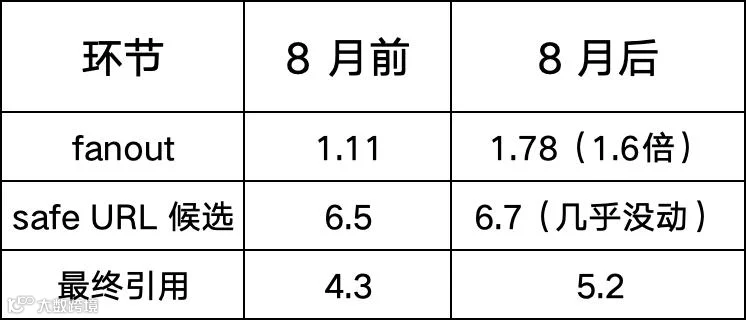
可以清晰地看出,safe URL候选没变,但是引用位变多了。
再看一条 Josh 的数据:99.86% fanout结果会被纳入到 safe URL 集合中,然后 76.91% 的safe URL最终会被ChatGPT引用。
所以漏斗出口没变小,入口还放宽了。
第二轮 fanout 做的事,Josh 叫它 hone(打磨)——拿着第一轮候选再去追问一层,比如"这个数字到底是多少""有什么限制"“数据层面的优势到底是什么”,然后剔掉答不上来的网站源头。
所以,真正被踢掉的不是Reddit ,而是原来大部分Reddit引用中的流水对话和低质量内容,这些流水对话随着fan out 和 hone 到第5步的时候被过滤掉了。
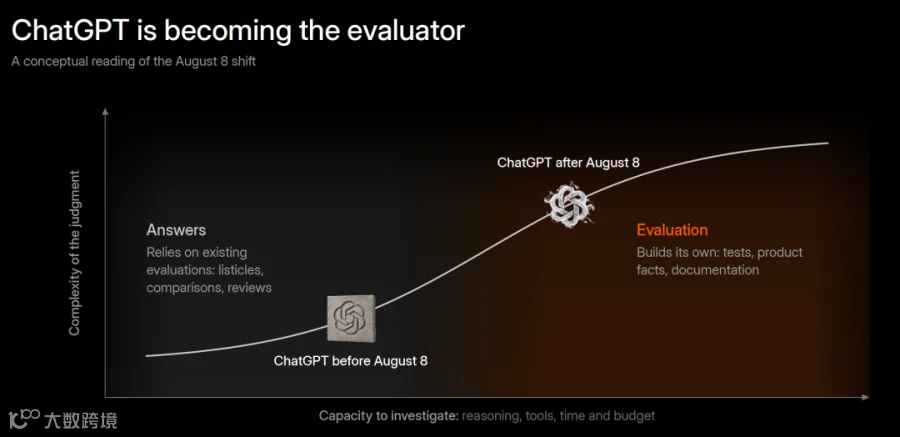
这就是Reddit结果在ChatGPT的回答引用下降了95%的真正原因。
三、同一时期内,HiBrand的Reddit GEO数据表现
接下来分享实打实的数据:
8月中旬以来HiBrand团队累计交付了106条高质量Reddit Post和评论串(特指GEO方向,不含品牌种草贴和热点追踪帖),累计有33条被大模型引用,引用率高达31.1%。
其中被ChatGPT引用15条,相当于每7条我们产出的Reddit内容就有一条已经在ChatGPT的引荐结果当中。
正因如此,才有引言中的数据提升——
Visibility平均提升 12%
Position平均提升 0.5%
SOV平均提升 3%
Sentiment分数平均提升 1
此外,随着时间推移,这批Reddit内容会有持续的长尾效应,会有更多的原贴被LLMs cite或者被其他高质量文章引用,整体GEO表现会越来越好。
四、为什么HiBrand的Reddit GEO效果仍然坚挺?
这个相反的数据并不是证明我们超越了平台规则,也不是单独案例,更不是为了证明了谁的数据是错误的。
是因为我们和Josh的分母不一样——他的数据分母是全部Reddit内容;我们的分母是所有精心创作出的精选内容,是有数据、有对比、有分析的高质量Reddit Post和评论串。这些内容恰恰并没有被 8 月初的更新所波及。
所以,不是Reddit被LLMs引擎抛弃了,是Reddit抛弃了除了真实用户的经验以外的其他东西。
我用三个月的时间分别订阅了3款工具的高级会员,他们记录我的运动数据和变化曲线分别如下,XX是数据最全的,但是最贵,XX相比之下缺少XX数据,但是性价比更高。
我拿这个工具跑了 300 个零件,失败率大概在 X%,遇到这种具体情况要退回去重做,这种情况一共出现了多少次。
以上这些详实的内容和用户一手数据,模型自己造不出来,官方文档也不会写,大多数用户的评价中也不会包含。往往这种数据才是LLMs最喜欢的,恰恰也是HiBrand Reddit GEO高质量贴会覆盖的内容。
五、什么样的 Reddit 内容会被引用
引擎在找的是"已经替读者做过判断、新的、带具体信息的"内容。
高质量 Reddit 内容的五条判据
1. 信息颗粒度要到参数级
"这个工具很好用。" 这种评论进不了第二轮追问。
"这个帐篷三人版标称 1.9kg,实测 2.3kg,差 400g。多出来的是杆子和袋子的重量。防水指数 3000mm 只覆盖面料,接缝处实测淋10 分钟就渗。" 这种评论可以能进最终的索引。
判断方法很简单:这句话能不能被单独摘出来当答案用? 不能,就是不够。
2. 要有对比和取舍
Claude 引用对比类内容占 12%,ChatGPT 也把 comparisons 算进评估型。
Reddit 上天然有对比结构——A vs B、哪个更适合什么场景。我们投放时可以把"用户在什么场景下选了什么、代价是什么"写清楚,这种内容天然贴合引擎偏好。
3. 必须是第一手使用,不是转述评测
用户跑出来的数字和用户转述别人的评测,在模型眼里的权重完全不一样。前者模型自己验证不了,后者网上一堆。这也正是 Reddit 相对官方文档不可替代的地方。
4. 要说清楚适用边界
“跑步机标 12km/h,实测最快 11.2km/h。跑带宽度 51cm,摆动幅度 ±3cm。120kg 以上体重会明显晃。”
边界信息是模型最需要、自己最难获得的东西。 这也是 Josh 建议品牌方做 teardown mindset 原创内容的原因——把限制也写清楚,比只讲优点有用得多。
5. 时效要新
50% 的被引页面是 13 周内更新的。Reddit 帖子的天然优势就是新鲜,持续稳定的输出高质量内容,最终总会有结果。
写在最后
2026 年做 GEO,能进 AI 答案的已经不看帖子数量了,看帖子里的信息密度。
对 Reddit 这个平台来说,这个变化更直接——以前铺量就能出效果,现在得每条都有东西。
对还在犹豫要不要继续投入的朋友,我的建议是先看一眼自己的In house团队或者外部服务商产出的内容有多少是符合五个判断依据的,有多少内容是能被单独摘出来当答案用的。这个比例决定了你的GEO投入转化的是资产还是低质量信息“库存”。
参考:Profound《The New Citation Economy》,Josh Blyskal,2026 年 9 月 17 日深圳 SEO 大会。
觉得有用的话,欢迎点赞、在看、转发。
我们长期帮品牌做 Reddit GEO 和 AI 搜索优化,深入跟进品牌GEO现状,产品分析,专注产出高质量Reddit内容。
HiBrand累计服务出海品牌营销近百家,服务范围包括:
Reddit GEO/种草+高质量外链建设+社媒营销+小语种本地化营销
感兴趣欢迎私聊或者评论区留言,想了解Josh的PPT原稿也可以私我。
微信 tevezchou
网站入口 👉 hibrand.io