

导读让数字分身用你的声音聊天,需要把声音生成、问题理解和应用系统接起来。音色克隆负责说得像你,大模型负责组织回答,后端负责连接资料与连续交互。从配音到语音聊天,再到音频直接输入多模态模型,本文逐层讲清各项能力、两条技术路线,以及初学者该怎样看模型和判断效果。
本文 3144 字,阅读约 8 分钟
克隆声音,先解决用谁的声音读稿
让分身回答,得把问题交给大模型
后端把模型连接成一次次真实对话
直接听声音的模型,也要分别看它能否开口
两条路线如何选择
把模型放回具体环节,再看大小、效果和热度
先做一个范围清楚的小分身
克隆声音,先解决用谁的声音读稿
假设你录了一段自我介绍,再输入一篇从没念过的稿子,模型生成了一段听起来接近你的配音。这就是音色克隆:利用参考录音中的声音特征,合成新的话语。
它建立在语音合成,也就是 TTS 的能力上。TTS 接收文字,生成可播放的声音;音色克隆进一步提供“用谁的声音说”的条件。录音可以交给云端服务,也可以由本地模型读取。
以 Gemini 3.8 Flash TTS 为例,它支持预设音色、按文字描述设计声音,以及参考录音的声音复刻。复刻流程还需要同一说话人的授权录音。因此,“用我的声音读”“选一个现成声音”“创造温柔低沉的男声”,对应三种不同需求。
同样,“听起来像我”和“讲得自然”也需要分开判断。音色相似度衡量生成声音与参考说话人的接近程度;评测里 0.8 这样的分数,不表示八成人觉得像,也不能证明停顿、重音和情绪自然。
这一步已经能做声音替身,却还没有决定它遇到问题该回答什么。
让分身回答,得把问题交给大模型
把目标往前推一步:别人问你的分身“这周末有什么安排”,希望它现场回答,而不是播放提前录好的内容。
一种常见做法,是把识别、回答和发声串起来,叫作级联语音系统。沿着这个示意问题看:
1. 语音识别 ASR 接收录音,转写出“这周末有什么安排”。有些文档也叫它 STT。
2. 大语言模型 LLM 收到问题和对话上下文,结合系统提供的日程资料,组织回答文字。
3. 语音合成 TTS 收到回答文字,用选定的音色生成声音;支持克隆时,可以用接近你的声音说出来。
它必须先有日程资料或查询入口,才能可靠回答你的安排。仅凭一段声音样本,无法知道你周末做什么,更不会自动获得你的记忆和性格。
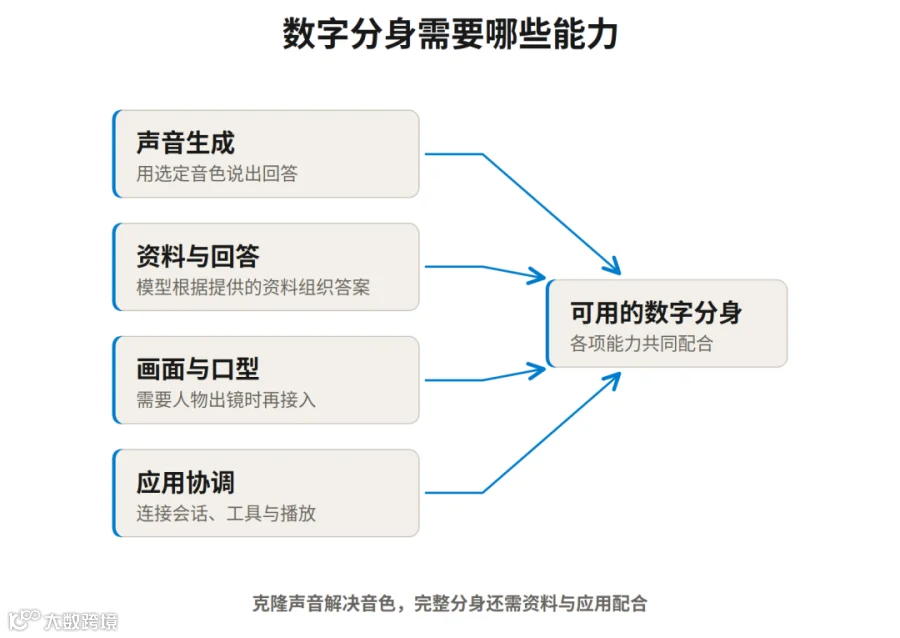
如果还想让屏幕里的“你”同步开口,需要再接人物画面与口型驱动,让嘴部动作跟语音对应。声音、知识和形象分别构成分身的一部分,不能靠一个克隆按钮全部完成。
后端把模型连接成一次次真实对话
识别、回答和发声接通,只说明问答有了基本路径。应用还要收音、传输、保存当前会话,并把回答播放给用户。这些通常由应用和后端服务协调。
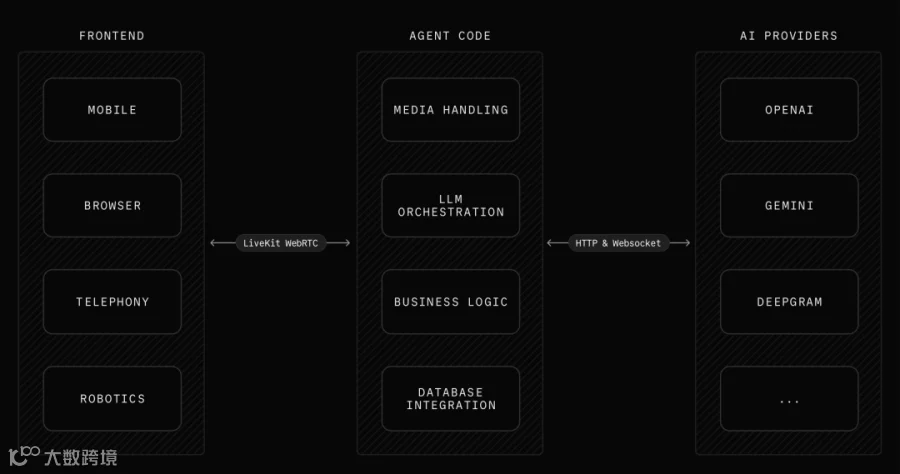 左侧是用户设备,中间是处理媒体、组织模型调用和业务逻辑的程序,右侧是模型服务;这是 LiveKit 展示的一种系统组织方式 | 来源:LiveKit Agents 官方文档
继续看周末安排的例子:后端取得日程查询结果,交给模型作为回答依据;你接着问“那改到下午呢”,系统还要保留前一句的指代。涉及真正修改日程时,还得调用相应工具,而不是只生成“已修改”这句话。
这些操作可以由程序按固定流程安排,也可以让模型根据目标和工具结果决定下一步;后者属于 Agent(智能体)的做法。支撑模型调用工具、接收结果并继续执行的运行框架,常被称为 harness。后端还负责连接数据与保存会话等工作,不能把整个后端都叫作 Agent。
聊天是否顺畅也涉及系统协作。流式输出允许边生成边播放;轮次判断决定你何时说完;打断处理则要在你插话时停止旧回答,并处理尚未播放的声音。它们是不同能力。
微软的 VibeVoice-Realtime-0.5B 就支持接收流式文字:LLM 不必写完整段回答,TTS 可以先把已经生成的部分说出来。官方报告约 300ms 的首段语音延迟,但它依赖硬件,也不包含识别问题、组织回答等整轮耗时。该模型以英语为主,其他语言仍需验证。
LiveKit 这类语音应用框架,就把媒体传输、模型调用、轮次判断和打断处理放进系统层。部署时,这些组件可以在本机或云端运行,“需要后端逻辑”不代表必须另租一台远程服务器。
直接听声音的模型,也要分别看它能否开口
级联系统将转写文字交给 LLM,通常能保留说话内容,但语气、笑声和环境声未必进入这份文字。
比如同一句“你可真厉害啊”,既可以是赞赏,也可以带着讽刺。只看到文字,模型主要依赖上下文判断;能处理音频的模型,则有机会结合重音、音高变化和笑声。这个例子用于解释信息差别,不代表模型总能听准真实意图。
这就引出另一条路线:把音频直接交给支持声音输入的多模态大语言模型,也就是 MLLM。它通过音频编码等环节,把声音转换成网络可处理的表示,再结合问题和上下文回答。这里的“直接”指应用不用先把录音转写成文字再交给模型,不代表模型内部没有声音处理步骤。
以 Gemini 为例,3.8 Flash 能分析录音并返回文字;3.8 Live 能接收实时音频,理解问题并生成语音回答。Live 可以设置预设音色:你说“周末有什么安排”,它结合可用的日程资料组织回答,再用所选声音说出来。选一个现成音色,与上传录音克隆你的声音,是不同的功能。
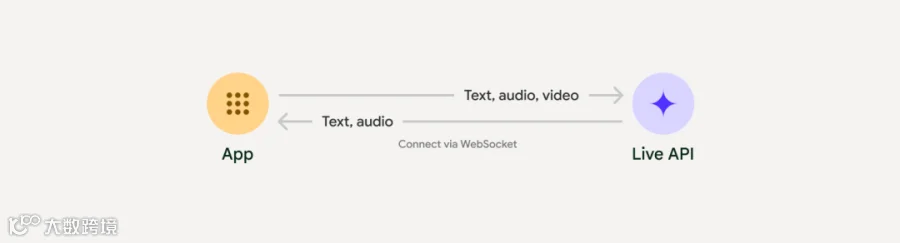 上方是应用向 Live API 发送文字、音频或视频,下方是返回内容;这是接口交互概览,不是模型内部结构图,具体输出方式还要看所选型号 | 来源:Google Gemini Live API 官方文档
音频输入、语音输出和克隆你的声音,是三项需要分别检查的能力。对照三个型号,就能看清“分析录音”“语音聊天”和“照稿配音”的分工:
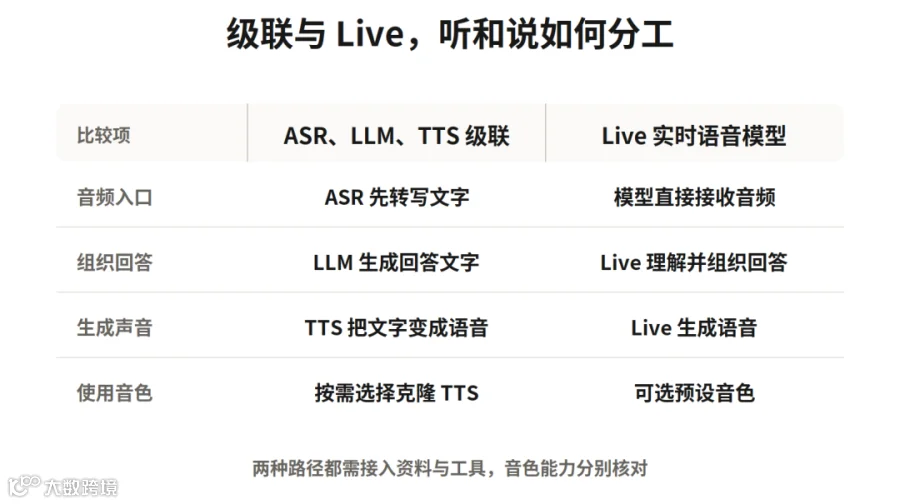
这两条路线也能组合:先让 Flash 理解录音、结合资料生成回答文字,再交给 Flash TTS 用选定音色读出来。这保留了音频输入,又把发声交给独立的合成服务。Live 的预设音色已经能用于聊天;若要求“用我的声音”,还要单独确认其接口是否支持声音复刻,不能直接套用 TTS 的能力。
无论选择哪一种,查询日程仍需要接入日程数据,修改安排仍需要工具执行。实时语音模型承接了更多听、答、说的工作,应用仍要协调资料、工具和播放。
两条路线如何选择
客服、陪练、语音助手和数字分身,都可能使用这两条路线。选择时先看:任务主要依赖说话内容,还是需要分析声音本身?再看回答和音色需要怎样控制。
这是一份试用顺序,不是能力排名。级联也能流式接话、处理打断;音频输入也不自动保证情绪判断或纠音准确。单凭“端到端”这个标签,无法判断哪种更聪明、更便宜或更快。级联系统还可以加入声音分析组件,把结果和文字一起交给 LLM。
对想做数字分身的初学者,我建议先用级联方案完成“根据指定资料回答,再用我的音色说出来”。这样可以分别检查识别对不对、回答有没有依据、声音像不像。若最在意自然聊天,可以先试 Live 的预设音色,确认体验后,再评估克隆音色如何接入。
把模型放回具体环节,再看大小、效果和热度
选模型时,可以先区分需要的是语音生成、多任务音频处理,还是理解与对话:
如果要清理一段嘈杂录音,应该检查降噪;要修改录音里说错的词,应该检查内容编辑;多人同时说话时提取目标声音,则涉及分离。多任务模型是否合适,要看对应任务的结果。
参数少,也不直接等于整套系统显存低。AuK 公布的生成模型约 1.5B 参数,官方部署还涉及编码器和 VAE,即把声音与内部表示相互转换的模块。判断电脑能否跑,要看完整实现、精度、输入长度及是否把部分计算转到 CPU。
也有面向 CPU 的轻量方案。MOSS-TTS-Nano 公布的模型规模约 0.1B,其 ONNX 推理方案保留了音色克隆流程;官方报告在 MacBook Air M4 单核上运行顺畅。这提供了本地尝试的入口,实际速度仍要在自己的设备上测,不能推广成任意旧电脑都能实时合成。
效果则应分项看:错字率反映内容准确性,相似度关注说话人特征,自然度还涉及节奏与表达。一张克隆相似度表,无法回答哪个模型最适合讲故事或实时聊天。
星标和下载量可以帮助了解项目关注度,但累计时间、多个版本是否共用仓库、自动下载请求都会影响数字。它们不等于音质评分,也不能替代自己的任务测试。
先做一个范围清楚的小分身
对初学者,我更建议先完成“用我的声音读一段稿子”,再增加“回答指定资料里的问题”,最后接入实时聊天和人物画面。每次只增加一类能力,更容易知道问题出在哪。
第一步用同一份中文稿检查人名、多音字、日期、金额和中英混读,再听几分钟里有没有漏字、重复和音色漂移。第二步检查回答有没有资料依据,资料缺失时是否如实说明。第三步再测从说完到听见回答的等待,以及插话后旧声音能否及时停下。
能否用你的声音读稿,能否根据你的资料回答,能否与你自然对话,都可以分别验收。把这几件事一项项接好,数字分身才会从一段像你的录音,变成一个可以实际使用的应用。
参考资料
•LiveKit Agents:应用结构、媒体处理与会话协调: https://docs.livekit.io/agents/
•LiveKit 语音流水线:级联、实时与混合路线: https://docs.livekit.io/agents/models/pipelines/
•CosyVoice:语言、方言、克隆与流式合成: https://github.com/QwenAudio/CosyVoice
•Kokoro-82M:轻量语音合成说明: https://huggingface.co/hexgrad/Kokoro-82M
•AuK:多任务能力与完整部署组成: https://github.com/Tencent-Hunyuan/AuK
•VibeVoice-Realtime-0.5B:流式文字输入、首段语音延迟及语言边界: https://huggingface.co/microsoft/VibeVoice-Realtime-0.5B
•MOSS-TTS-Nano:模型规模、克隆与 ONNX CPU 推理: https://github.com/OpenMOSS/MOSS-TTS-Nano
•Anthropic:固定工作流与智能体的区别: https://www.anthropic.com/engineering/building-effective-agents
•Anthropic:harness 的调用循环、工具路由与上下文职责: https://www.anthropic.com/engineering/managed-agents
•Gemini 3.8 Flash:支持音频输入,输出文字,不支持音频生成: https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash
•Gemini 3.8 Live:实时音频输入与语音输出: https://ai.google.dev/gemini-api/docs/models/gemini-3.8-live
•Gemini Live API:应用与模型接口的交互概览: https://ai.google.dev/gemini-api/docs/live-api
•Gemini Live 能力指南:预设音色、音频转写与打断处理: https://ai.google.dev/gemini-api/docs/live-api/capabilities
•Gemini 3.8 Flash TTS:文字转语音与声音功能: https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash-tts
•Gemini Voice replication:参考录音、授权录音与复刻音色的使用: https://ai.google.dev/gemini-api/docs/voice-replication
文章仅做学术分享,如有侵权请联系删除,非常感谢!